
BÀI VIẾT
MiMo-V2.6-Pro License MIT, 1.02 Nghìn Tỷ Params — Mình Tính Thử Chi Phí Self-Host
Model open-weight mới của Xiaomi đứng đầu Terminal-Bench 2.1 với 89.9%, DeepSWE nhảy từ 19.0 lên 71.9. Trước khi mừng vì license MIT, đọc thử phần này — 1.02T tổng params khác 42B active params ở điểm nào, và nó làm bill GPU của bạn khác nhau cỡ nào.
Trong bài viết
Xiaomi ra MiMo-V2.6-Pro ngày 22/9. Theo số liệu VentureBeat đăng, đây đang là model open-weights đứng đầu thế giới — vượt DeepSeek, đạt 89.9% trên Terminal-Bench 2.1, vượt cả Claude Opus 5 và GPT-5.6 Sol trên đúng benchmark này. DeepSWE nhảy từ 19.0 ở bản trước lên 71.9. Đó không phải sai số đo, đó là một hạng model khác hẳn.
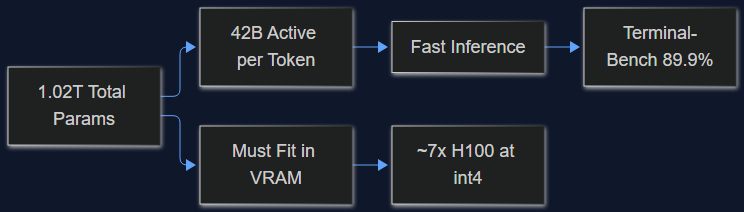
License MIT. Có trên HuggingFace. 1.02 nghìn tỷ tổng params, 42 tỷ active.
Câu khiến mình phải dừng lại đọc kỹ: “42B active” và “1.02T total” không phải cùng một con số, và khoảng cách giữa hai con số đó chính là nơi ngân sách hạ tầng của bạn sống hoặc chết.
Active params nói tốc độ. Total params nói hóa đơn.
MiMo-V2.6-Pro là model Mixture-of-Experts với router đóng băng — nghĩa là quyết định routing (token nào đi expert nào) được cố định sẵn, không train lại theo từng lần chạy cùng phần còn lại của mạng. Với mỗi token, chỉ 42 tỷ params thực sự tham gia tính toán. Đây là con số quyết định latency inference và chi phí FLOPs mỗi token. Và nó thực sự nhanh — ngang tầm compute với các model dense cỡ 40B.
Nhưng khi inference, hệ thống không biết trước token sẽ route vào expert nào. Nên trừ khi bạn làm offloading expert kiểu phức tạp, toàn bộ 1.02T params phải nằm sẵn ở đâu đó mà accelerator truy cập được nhanh — VRAM nếu muốn throughput thật, hoặc NVMe/CPU RAM kèm scheme offload nếu chấp nhận ăn thêm latency.
Tính nhanh trên giấy:
fp16:  1.02T params × 2 bytes ≈ 2.04 TB chỉ riêng weight
int8:  1.02T params × 1 byte  ≈ 1.02 TB
int4:  1.02T params × 0.5 byte ≈ 510 GB
Một H100 cho bạn 80GB HBM. Ở int4, bạn vẫn cần khoảng 7 cái H100 chỉ để chứa weight, chưa tính một byte nào cho KV cache, activation, hay batch headroom. Ở fp16, con số vượt 25. Đó là chưa kể overhead network multi-node, chưa tính expert được shard qua các device như thế nào, chưa nói gì đến latency thật dưới tải.
So với bản Flash Xiaomi ra cùng lúc — 310B total, 15B active. Ở int4 tầm 155GB, vừa đủ cho hai H100, còn dư chỗ. Nếu use case của bạn không cần mức trần của bản Pro, Flash là cái bạn nên định giá trước.
Lựa chọn kiến trúc dễ bị bỏ qua
Backbone hybrid-SWA — trộn sliding-window attention với các layer global attention — đang làm việc thật ở đây, và đây là tradeoff mà Mistral và vài nơi khác cũng từng dùng: hầu hết token chỉ cần nhìn context gần, nên hầu hết layer không cần attention quadratic đầy đủ. Bạn dành các layer global-attention đắt đỏ cho những chỗ thực sự cần theo dõi dependency xa. Đây là cách hợp lý để giữ một model context dài khỏi trở nên phi lý về compute, và đáng đọc kỹ phần breakdown từng layer nếu bạn đang đánh giá model này cho việc xử lý document dài.
Chi tiết khác ít được nhắc tới: một decoder multi-token-prediction 5 layer cho speculative decoding. MTP train model đoán trước vài token cùng lúc, sau đó verify lại với pass autoregressive “thật” — khi đoán đúng, bạn nhận được nhiều token với chi phí một lần forward pass. Rất có thể đây là phần lớn lý do bản “UltraSpeed” của Xiaomi tuyên bố nhanh 20x với chất lượng gần như không đổi. Speculative decoding không mới, nhưng một head MTP 5 layer được nhúng sẵn vào model cỡ này, ra kèm weight bạn thực sự inspect được, là một tài liệu tham khảo hữu ích nếu bạn tự build inference stack và muốn một implementation thật, không phải lời hứa trên slide.
Omnimodal-native so với vision gắn thêm
MiMo tự nhận là omnimodal-native — text, ảnh, video, âm thanh — train như một model duy nhất, không phải language model gắn thêm adapter vision sau đó. Mình sẽ nghi ngờ vừa phải với tuyên bố “omnimodal-native” từ bất kỳ lab nào, kể cả cái này, cho đến khi eval độc lập xác nhận nó đứng vững ngoài benchmark được chọn sẵn. Nhưng về kiến trúc, cách đặt cược này hợp lý: một model được train từ đầu để route mọi modality qua cùng pool expert, về lý thuyết sẽ transfer concept giữa các modality tốt hơn một backbone text đóng băng gắn thêm vision encoder rồi fine-tune riêng. Lợi thế lý thuyết đó có xuất hiện trong pipeline document-QA-kèm-screenshot thật của bạn hay không là câu hỏi thực nghiệm bạn phải tự test, không phải thứ một bảng benchmark quyết định hộ bạn.
Mình sẽ làm gì với cái này
Nếu team bạn đang đánh giá model open-weights cho việc gì xa hơn “thử xem nó có chạy không”, câu hỏi không phải “nó có hơn Opus 5 ở một benchmark hay không”. Mà là: hạ tầng của bạn có chịu được compute budget của active params, có chịu được memory budget của total params, và hai con số đó có kể hai câu chuyện chi phí khác hẳn nhau không. Với MiMo-V2.6-Pro thì có — nhanh như model 42B, đắt host như model 1T. Khoảng cách đó mới là quyết định thật bạn đang đưa ra, không phải điểm Terminal-Bench.
Bài viết liên quan
06 Oct 2026 · 6 phút đọc
agentic coding
Agent của mình không quên. Nó chưa bao giờ ghi lại cái gì cả.
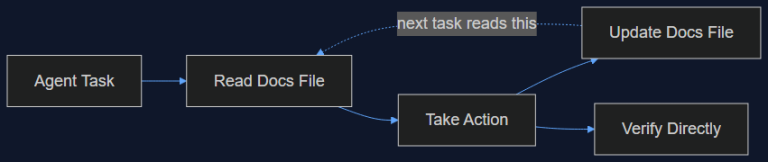
Một bài viết trên Hacker News về 'memory' của AI agent xuất hiện đúng tuần mình vừa debug xong một lỗi dedup thật, gây ra bởi chính cái vấn đề bài viết đó mô tả. Mình đem test lại ngay trên sự cố của chính mình.
Đọc tiếp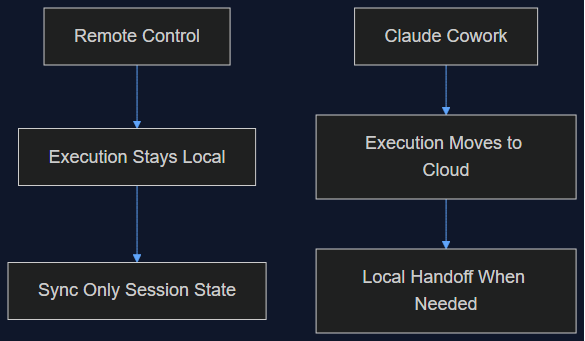
06 Oct 2026 · 6 phút đọc
agentic coding
Claude Cowork vừa làm đúng cái mình từng nói Remote Control không làm
Tháng 8 mình viết rằng Remote Control của Claude Code chỉ là một lớp đồng bộ, không phải di chuyển lên cloud, và việc giữ execution ở local chính là điểm cốt lõi. Tuần này Anthropic chuyển hẳn execution của Cowork lên cloud làm mặc định. Đây là lý do cả hai quyết định đều đúng — cho hai sản phẩm khác nhau.
Đọc tiếp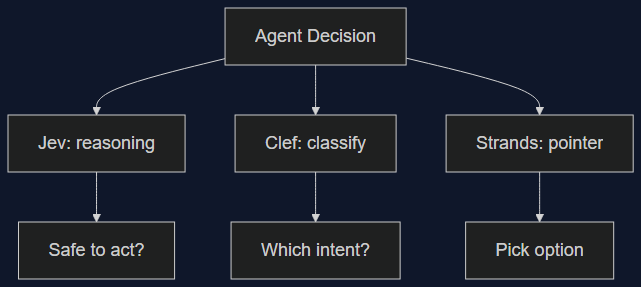
03 Oct 2026 · 6 phút đọc
agents
Ba Decision Model Ra Mắt Trong Một Tuần — Không Cái Nào Thắng Tuyệt Đối
Clef/Clef-flash của Cloudflare và Strands Decider của Amazon đều ra mắt ngày 1/10, nhắm thẳng vào Jev của TypeSafe. Mình xếp số liệu benchmark, latency, giá thật của cả ba cạnh nhau — category này là thật, nhưng chọn cái nào thắng lại tuỳ vào bạn đang tự động hoá quyết định gì.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.