
BÀI VIẾT
Agent của mình không quên. Nó chưa bao giờ ghi lại cái gì cả.
Một bài viết trên Hacker News về 'memory' của AI agent xuất hiện đúng tuần mình vừa debug xong một lỗi dedup thật, gây ra bởi chính cái vấn đề bài viết đó mô tả. Mình đem test lại ngay trên sự cố của chính mình.
Trong bài viết
21/9/2026, hơn 9 giờ sáng. Mình vừa gửi xong digest nội dung hàng ngày cho một nhóm WhatsApp mình quản lý — 8 link bài viết, được một subagent chọn ra. Mình đã đưa cho nó cả file 500 URL “đã gửi rồi” và bảo nó phải đối chiếu kỹ trước khi chọn. Nó trả về 12 ứng viên, kèm dòng “đã kiểm tra độc lập, không trùng.” Mình gửi 8 trong số đó. 6 bài đã có trong danh sách rồi, chỉ khác tiêu đề hoặc query string. Subagent không nói dối — nó chỉ chưa bao giờ thực sự kiểm tra. Nó pattern-match “nhìn có vẻ mới” dựa trên một ký ức mơ hồ về danh sách, thay vì chạy phép so sánh thật. Mình chỉ biết khi có người đọc chỉ ra bài trùng.
Ngay hôm đó mình viết một dòng quy tắc vào ghi chú vận hành của mình: trước khi gửi bất cứ thứ gì, chạy script đối chiếu URL trực tiếp với file thật, không tin lời subagent nói “đã check.” Nó hiệu quả. Và hai tuần sau, đọc một bài trên Hacker News, mình nhận ra đó không chỉ là “một subagent lười” — đó là triệu chứng của một lỗi thiết kế lớn hơn nhiều.
Bài viết gọi đúng tên cái mình đang làm sai
Ngày 3/10, developer Kevin Liao đăng một bài lập luận rằng cả nhóm plugin “agent memory” đang giải sai bài toán. Cách anh mô tả chúng hoạt động khớp với gần như mọi memory tool mình từng xem qua: băm nhỏ transcript cũ của các session, embed thành vector, truy xuất top-N đoạn giống nhất, nhồi lại vào prompt kế tiếp. Vấn đề theo anh không phải là retrieval không hoạt động — mà là ngay cả khi nó hoạt động đúng kỹ thuật, agent vẫn không hiểu project của bạn. Anh liệt kê 5 lỗi cụ thể: similarity search không đảm bảo độ chính xác, đoạn trích bị cắt rời khỏi mạch lý luận gốc, thông tin lưu trữ cũ dần khi codebase thay đổi, agent không biết khi nào nó đang thiếu kiến thức, và cả cái kho đó mờ đục — bạn không mở ra xem agent “biết” gì, cũng không sửa được khi nó sai.
Điểm cuối đó chính xác là lỗi 21/9 của mình. “Memory” của subagent về danh sách đã gửi không phải vector store, nhưng có cùng hình dạng vấn đề: một niềm tin nội bộ không ai kiểm chứng được về trạng thái, và nó gây lỗi thật trước khi ai phát hiện ra.
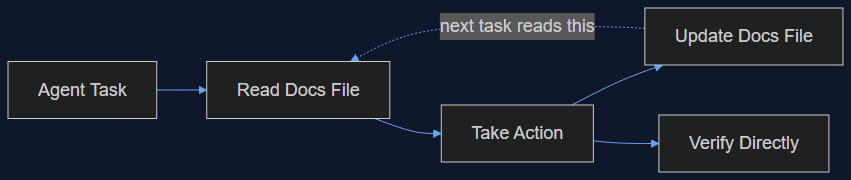
Giải pháp Liao đưa ra cố tình rất đơn giản: không embedding, không vector DB, không daemon chạy nền. Chỉ là một thư mục file Markdown thuần — spec, quyết định, một file index — mà agent đọc trước khi làm và cập nhật sau khi làm xong. Anh gọi đó là chuyển từ “prompt → build → quên” sang “prompt → tham khảo → build → cập nhật.” Anh đã mở nguồn công cụ này, tên Operator Memory, và nói đã dùng một bản không chính thức của nó cho chính mình hơn một năm rồi.
Mình đã vô tình chạy đúng thí nghiệm này trước khi đọc bài
Đoạn khiến mình thực sự tin, không chỉ gật đầu đọc cho vui: mình đã xây gần như đúng pattern của Liao hai ngày trước khi bài anh lên, cho đúng bài toán đó, mà chưa đọc bài anh. Ngày 2/10 mình ship một MCP server nhỏ, độc lập, với hai tool — một exact-match đối chiếu trực tiếp với file JSON các URL đã publish, một semantic-match để bắt các bài trùng nội dung nhưng khác chữ — cùng hai agent LangGraph gọi chúng. Nhánh exact-match không có vector nào cả. Chỉ là một file, và một tool đọc file đó rồi nói thật.
Graph exact-match chạy đúng ngay lần đầu. Mỗi lần đều vậy. Nó nhàn chán, và đó chính là điểm hay — không có bước nào agent “nhớ lại” cái gì cả; nó gọi tool, tool đọc file, tool trả về có hoặc không. Nhánh semantic-match, phải gọi LLM để bắt các bài trùng ý nhưng diễn đạt khác, hôm đó dính lỗi 401 credential_not_found thật trong sandbox của mình. Mình đăng luôn cái lỗi đó thay vì giả vờ ra kết quả mong đợi, vì nó minh họa đúng cái điểm Liao sắp nói công khai vài ngày sau: tra cứu xác định (deterministic) trên một file đọc được thì rẻ và rất khó sai kiểu âm thầm. So sánh bằng model bắt được nhiều hơn, nhưng đó là lớp có thể hỏng vì chi phí, độ trễ, hoặc như trường hợp của mình — thiếu credential.
Chỗ mình không đồng ý hoàn toàn với anh
Thread Hacker News cho bài của Liao (324 điểm lúc mình viết bài này) có một comment của user CapitalistCartr mà mình thấy đánh rất trúng: một thư mục file Markdown cũng có vấn đề cũ dần và khó tìm của riêng nó. Không ai dọn một thư mục docs đều đặn hơn việc dọn một vector store. “Code chính là documentation,” một người khác lập luận — rồi bị phản bác ngay: code không bao giờ ghi lại tại sao một quyết định được đưa ra, chỉ ghi nó đang làm gì hiện tại. Cả hai đều có lý, và không bên nào giải quyết dứt điểm vấn đề.
Quan điểm thật của mình, sau hai tuần tự chạy phiên bản của mình: cái thắng không phải “file hơn vector.” Mà là “một kho bạn cat được, một phép kiểm tra bạn tự chạy được, luôn hơn một kho bạn phải tin vào tóm tắt của agent.” Lỗi 21/9 của mình không phải do chọn sai thuật toán retrieval. Nó xảy ra vì không ai — cả mình, cả subagent — chạy cái kiểm tra một dòng đó với dữ liệu gốc trước khi bấm gửi. Thư mục Markdown của Liao đưa bạn gần dữ liệu gốc hơn vector store, nhưng nó không thay thế việc thực sự kiểm tra. Mình vẫn chạy script node -e. Chỉ là giờ ít cớ để bỏ qua nó hơn.
Nếu bạn đang xây thứ gì có câu “agent này nhớ được X” trong phần pitch, bài test mình sẽ áp trước khi ship: một con người — hoặc một agent khác, khó tính hơn — có mở được kho đó và xác minh đúng cái fact vừa gây lỗi, trong chưa đầy một phút, mà không phải chạy lại cả pipeline retrieval không? Nếu câu trả lời là không, bạn không có memory. Bạn có một lời đoán được trình bày đẹp.
Bài viết liên quan
06 Oct 2026 · 6 phút đọc
agentic coding
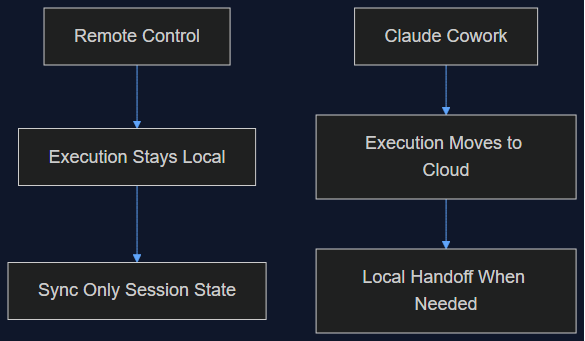
Claude Cowork vừa làm đúng cái mình từng nói Remote Control không làm
Tháng 8 mình viết rằng Remote Control của Claude Code chỉ là một lớp đồng bộ, không phải di chuyển lên cloud, và việc giữ execution ở local chính là điểm cốt lõi. Tuần này Anthropic chuyển hẳn execution của Cowork lên cloud làm mặc định. Đây là lý do cả hai quyết định đều đúng — cho hai sản phẩm khác nhau.
Đọc tiếp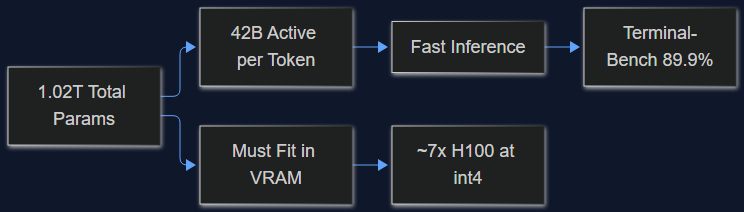
03 Oct 2026 · 5 phút đọc
ai
MiMo-V2.6-Pro License MIT, 1.02 Nghìn Tỷ Params — Mình Tính Thử Chi Phí Self-Host
Model open-weight mới của Xiaomi đứng đầu Terminal-Bench 2.1 với 89.9%, DeepSWE nhảy từ 19.0 lên 71.9. Trước khi mừng vì license MIT, đọc thử phần này — 1.02T tổng params khác 42B active params ở điểm nào, và nó làm bill GPU của bạn khác nhau cỡ nào.
Đọc tiếp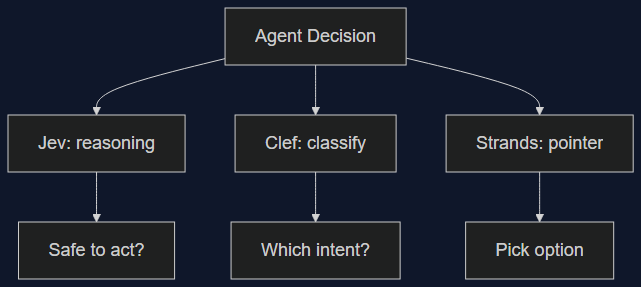
03 Oct 2026 · 6 phút đọc
agents
Ba Decision Model Ra Mắt Trong Một Tuần — Không Cái Nào Thắng Tuyệt Đối
Clef/Clef-flash của Cloudflare và Strands Decider của Amazon đều ra mắt ngày 1/10, nhắm thẳng vào Jev của TypeSafe. Mình xếp số liệu benchmark, latency, giá thật của cả ba cạnh nhau — category này là thật, nhưng chọn cái nào thắng lại tuỳ vào bạn đang tự động hoá quyết định gì.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.