
BÀI VIẾT
Ba Decision Model Ra Mắt Trong Một Tuần — Không Cái Nào Thắng Tuyệt Đối
Clef/Clef-flash của Cloudflare và Strands Decider của Amazon đều ra mắt ngày 1/10, nhắm thẳng vào Jev của TypeSafe. Mình xếp số liệu benchmark, latency, giá thật của cả ba cạnh nhau — category này là thật, nhưng chọn cái nào thắng lại tuỳ vào bạn đang tự động hoá quyết định gì.
Trong bài viết
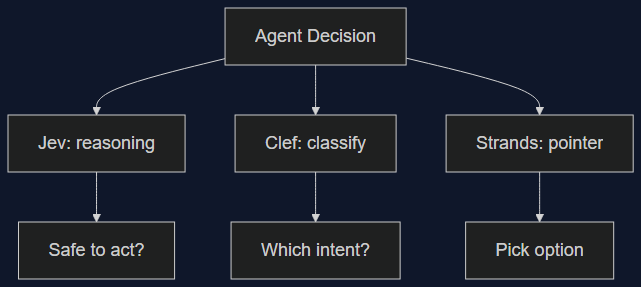
Hai tuần trước mình có viết về Jev — cú đặt cược của TypeSafe rằng rất nhiều quyết định của agent không cần đến chat model, chỉ cần một câu yes/no có độ tin cậy, một điểm số, hoặc chọn một trong list cố định. Mình gọi nó là “System 1” cho agent. Nhưng không ngờ phần còn lại của ngành phản ứng nhanh đến vậy.
Ngày 1/10, hai team riêng biệt cùng ra mắt câu trả lời trực tiếp cho Jev trong đúng một ngày. Cloudflare ra Clef (27B, build trên Qwen3.8) và Clef-flash (9B, build trên Qwen3.5), cả hai open-weight theo Apache 2.0, chạy trên Workers AI. Strands Labs của Amazon ra Strands Decider 2B — cũng Apache 2.0, cũng build trên Qwen3.5, nhưng cách làm bên trong hoàn toàn khác. Ba model “decision” ra mắt, hai kiến trúc, một tuần. Đây không phải trùng hợp, đây là một category đang hình thành ngay trước mắt.
Nên mình làm cái điều mình thực sự muốn làm từ bài Jev: đặt số liệu thật của cả ba cạnh nhau, xem ai thắng thật.
Chúng không giải cùng một bài toán theo cùng một cách
Jev là model hosted, closed — không công bố weight, context 64K, trong đó 32K dành riêng cho state cộng câu hỏi dài nhất. Bạn gọi API, nhận về câu trả lời có kiểu dữ liệu rõ ràng.
Clef và Clef-flash là prefill-only, không autoregressive. Model không sinh token từng cái một — nó đọc context một lần rồi trả về phân phối xác suất trên các output có kiểu, trong đúng một forward pass. Đây là lý do kiến trúc khiến nó nhanh: không có loop autoregressive, không sampling, không chờ stop token.
Strands Decider làm một việc lạ hơn, và thật ra thú vị hơn. AWS lấy Qwen3.5-2B-Base, cắt bỏ language-model head — phần vốn sẽ sinh token tiếp theo dưới dạng text — rồi gắn vào một “pointer head” chỉ khoảng 1 triệu tham số, cộng thêm LoRA adapter rank-16 trên backbone. Pointer head không sinh ra gì cả. Nó chấm điểm trực tiếp các lựa chọn bạn đưa vào. Bạn không hỏi model viết ra “yes” — bạn hỏi nó chỉ vào option số 0 trong số các option bạn cho, kèm độ tin cậy đã được calibrate.
Ba cách khác nhau để tránh đúng một thứ khiến chat model chậm: viết ra text mà cuối cùng bạn vứt đi.
Số liệu, xếp cạnh nhau
| Jev | Clef | Clef-flash | Strands Decider 2B | |
|---|---|---|---|---|
| Base | proprietary | Qwen3.8-27B | Qwen3.5-9B | Qwen3.5-2B |
| License | closed | Apache 2.0 | Apache 2.0 | Apache 2.0 |
| Latency trung vị | 524.1 ms | 209.3 ms | 38.8 ms | ~115 ms (RTX 3090) |
| Giá (input, /1M token) | $0.042 | $0.240 | $0.090 | miễn phí, self-host |
| BANKING77 (macro-F1) | 79.74 | 94.20 | 90.93 | — |
| GPQA Diamond | 78.3 | 48.0 | — | — |
| MMLU-Pro | 82.7 | 65.9 | — | — |
| JevBench hard tier | — | — | — | 0.505 |
Vài điểm đáng chú ý ngay, và không cái nào trong đó là “mua Clef” hay “mua Jev.”
Jev vẫn dẫn rõ ở mọi thứ liên quan đến reasoning tổng quát — GPQA Diamond, MMLU-Pro, độ chính xác When2Call (80.97 so với điểm “hard tier” 0.505 của Strands, mà chính bài viết của AWS cũng thẳng thắn gọi là “gần như tung đồng xu”). Nếu quyết định của bạn là “agent này có nên escalate lên người không” hay “hành động này có an toàn không”, bạn cần model thực sự đang suy luận về tình huống, không phải pattern-match với một tập nhãn cố định. Đó vẫn là sân của Jev.
Clef thắng áp đảo ở phân loại intent và routing — BANKING77, CLINC150+OOS, chọn tool call. Đây là các quyết định closed-set, nặng pattern, nơi bạn không yêu cầu model suy luận, bạn yêu cầu nó nhận diện. Clef-flash nhanh hơn Jev 13 lần với giá chỉ 2.1 lần; Clef đầy đủ nhanh hơn 2.5 lần với giá 5.7 lần. Nếu nghẽn cổ chai của bạn là “ticket này thuộc 1 trong 40 intent nào”, Clef-flash là lựa chọn rõ ràng và không có gì để tranh luận.
Điểm bán thật của Strands Decider không nằm ở số benchmark — mà ở việc AWS công bố mọi thứ. Weight, data training, script training, đủ cả. Clef và Clef-flash là open-weight theo nghĩa bạn download và chạy được, nhưng Cloudflare chưa công bố pipeline hay data training. Strands là cái duy nhất bạn thực sự audit và reproduce lại từ đầu được — nếu điều đó quan trọng với team compliance của bạn hơn là vài điểm accuracy thêm.
Phần mà bài launch không nói ra
Server reference của Strands Decider mặc định bind vào localhost, không authentication. Đó là default hợp lý cho vòng dev local, và là default khá tệ nếu ai đó copy quickstart vào môi trường shared mà không đọc hết các bước. Nếu bạn self-host cái này — và self-host chính là lý do để chọn nó thay Jev — hãy đặt nó sau một lớp auth của riêng bạn trước khi để bất cứ ai chạm vào. Đây cùng loại lỗi với việc ship một database không mật khẩu mặc định: ổn cho đến khi không ổn nữa.
Điều khác mà không bảng benchmark nào thể hiện: tất cả đều là model hẹp, có hard failure mode rõ rệt ngoài phân phối train. Điểm CLINC150+OOS của Clef-flash (66.77, kém xa Clef với 97.43) là tín hiệu — nó giỏi chọn trong các category đã biết và kém hẳn khi nhận diện “không phải cái nào trong số này cả.” Nếu không gian quyết định của agent bạn thực sự có thể bị bất ngờ, một model hẹp, nhanh, nhưng tự tin sai còn tệ hơn một model chậm nhưng biết chừa đường lui.
Mình sẽ đặt mấy cái này ở đâu
Mình sẽ cho Clef-flash chạy trước pipeline support hoặc routing ticket, nơi tập intent cố định và rõ ràng — bài toán latency/giá tốt đến mức không có lý do để bỏ qua cho một vấn đề closed-set. Mình sẽ giữ thứ gì đó dạng Jev (hoặc một model tổng quát nhỏ) sau mọi quyết định gác cổng cho hành động không thể đảo ngược — refund, xoá dữ liệu, bất cứ gì không undo được. Và mình chỉ cân nhắc Strands Decider nếu “chúng ta phải tự retrain, air-gapped, trên hạ tầng chúng ta sở hữu” là yêu cầu thật, không phải thứ “có thì tốt” — vì ceiling accuracy hiện tại của nó rõ ràng thấp hơn cả Jev và Clef ở mọi thứ không phải phân loại thuần.
Ba lần ra mắt, một tuần, và kết luận thật thì lại khá chán: đây không phải một model để chọn, mà là một ô trong kiến trúc của bạn, cần lấp bằng những thứ khác nhau tuỳ vào việc model sai thì bạn mất gì.
Bài viết liên quan
06 Oct 2026 · 6 phút đọc
agentic coding
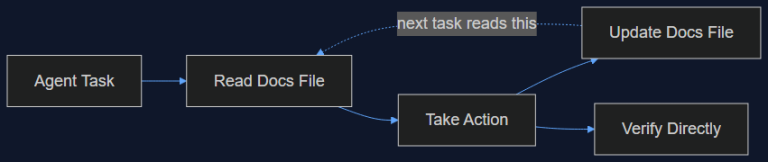
Agent của mình không quên. Nó chưa bao giờ ghi lại cái gì cả.
Một bài viết trên Hacker News về 'memory' của AI agent xuất hiện đúng tuần mình vừa debug xong một lỗi dedup thật, gây ra bởi chính cái vấn đề bài viết đó mô tả. Mình đem test lại ngay trên sự cố của chính mình.
Đọc tiếp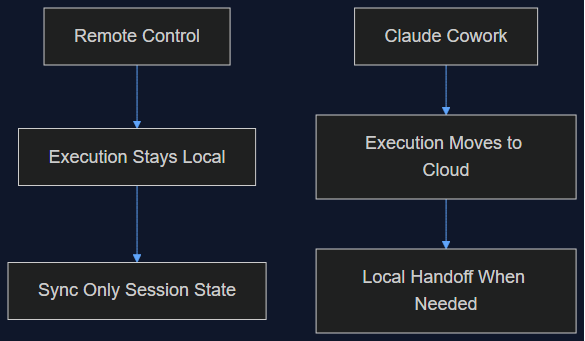
06 Oct 2026 · 6 phút đọc
agentic coding
Claude Cowork vừa làm đúng cái mình từng nói Remote Control không làm
Tháng 8 mình viết rằng Remote Control của Claude Code chỉ là một lớp đồng bộ, không phải di chuyển lên cloud, và việc giữ execution ở local chính là điểm cốt lõi. Tuần này Anthropic chuyển hẳn execution của Cowork lên cloud làm mặc định. Đây là lý do cả hai quyết định đều đúng — cho hai sản phẩm khác nhau.
Đọc tiếp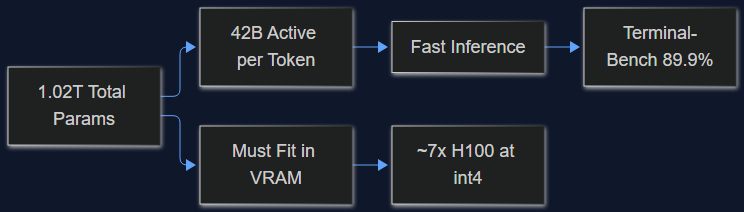
03 Oct 2026 · 5 phút đọc
ai
MiMo-V2.6-Pro License MIT, 1.02 Nghìn Tỷ Params — Mình Tính Thử Chi Phí Self-Host
Model open-weight mới của Xiaomi đứng đầu Terminal-Bench 2.1 với 89.9%, DeepSWE nhảy từ 19.0 lên 71.9. Trước khi mừng vì license MIT, đọc thử phần này — 1.02T tổng params khác 42B active params ở điểm nào, và nó làm bill GPU của bạn khác nhau cỡ nào.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.