
BÀI VIẾT
Benchmark An Ninh Của Gemini 4 Carbon Có Một Dấu Hoa Thị
Gemini 4 Carbon mới của Google đạt 88,2% trên SEC-bench Pro và 71% trên CWE-bench cho việc tìm và sửa lỗ hổng thật. Chính Google nói các con số này không có guardrail, và quyền truy cập hiện chỉ dành cho defender đã được kiểm duyệt.
Trong bài viết
Hai tuần. Đó là khoảng cách giữa lúc Gemini 4 Argon ra mắt và lúc Google DeepMind công bố bản thay thế, Gemini 4 Carbon, ngày 28/10. Nếu bạn chỉ lơ là một chút trong chu kỳ ra mắt của Argon, bạn đã bỏ lỡ luôn vị trí flagship hiện tại.
Cách Google định vị Carbon hẹp hơn kiểu “giỏi hơn mọi mặt”, và chính điều đó khiến nó đáng nhìn kỹ hơn. Google xây model này riêng cho phòng thủ an ninh mạng và công việc agentic dài hơi — tác vụ chạy nhiều ngày, không phải vài phút, và phần thưởng là tìm ra một lỗi thật trong codebase của ai đó, không phải viết một hàm gọn hơn. Ba con số đáng chú ý: 88,2% trên SEC-bench Pro, benchmark tìm lỗ hổng thật trong phần mềm thực tế; 71% trên CWE-bench, đo việc bản patch của model cho một nhóm lỗi cụ thể có thật sự hoạt động; và 54,8% trên ExploitGym, kiểm tra việc một lỗ hổng tìm ra có biến được thành exploit chạy được, với ngân sách thời gian mười giờ.
Xếp ba con số đó cạnh nhau, bạn thấy một hình dạng, không chỉ một bảng điểm. Carbon giỏi tìm lỗi, khá ở việc sửa lỗi, và yếu hơn — dù không tệ — ở việc chứng minh lỗi đó khai thác được thật. Khoảng cách giữa 88,2% và 54,8% chính là khoảng cách giữa “cái này nhìn giống lỗ hổng” và “tôi chỉ cho bạn code chạy được để phá nó”, và đó đúng là khoảng cách phân biệt một công cụ triage hữu ích với một thứ đưa sẵn exploit cho kẻ tấn công.
Điểm mắc mà chính Google ghi trong thông báo
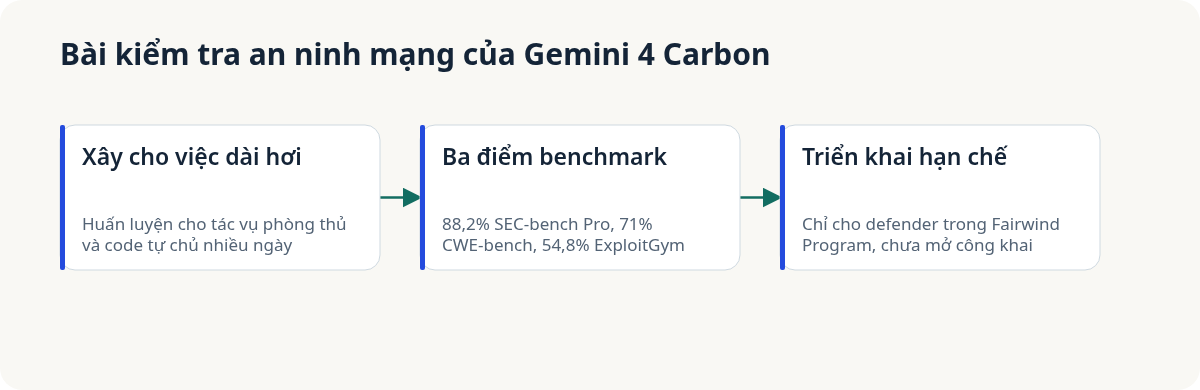
Cách Google tự trình bày có một chi tiết đáng dừng lại: những con số benchmark này được tạo ra “không có guardrail”. Đó là cách nói của chính Google, không phải tin lộ hay suy đoán của ai khác. Nghĩa là bản production bạn thực sự được dùng, với bất kỳ giới hạn an toàn nào đi kèm, không chắc đạt 88,2% ở bất cứ đâu. Con số đó mô tả giới hạn năng lực thô của model trong điều kiện kiểm thử, không phải thứ một khách hàng gọi API sẽ thấy.
Sự khác biệt này quan trọng hơn ở đây so với một benchmark coding hay viết lách thông thường, vì năng lực đang được đo — tìm và khai thác lỗ hổng phần mềm — chính là năng lực mà kẻ tấn công cũng muốn có. Một guardrail thật sự làm giảm năng lực sinh exploit cũng là một guardrail làm giảm điểm SEC-bench Pro. Google chưa công bố Carbon đạt bao nhiêu điểm với guardrail thật sự đi kèm sản phẩm, và đó mới là con số cho bạn biết bạn thực sự nhận được gì.
Ai thực sự được dùng
Quyền truy cập mở từ tuần này qua Fairwind Program của Google, dành cho các defender an ninh mạng đã được kiểm duyệt, với lời hứa mở rộng hơn nhưng chưa có ngày cụ thể. Đó là cách hợp lý để ra mắt một model mà phần mô tả benchmark cũng đồng thời là một màn thể hiện năng lực cho công việc an ninh tấn công — bạn không muốn thứ này nằm sau một form đăng ký tự phục vụ ngay ngày đầu. Nhưng điều đó cũng có nghĩa con số 88,2% hiện tại không ai ngoài chương trình đó kiểm chứng lại được một cách độc lập. Hãy đối xử với nó như mọi con số vendor tự công bố trước khi có bên thứ ba thực sự dùng thử: có giá trị định hướng, chưa được xác minh.
Nếu bạn phụ trách team security đang cân nhắc xin quyền Fairwind, câu hỏi thực tế không phải “88,2% có tốt không” — rõ ràng là tốt, so với GPT-6 Astra và Gemini 4 Argon trong bảng so sánh của chính Google. Câu hỏi là backlog lỗ hổng của bạn có giống bộ test của SEC-bench Pro không, vốn nghiêng về các nhóm lỗi dễ phát hiện, được định phạm vi rõ trong codebase thực tế. Một model mạnh ở đó thật sự hữu ích cho việc triage ở quy mô lớn. Nhưng dựa trên mọi thứ Google đã công bố tới giờ, đây không phải một model bạn chỉ vào toàn bộ codebase rồi bỏ đó không giám sát — chỉ riêng con số ExploitGym đã nói khoảng một nửa thứ nó gắn cờ là khai thác được sẽ không đứng vững, và đó là trước khi guardrail cắn thêm vào con số đó.
Nhịp ra mắt hai tuần nói lên điều gì
Tạm bỏ câu hỏi benchmark qua một bên, nhìn vào lịch ra mắt. Argon ra mắt, rồi Carbon thay thế vị trí flagship chỉ hai tuần sau. Đó không phải một chu kỳ refresh hằng năm kèm đợt truyền thông rầm rộ — nó gần với một bản point release hơn. Google trình bày Carbon như câu trả lời cho những điểm yếu cụ thể của Argon trong tác vụ an ninh dài hơi, không phải một lần huấn luyện lại từ đầu, và lịch trình ủng hộ cách trình bày đó: không ai huấn luyện lại một frontier model từ con số không trong mười bốn ngày.
Điều đó có ý nghĩa thực tế gì: nếu bạn đang xây công cụ an ninh dựa trên Gemini, đừng giả định phiên bản model hôm nay là phiên bản pipeline của bạn sẽ gọi trong một tháng nữa. Chu kỳ thay flagship hai tuần một lần nhanh đến mức việc pin version và kiểm chứng lại trên bộ test của chính bạn, không chỉ dựa vào con số Google công bố, cần trở thành việc làm định kỳ, không phải bước setup một lần. Cùng một điểm SEC-bench Pro trên một bản Gemini 4 tương lai không đảm bảo cùng hành vi trên codebase cụ thể của bạn, và model đứng sau API endpoint có thể đổi nhanh hơn bộ eval của chính bạn.
Nguồn
Google DeepMind trên X: thông báo Gemini 4 Carbon (28/10/2026).
The Decoder: Google DeepMind releases Gemini 4 Carbon just two weeks after Argon with gains across the board (truy cập 30/10/2026).
Bài viết liên quan
· 6 phút đọc
an-ninh-ai
40% Lỗ Hổng Đã Có Bản Vá Vẫn Chưa Được Vá Sau 180 Ngày
Báo cáo ngày 2/11 của Echo theo dõi 40.000 vòng đời lỗ hổng trên 250 dự án container mã nguồn mở: 89% đã có bản vá sẵn, nhưng 40% vẫn chưa được vá sau hơn 180 ngày. Điểm nghẽn không phải phát hiện bằng AI — mà là áp dụng bản vá.
Đọc tiếp
· 6 phút đọc
agentic-ai
76% Agent AI Đang Ngủ Im. Không Cái Nào Mất Chìa Khóa.
Báo cáo 2026 của Arrakis Security cho thấy hầu hết agent AI ngủ im sau vài tháng nhưng vẫn giữ credential còn sống — 19% dùng API key không hết hạn, và một phần tư có thể bị kích hoạt bởi webhook không ký từ bên ngoài tổ chức.
Đọc tiếp
· 5 phút đọc
agentic-ai
EMBRACE: Lỗi Trình Duyệt Giấu Trong Năm Công Cụ Coding AI
Forever Security phát hiện Cursor, GitHub Copilot, Claude Desktop, VS Code và Codex đều nhúng trình duyệt với quyền lớn hơn trình duyệt thật — dẫn tới thực thi code, đánh cắp file và giả mạo địa chỉ. Hai trong năm lỗi vẫn chưa được vá.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.