
BÀI VIẾT
155 phản hồi bị lộ: bên trong lỗi KV-cache của GLM-5.3 trên Cloudflare
GLM-5.3 trên Cloudflare quảng cáo context window 1,05 triệu token nhưng cache thực chỉ chứa 681 nghìn. Khoảng cách đó, cộng một lỗi trong SGLang, đã làm lộ 155 phản hồi xuyên tenant. Tường trình sự cố nói gì, và bài học cho ai đang vận hành inference multi-tenant.
Trong bài viết
Hai mươi lăm phút. Đó là thời gian team an ninh của chính Cloudflare cần để dựng lại lỗi, một khi đã biết nhìn vào đâu, theo tường trình sự cố công ty công bố ngày 26/10. Bốn mươi phút sau đó, GLM-5.3 bị rút khỏi Workers AI, do chính tay Cloudflare, trước khi ai khác buộc họ phải làm vậy.
Nguyên nhân gốc nằm ở hai con số lẽ ra không bao giờ nên lệch nhau: context window 1.048.576 token được quảng cáo cho bất kỳ ai gọi GLM-5.3, và một KV cache pool thực tế chỉ chứa được 681.280 token trạng thái attention. Cloudflare chạy GLM-5.3 ở chế độ serving tách rời (disaggregated) của SGLang, nơi một nhóm máy xử lý prefill rồi chuyển giao cho một nhóm máy khác chạy decode, để mỗi giai đoạn có thể scale độc lập khi tải tăng. Trên giấy, model hứa hẹn hơn một triệu token context. Trong cache thực sự đứng sau nó, chỗ chứa chỉ bằng khoảng hai phần ba con số đó.
Một prompt đòi nhiều hơn dung lượng pool đáng lẽ phải bị từ chối ngay. Nhưng một lỗi trong đường xử lý tách rời đó lại thay token của prompt bị từ chối bằng một token placeholder duy nhất, rồi vẫn cho request tiếp tục chạy qua pipeline. Tín hiệu “transfer complete” từ node prefill sang node decode vẫn kích hoạt, bất kể trạng thái attention thật có được chuyển hay không. Có những lúc thứ nằm trong ô cache của node decode không phải placeholder, mà là bất kỳ dữ liệu KV nào đang sẵn ở đó từ một request trước, của một khách hàng khác.
Mười ba ngày, 155 phản hồi
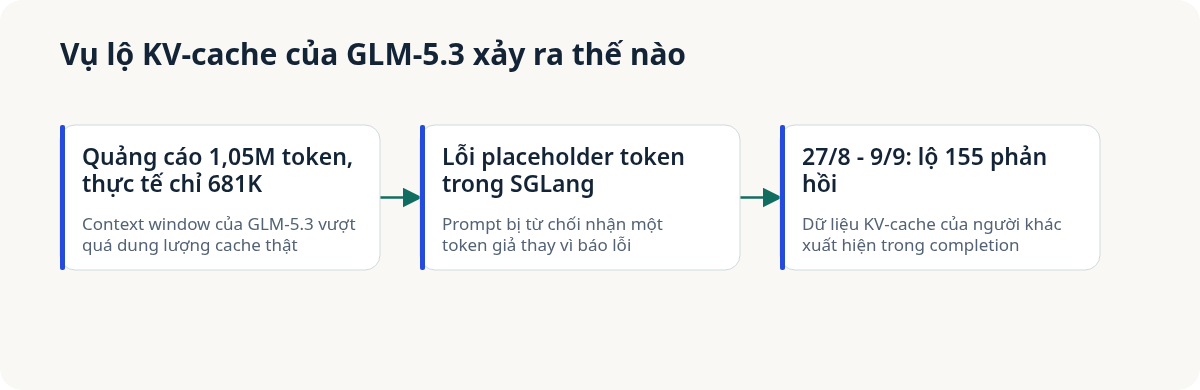
Cloudflare xác định khoảng thời gian lộ là mười ba ngày, từ 27/8 đến 9/9, và đếm được 155 completion có chứa đoạn dữ liệu attention đã cache của người khác lẫn vào phản hồi của một người dùng khác. So với toàn bộ lưu lượng Workers AI xử lý trong khoảng đó, 155 là con số nhỏ. Nhưng không phải con số không, và chuyện này chỉ xảy ra với GLM-5.3 — mọi model khác trên nền tảng có KV pool được cấu hình đúng theo context quảng cáo của chính nó, nên lỗi này cần cả hai thứ xảy ra cùng lúc: sai lệch kích thước và lỗi ở chế độ tách rời.
Cloudflare nói cuộc điều tra của họ không thấy dấu hiệu ai đã phát hiện và chủ động khai thác lỗ hổng này trước khi báo cáo HackerOne làm bùng lên toàn bộ phản ứng xuất hiện. Gadi Evron, nhà nghiên cứu tại Knostic, được ghi nhận là người gửi báo cáo đó. Mình sẽ hiểu câu “không có bằng chứng khai thác chủ động” đúng như nó viết, không hơn: đó là việc không tìm thấy bằng chứng trong log vốn không được dựng ra để bắt đúng kiểu lỗi này, không phải một sự bảo đảm rằng chưa từng có ai nhìn thấy một đoạn hội thoại của người khác và lặng lẽ không nói gì.
Bản vá không có gì hào nhoáng, và đó chính là điểm hay
Cách khắc phục của Cloudflare có hai phần, không phần nào cầu kỳ. Một, họ tăng KV pool đứng sau GLM-5.3 lên khoảng 2,04 triệu token, khớp với cấu hình đang chạy ở GLM-5.2, để context quảng cáo và dung lượng cache thực sự lại khớp nhau. Hai, họ vá SGLang để một request bị từ chối bị loại ngay tại hàng đợi admission, trước khi bất kỳ handoff chuyển KV nào xảy ra, thay vì để nó lần mò qua pipeline với một token placeholder đứng thế cho dữ liệu chưa từng tồn tại.
Thêm vào đó, họ gắn thêm logic kiểm tra tính toàn vẹn để tự bắt được một lần chuyển KV sai tenant, độc lập với việc hàng đợi admission có bắt được request đó trước hay không. Vừa đai vừa nịt. Chi phí hiệu năng cho lớp kiểm tra thêm đó, theo test của chính họ, dưới 1% — con số đáng nhớ lần sau khi có ai nói một lớp kiểm tra an toàn không đáng đánh đổi độ trễ.
Nếu bạn đang vận hành hạ tầng inference
Nếu bạn vận hành một dịch vụ inference multi-tenant, đặc biệt nếu có phần nào chạy ở cấu hình prefill/decode tách rời, bài học không chỉ là “đi rà lại kích thước KV cache”, dù việc đó cũng nên làm. Bài học là: con số context window bạn quảng cáo cho người dùng và con số dung lượng cache cấu hình thật trên hạ tầng là hai con số sống ở hai chỗ khác nhau trong hệ thống, và chẳng có gì buộc hai con số đó phải khớp nhau trừ khi có ai viết ra cái check để ép điều đó. Cấu hình của GLM-5.2 vô tình đúng. Cấu hình của GLM-5.3 thì sai, suốt mười ba ngày, cho đến khi một nhà nghiên cứu bên ngoài tìm ra trước.
Cũng nên để ý phần không hỏng trong câu chuyện này: tốc độ phản ứng của Cloudflare sau khi nhận báo cáo. Hai mươi lăm phút để dựng lại một lỗi lộ dữ liệu xuyên tenant trên một dịch vụ inference production là nhanh theo bất kỳ chuẩn nào, và bốn mươi phút để rút model khỏi hệ thống là kiểu số chỉ xảy ra khi quy trình phản ứng sự cố thực sự đã được tập dượt, không chỉ nằm trên giấy.
Cloudflare phản ứng nhanh khi đã biết. Hai mươi lăm phút để dựng lại, bốn mươi phút để rút model. Mười ba ngày trước đó mới là phần không ai vá lại được.
Nguồn
Cloudflare: KV cache exposure and remediation (tường trình sự cố gốc, truy cập 28/10/2026).
Bài viết liên quan
· 6 phút đọc
an-ninh-ai
40% Lỗ Hổng Đã Có Bản Vá Vẫn Chưa Được Vá Sau 180 Ngày
Báo cáo ngày 2/11 của Echo theo dõi 40.000 vòng đời lỗ hổng trên 250 dự án container mã nguồn mở: 89% đã có bản vá sẵn, nhưng 40% vẫn chưa được vá sau hơn 180 ngày. Điểm nghẽn không phải phát hiện bằng AI — mà là áp dụng bản vá.
Đọc tiếp
· 6 phút đọc
agentic-ai
76% Agent AI Đang Ngủ Im. Không Cái Nào Mất Chìa Khóa.
Báo cáo 2026 của Arrakis Security cho thấy hầu hết agent AI ngủ im sau vài tháng nhưng vẫn giữ credential còn sống — 19% dùng API key không hết hạn, và một phần tư có thể bị kích hoạt bởi webhook không ký từ bên ngoài tổ chức.
Đọc tiếp
· 5 phút đọc
an-ninh-ai
Benchmark An Ninh Của Gemini 4 Carbon Có Một Dấu Hoa Thị
Gemini 4 Carbon mới của Google đạt 88,2% trên SEC-bench Pro và 71% trên CWE-bench cho việc tìm và sửa lỗ hổng thật. Chính Google nói các con số này không có guardrail, và quyền truy cập hiện chỉ dành cho defender đã được kiểm duyệt.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.