
BÀI VIẾT
Bên Trong Performance Factory Của OpenAI: Codex Tự Săn Lỗi Hiệu Năng Của Chính Mình
OpenAI xây một pipeline chạy bằng Codex để điều tra các đợt sụt hiệu năng của ChatGPT, tự tranh luận với chính mình, rồi vẫn để kỹ sư giữ nút merge.
Trong bài viết
Ngày 19/11/2026, OpenAI công bố một hệ thống họ gọi là Performance Factory: một pipeline để Codex điều tra các đợt chậm của ChatGPT trước khi kỹ sư kịp mở ticket. Trong ba tháng, nó chạy hơn 1.700 cuộc điều tra. Sáu trăm trong số đó xác định được nguyên nhân gốc. Bốn trăm tiến thêm một bước, thành đề xuất sửa lỗi cụ thể. Tỷ lệ rơi rụng khá mạnh, và đó mới là phần đáng nói.
Phần lớn những câu chuyện kiểu “AI tự tìm bug” dừng lại ở bước điều tra. Cái này đi xa hơn. Khoảng năm mươi bản sửa đã lên production bắt nguồn từ gợi ý của agent mà kỹ sư chấp nhận hoặc làm theo. Khoảng mười lăm trong số đó là pull request do Codex viết, được merge gần như nguyên bản. Trung bình mỗi ngày có mười bảy cuộc điều tra. Nghe không có gì to tát, cho đến khi mình hình dung cảnh thay thế: một kỹ sư trực đêm, 2 giờ sáng, lục trace log để hiểu vì sao latency trung vị tăng 4% kể từ thứ Ba.
Quy trình, và vì sao agent thứ hai mới là chỗ đáng chú ý
Pipeline chạy qua năm giai đoạn: cảnh báo phát ra, Codex điều tra và đề xuất nguyên nhân gốc, nó soạn một bản sửa code, kỹ sư soát lại và quyết định có merge hay không, rồi hệ thống kiểm tra kết quả sau khi triển khai. Về hình dạng thì không mới — nhiều công ty đã có bot auto-triage. Cái khác ở đây là bước chen vào giữa: soát đối nghịch.
Trước khi một chẩn đoán đến tay người, một phiên Codex thứ hai — context mới hoàn toàn, không nhớ agent đầu đã suy luận thế nào — nhận chỉ thị rõ ràng: hãy cố bẻ gãy nó. Tìm lỗ hổng. Kiểm tra lại bằng chứng. Thử một cách giải thích khác xem có khớp hơn không. OpenAI nói bước soát đối nghịch này hiện bắt lại và đảo ngược khoảng 25% các chẩn đoán.
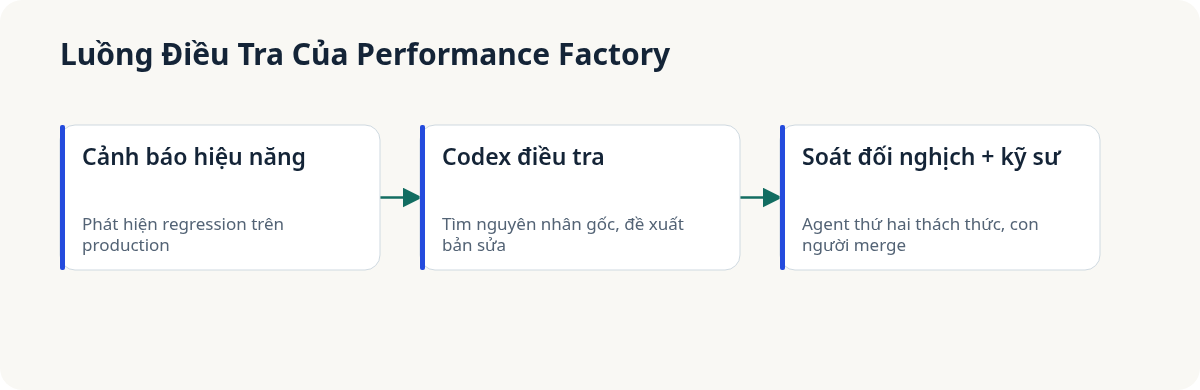
Ví dụ chính OpenAI đưa ra là kiểu chuyện dễ bỏ qua nếu không để ý: một lỗi tải ảnh bị đợt điều tra đầu đổ lỗi cho một dịch vụ định vị file đã hỏng. Bộ soát đối nghịch nhận ra dịch vụ đó đã hồi phục từ trước, trong khi lỗi vẫn tiếp diễn — nghĩa là nguyên nhân thật nằm ở chỗ khác. Một phần tư số lần, đây chính xác là cú cứu. Ba phần tư còn lại, chẩn đoán ban đầu đứng vững, và hệ thống đi tiếp mà không tốn buổi chiều của ai vào một ngõ cụt.
Chỗ con người vẫn ngồi
Mọi bản sửa vẫn cần một người ký duyệt. OpenAI nói thẳng: “Một kỹ sư soát lại code và quyết định có merge hay không.” Câu đó gánh nhiều việc hơn vẻ ngoài của nó. Nó nghĩa là mười lăm bản merge do Codex viết không bị đóng dấu cho qua — có người đọc thật, tên người đó gắn với bản triển khai. Nó cũng nghĩa là khoảng năm mươi bản sửa “bị ảnh hưởng” là kỹ sư coi gợi ý đủ nghiêm túc để hành động theo, chứ không phải agent tự ý đẩy thẳng lên production.
Mình hơi không đồng ý với cách một số bài đưa tin framing chuyện này, nghiêng hẳn về góc “AI tự sửa lỗi của chính nó”. Cách đọc chính xác hơn: Codex giỏi lên ở một việc pháp y hẹp và có giới hạn rõ — đối chiếu một đợt sụt hiệu năng với thay đổi gần nhất, khoanh vùng dịch vụ nào thật sự hỏng — và OpenAI xây thêm một agent thứ hai mà việc duy nhất của nó là nghi ngờ. Sự kết hợp đó mới là đóng góp kỹ thuật thật sự, không phải chuyện một model viết được vài diff.
Giai đoạn ai cũng lướt qua: kiểm tra sau triển khai
Giai đoạn thứ năm của pipeline gần như không được nhắc tới trong các bài đưa tin, mà có khi đó lại là bước giữ cho cả hệ thống trung thực. Sau khi một bản sửa lên production, hệ thống kiểm tra xem đợt sụt hiệu năng có thật sự biến mất không. Nghe hiển nhiên. Nhưng thực tế không hiển nhiên chút nào — nhiều đội ship một bản sửa, thấy dashboard yên ắng một tiếng rồi coi như xong, để rồi triệu chứng cũ quay lại một tuần sau dưới một tác nhân khác. Đóng vòng lặp này tự động nghĩa là một bản sửa tồi bị gắn cờ, thay vì âm thầm nằm trong codebase chờ sự cố tiếp theo phát hiện lại.
Điều này cũng đổi nghĩa của con số “năm mươi bản sửa đã ship”. Đó không phải năm mươi bản vá ai đó liếc qua rồi quên. Mỗi bản đều được đối chiếu lại với đúng cái nó được kỳ vọng giải quyết, sau khi đã chạy thật với dữ liệu production. Đó là một tiêu chuẩn khác hẳn phần lớn code review thông thường, dù agent viết hay người viết.
Cái hệ thống này không làm được
Cũng nên nói thẳng về giới hạn, vì một số bài đưa tin đang thổi phồng hơi quá. Bốn trăm đề xuất sửa lỗi trên 1.700 cuộc điều tra là tỷ lệ chuyển đổi 24% từ “tìm ra cái gì đó” sang “đây là bản vá”. Trong bốn trăm đó, khoảng năm mươi ảnh hưởng tới cái thật sự lên production. Tức là chỉ khoảng 3% tổng số điều tra biến thành một thay đổi production, dù agent hay người viết. 97% còn lại hoặc đi vào ngõ cụt, bị bộ soát đối nghịch bác, hoặc cần con người giải quyết từ đầu.
Tỷ lệ đó không phải điểm trừ. Nó đúng là thứ mình kỳ vọng từ một công cụ được xây cho một việc hẹp và cụ thể: bắt những đợt sụt hiệu năng có dạng giống cái Codex từng thấy, nơi mẫu lỗi đọc được rõ ràng từ log và trace. Một vấn đề kiến trúc thật sự mới — một tầng cache mới hoạt động sai dưới một pattern tải chưa ai mô hình hóa — vẫn cần người hiểu hệ thống ở mức mà việc đọc trace không thay thế được. Performance Factory không khẳng định ngược lại. Nó chỉ gánh bớt phần việc lặp đi lặp lại — lục log lúc 2 giờ sáng — khỏi tay kỹ sư, mười bảy lần một ngày, để 97% khó nhằn còn lại được chú ý nhiều hơn chứ không ít hơn.
Nguồn: VentureBeat, “OpenAI reveals Performance Factory” (19/11/2026).
Bài viết liên quan
· 5 phút đọc
AI models
GPT-6.2 Astra và Sol: Rẻ Hơn Thật, Nhưng Có Một Cái Bẫy
GPT-6.2 của OpenAI giảm giá và nhích điểm trí tuệ lên, nhưng benchmark về code lại kể một câu chuyện lộn xộn hơn nhiều so với con số trên trang chủ.
Đọc tiếp
· 6 phút đọc
ai-governance
OpenAI Đang Cho Người Ngoài Vào Trong Pipeline Huấn Luyện. Chỉ Là Không Sâu Như Đã Hứa.
OpenAI ký hợp đồng với Apollo Research, METR, Transluce và Goodfire cho giai đoạn đầu của chương trình đánh giá an toàn nhúng, cho họ quyền truy cập có giới hạn vào dữ liệu huấn luyện và checkpoint model. Một nhà nghiên cứu của Redwood nói mức này chưa đạt tới quyền truy cập kiểu nhân viên mà OpenAI từng hứa.
Đọc tiếp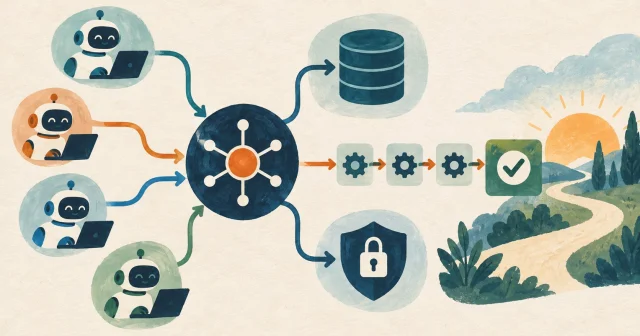
· 20 phút đọc
agentic coding
Phần 7: Áp dụng quy trình agent vào một dự án thật
Mình đem quy trình của series vào LingoLive AI, một repo đang chạy thật, bằng tool agent-repo-setup: audit, apply, verify trong sáu bước. Có hai bất ngờ: merge vào main là deploy production, và security review tìm ra ba lỗ trong chính các hook.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.