
BÀI VIẾT
GPT-6.2 Astra và Sol: Rẻ Hơn Thật, Nhưng Có Một Cái Bẫy
GPT-6.2 của OpenAI giảm giá và nhích điểm trí tuệ lên, nhưng benchmark về code lại kể một câu chuyện lộn xộn hơn nhiều so với con số trên trang chủ.
Trong bài viết
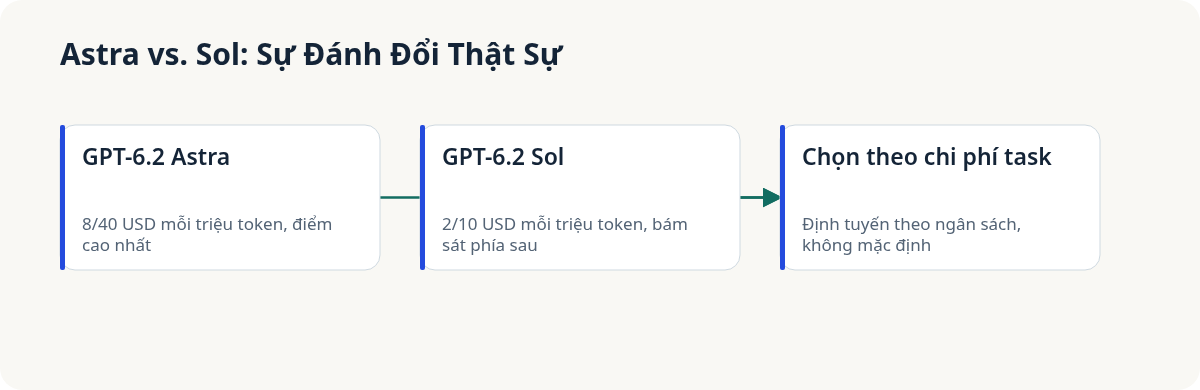
OpenAI tung GPT-6.2 Astra và GPT-6.2 Sol ngày 17/11/2026. Bài giới thiệu quen thuộc — thông minh hơn, rẻ hơn — và lần này phần “rẻ hơn” lại là thứ dễ kiểm chứng nhất. Astra giá 8 USD mỗi triệu token đầu vào, 0,40 USD cho token cache, 40 USD cho token đầu ra. Sol thì 2 USD đầu vào, 0,10 USD cache, 10 USD đầu ra. Để so sánh, GPT-6 Astra trước đó đắt hơn khoảng 20% ở cùng các mức giá này.
Thử tính một ví dụ cụ thể: 1.000 request, mỗi request 10K token đầu vào và 2K token đầu ra. GPT-6.2 Astra tốn khoảng 160 USD tổng cộng. GPT-6 Astra bản cũ sẽ tốn khoảng 200 USD cho cùng khối lượng việc đó. Đó là khoản tiết kiệm 20% có thể kiểm tra lại được, không phải chiêu làm tròn số để marketing.
Điểm trí tuệ có nhích lên, nhưng không đều
Trên Artificial Analysis Intelligence Index, Astra đạt 62 điểm, tăng năm điểm so với GPT-6 Astra. Sol đạt 57, tăng hai điểm so với GPT-6.1 Sol. Cả hai đều là tiến bộ thật. Nhưng không model nào vượt qua Claude Fable 5.2, đang giữ 65 điểm trên cùng bảng xếp hạng. Nếu chỉ số trí tuệ tổng quát là thứ mình quan tâm, GPT-6.2 thu hẹp khoảng cách với người dẫn đầu chứ chưa đóng được khoảng cách đó.
Chỗ thú vị hơn, và cũng là chỗ các thông cáo báo chí thường lặng im: ở các benchmark về code, bức tranh đảo chiều. Kết quả Coding Agent Index được công bố cho thấy Astra gần như đứng yên so với phiên bản trước, còn Sol tụt — giảm ba điểm tổng thể. Một model giá rẻ hơn, điểm trí tuệ tổng quát nhích lên một chút, nhưng lại kém đi rõ rệt ở một mảng việc viết code, thì không phải là bản nâng cấp toàn diện. Đó là một bản phát hành khác, nhắm tới một nhóm người dùng khác.
Nhìn kỹ hai benchmark cụ thể
Hai benchmark hẹp hơn làm rõ sự đánh đổi này. Trên AA-Robotics v0.1, bộ test xoay quanh các tác vụ suy luận kiểu robotics, Astra đạt 79 điểm và Sol đạt 78 — sát nhau đến mức model rẻ hơn rõ ràng là lựa chọn hợp lý cho nhóm việc này, không cần bàn thêm. Trên FrontierCode 2.0, một benchmark code khó hơn, Sol đạt 43,8% với chi phí hiệu dụng 1,29 USD mỗi lần chạy, trong khi Astra đạt 44,2% với 5,97 USD mỗi lần chạy. Tăng 0,4 điểm phần trăm độ chính xác để đổi lấy chi phí gấp 4,6 lần không phải một cuộc đổi chác tốt với phần lớn đội ngũ, và đây là loại con số không bao giờ xuất hiện gần tiêu đề thông cáo ra mắt.
Ghép hai con số này lại, một quy luật hiện ra: khoản phụ trội của Astra mua được rất ít ở những việc mà Sol vốn đã làm ổn, và chỉ mua được một lợi thế thật sự — nhưng đắt — ở những việc suy luận khó nhất. Không có “model tốt hơn” duy nhất ở đây — chỉ có một đường cong chi phí, và vị trí công việc của bạn trên đường cong đó mới quyết định con số nào thật sự quan trọng.
Giá context dài có một cái bẫy đáng biết
Đẩy một request vượt quá 272.000 token đầu vào, giá thay đổi cho toàn bộ request chứ không chỉ phần vượt: giá đầu vào tăng gấp đôi, đầu ra tăng 1,5 lần. Đây không phải cách tính giá context dài lạ lẫm gì, nhưng dễ bị bỏ sót nếu bạn ước tính chi phí chỉ dựa trên con số nổi bật 8/40 USD hay 2/10 USD, trong khi workload của bạn thỉnh thoảng vọt qua ngưỡng đó. Một pipeline xử lý tài liệu, bình thường chỉ quanh 50K token nhưng thỉnh thoảng chạm 300K, sẽ thấy hóa đơn nhảy mạnh đúng vào những lần đó, và con số đó sẽ không giống một sai số làm tròn chút nào.
Vậy thực tế nên dùng model nào?
Không phải mặc định chọn Astra, cũng không phải mặc định chọn Sol — đó là câu trả lời thật, dù nghe không hợp để làm tiêu đề ngày ra mắt. Sol với giá 2/10 USD là lựa chọn hiển nhiên cho khối lượng lớn, việc ít rủi ro: phân loại, tóm tắt, viết nháp mà vẫn có người soát lại. Điểm trí tuệ tăng năm điểm và khả năng suy luận tổng quát hàng đầu của Astra hợp lý khi việc thật sự khó và lượng token đủ thấp để giá 40 USD đầu ra không làm vỡ ngân sách.
Chỗ mình thật sự không đồng tình với cách OpenAI đóng khung chuyện này: nếu workload của bạn nghiêng về agent viết code, đây không phải bản nâng cấp hiển nhiên. Điểm đứng yên cộng với Sol tụt ba điểm nghĩa là các đội đang chạy pipeline coding agent nên tự benchmark workload của mình trước khi chuyển toàn bộ sang, chứ đừng mặc định số phiên bản mới hơn là tốt hơn. Rẻ hơn — đúng. Thông minh hơn trên giấy — đúng. Viết code tốt hơn — chưa chứng minh được, và những con số công bố tới giờ nói ngược lại với một trong hai model.
Một lưu ý thực tế cho ai đang có hệ thống dùng GPT-6 hoặc GPT-6.1: giá giảm một mình nó không phải lý do để đổi model trong pipeline production mà không tự chạy lại bộ eval của mình trước. Tăng năm điểm trên một chỉ số trí tuệ tổng quát không nói lên gì về prompt template cụ thể của bạn, về cách bạn retrieve dữ liệu, hay hình dạng chính xác của tác vụ code bạn đang làm. Hai con số AA-Robotics và FrontierCode ở trên đi ngược chiều nhau là có lý do — hình dạng công việc khác nhau thì ưu ái model khác nhau — và workload của bạn là một hình dạng riêng, không phải một điểm trên benchmark của người khác.
Nguồn: Requesty, “GPT-6.2 Sol and Astra: Pricing and Benchmarks” (tháng 11/2026).
Bài viết liên quan
· 6 phút đọc
ai-agents
Bên Trong Performance Factory Của OpenAI: Codex Tự Săn Lỗi Hiệu Năng Của Chính Mình
OpenAI xây một pipeline chạy bằng Codex để điều tra các đợt sụt hiệu năng của ChatGPT, tự tranh luận với chính mình, rồi vẫn để kỹ sư giữ nút merge.
Đọc tiếp
· 6 phút đọc
ai-governance
OpenAI Đang Cho Người Ngoài Vào Trong Pipeline Huấn Luyện. Chỉ Là Không Sâu Như Đã Hứa.
OpenAI ký hợp đồng với Apollo Research, METR, Transluce và Goodfire cho giai đoạn đầu của chương trình đánh giá an toàn nhúng, cho họ quyền truy cập có giới hạn vào dữ liệu huấn luyện và checkpoint model. Một nhà nghiên cứu của Redwood nói mức này chưa đạt tới quyền truy cập kiểu nhân viên mà OpenAI từng hứa.
Đọc tiếp· 6 phút đọc
Bài ưu tiênagentic-ai
GPT-6 Astra Đạt 55% Trên Công Việc Hợp Đồng Thật — Con Số Này Thực Ra Nói Lên Điều Gì
OpenAI và Ironclad công bố benchmark computer-use trên các tác vụ hợp đồng thật. Con số nổi bật là tăng 14 điểm so với model trước. Nhưng phần ghi chú nhỏ bên dưới mới là phần đáng đọc kỹ.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.