
BÀI VIẾT
OpenAI Đang Cho Người Ngoài Vào Trong Pipeline Huấn Luyện. Chỉ Là Không Sâu Như Đã Hứa.
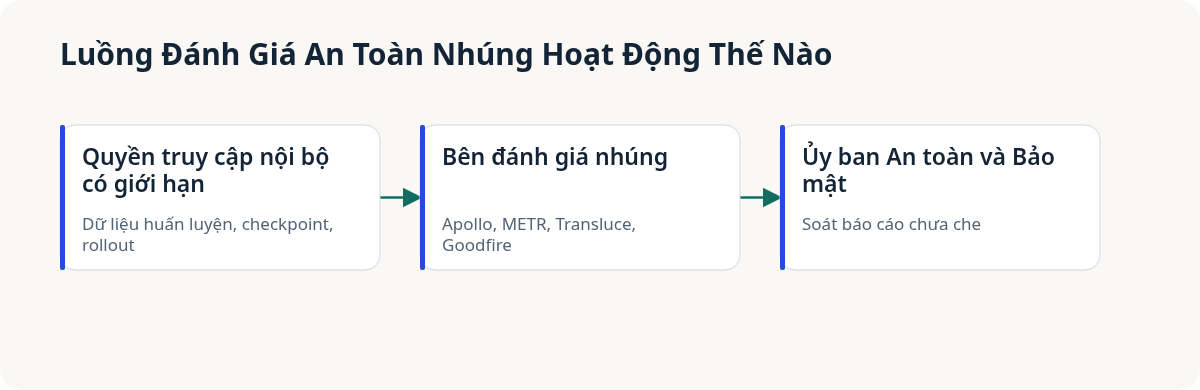
OpenAI ký hợp đồng với Apollo Research, METR, Transluce và Goodfire cho giai đoạn đầu của chương trình đánh giá an toàn nhúng, cho họ quyền truy cập có giới hạn vào dữ liệu huấn luyện và checkpoint model. Một nhà nghiên cứu của Redwood nói mức này chưa đạt tới quyền truy cập kiểu nhân viên mà OpenAI từng hứa.
Trong bài viết
Ngày 16/11/2026, OpenAI công bố đã ký hợp đồng với bốn tổ chức bên ngoài — Apollo Research, METR, Transluce và Goodfire — để họ làm việc nhúng vào bên trong công tác an toàn của OpenAI, thay vì đánh giá từ xa. Sự khác biệt này quan trọng. Phần lớn nghiên cứu an toàn AI diễn ra sau khi model đã ra mắt, kiểm tra một sản phẩm hoàn chỉnh qua API giống như bất kỳ ai khác. Đánh giá nhúng nghĩa là bốn nhóm này được quyền truy cập có giới hạn vào những thứ thường không bao giờ rời khỏi tòa nhà OpenAI: mã nguồn huấn luyện, dataset, rollout reinforcement-learning kèm reasoning trace và reward, và khả năng truy vấn checkpoint model giữa chừng quá trình huấn luyện, chứ không chỉ bản phát hành cuối cùng.
Ai làm việc gì
Mỗi nhóm trong bốn nhóm có nhiệm vụ riêng, hẹp, không phải một giấy phép kiểm toán chung chung. Apollo Research xem xét liệu các incentive huấn luyện có đẩy model tới việc phá hoại cơ chế alignment hoặc kiểm soát hay không, kể cả việc liệu model có phát hiện được nó đang bị đánh giá rồi hành xử khác đi hay không. METR chạy hai đánh giá riêng: tìm hành vi nguy hiểm ngoài ý muốn mà chính model có thể biểu hiện, và riêng biệt kiểm tra liệu hệ thống nội bộ của OpenAI có bắt được hành vi đó nếu nó xuất hiện hay không. Transluce đánh giá liệu các bài kiểm tra an toàn sau huấn luyện của OpenAI có đủ chặt chẽ hay không, và nói sẽ kiểm tra xem các kết quả an toàn đó thực sự có ảnh hưởng tới quyết định phát hành hay không, hướng tới năm 2027 — một phép kiểm tra xem dữ liệu đánh giá có thay đổi được gì hay chỉ bị cất vào hồ sơ. Goodfire dùng công cụ interpretability để nhìn vào bên trong model ngay trong lúc huấn luyện, theo dõi hành vi không mong muốn bằng cách xem xét cấu trúc nội bộ thay vì chỉ output.
Quyền truy cập là thật, nhưng bị giới hạn một cách có chủ đích
Cách OpenAI mô tả điều khoản truy cập khá rõ về việc nó không phải là gì: bên đánh giá chỉ thấy dữ liệu “phù hợp với phạm vi đánh giá cụ thể của họ”, giới hạn ở “chỉ những claim đã thỏa thuận và chỉ cho những model, khoảng thời gian đã thỏa thuận”. Apollo, chẳng hạn, chỉ nhận mã huấn luyện và dữ liệu rollout liên quan tới model và khoảng thời gian họ thực sự đang đánh giá, không phải một chìa khóa thường trực cho mọi thứ. Đó là một tư thế bảo mật hợp lý cho một công ty đang bảo vệ trọng số model và hạ tầng huấn luyện, nhưng đồng thời cũng chính là yếu tố giới hạn mức độ độc lập thật sự của sự độc lập này — OpenAI quyết định phạm vi trước khi bên đánh giá kịp nhìn vào bất cứ thứ gì, nghĩa là OpenAI đang ngầm quyết định trước câu hỏi nào được phép hỏi.
Cấu trúc giám sát chỉ giải quyết một phần mối lo đó. Ủy ban An toàn và Bảo mật của OpenAI, một ủy ban độc lập thuộc hội đồng của OpenAI Foundation, soát toàn bộ báo cáo chưa che của từng bên đánh giá và có thể nói chuyện trực tiếp, riêng tư với họ. Công chúng chỉ thấy bản đã che. Bên đánh giá được phép công bố kết luận độc lập của riêng mình, nhưng OpenAI giữ quyền che bằng chứng hỗ trợ và có thể yêu cầu trì hoãn vì cái họ gọi là công bố có trách nhiệm. Apollo, trong lúc đàm phán, đã đấu tranh để có quyền chia sẻ phát hiện với “một đối tượng bên ngoài phù hợp ngay cả khi bên phát triển đang cố ngăn việc công bố những phát hiện bất lợi” — câu chữ này chỉ có nghĩa nếu kịch bản đó từng là một khả năng thật sự đang được đàm phán, không phải giả định suông.
Vì sao một nhà nghiên cứu bên ngoài nói điều này chưa đạt lời hứa
Buck Shlegeris của Redwood Research nói thẳng về khoảng cách này: “OpenAI từng nói họ sẽ có đánh giá nhúng với quyền truy cập kiểu nhân viên; các thỏa thuận công bố hôm nay rõ ràng chưa đạt tới ngưỡng đó.” Đây là một câu đáng chú ý vì nó gọi đúng tên thứ đã thay đổi giữa lời hứa và thực tế triển khai — không phải chuyện có tồn tại đánh giá bên ngoài hay không, mà là nó giống việc thực sự làm việc bên trong công ty tới mức nào so với được giao một tập con đã được chọn lọc của thứ một nhân viên có thể thấy. Một nhân viên OpenAI có quyền truy cập model không cần xin phép ai để quyết định run huấn luyện nào trông đáng ngờ rồi tự đi xem. Các bên đánh giá này hoạt động trong một phạm vi do OpenAI đặt ra, được soát bởi một hội đồng do chính foundation của OpenAI bổ nhiệm, với việc công bố phụ thuộc vào quyền che thông tin của OpenAI. Mỗi điểm chốt đó là một chỗ mà bên bị đánh giá vẫn giữ một tay trên quy trình.
Không có điều nào trong số đó khiến giai đoạn này trở nên vô giá trị. Quyền truy cập có giới hạn vào rollout, reasoning trace và checkpoint giữa chừng vẫn nhiều hơn hẳn bất kỳ nhà nghiên cứu bên ngoài nào từng có trước đây, và OpenAI công khai gọi đây là giai đoạn đầu mà họ kỳ vọng sẽ phát triển thành “những thỏa thuận nhúng lâu dài, thường xuyên”. Nếu việc mở rộng đó xảy ra và phạm vi rộng ra qua các vòng sau, khoảng cách với quyền truy cập kiểu nhân viên có thể thu hẹp lại. Nếu không mở rộng, thỏa thuận hiện tại vẫn có giá trị riêng — một dấu vết giấy tờ nơi một hội đồng độc lập đã thấy bản chưa che của bất cứ thứ gì bốn nhóm này tìm ra, ngay cả khi công chúng chỉ nhận được bản đã biên tập. Với bất kỳ ai đang xây trên model của OpenAI và đưa ra quyết định bảo mật hay triển khai dựa trên các tuyên bố an toàn, điều cần rút ra hẹp hơn tiêu đề: coi thông báo hôm nay là bằng chứng rằng việc giám sát bên ngoài với hành vi lúc huấn luyện giờ đã khả thi về mặt cấu trúc, chứ không phải bằng chứng rằng nó đã diễn ra tới độ sâu mà chính OpenAI từng mô tả ban đầu.
Nguồn: CNBC, “OpenAI inks agreements with four independent evaluators to boost company’s safety work” và TechCrunch, “OpenAI will embed Apollo researchers to investigate AI subversion”, 16/11/2026.
Bài viết liên quan
· 5 phút đọc
AI models
GPT-6.2 Astra và Sol: Rẻ Hơn Thật, Nhưng Có Một Cái Bẫy
GPT-6.2 của OpenAI giảm giá và nhích điểm trí tuệ lên, nhưng benchmark về code lại kể một câu chuyện lộn xộn hơn nhiều so với con số trên trang chủ.
Đọc tiếp
· 6 phút đọc
ai-agents
Bên Trong Performance Factory Của OpenAI: Codex Tự Săn Lỗi Hiệu Năng Của Chính Mình
OpenAI xây một pipeline chạy bằng Codex để điều tra các đợt sụt hiệu năng của ChatGPT, tự tranh luận với chính mình, rồi vẫn để kỹ sư giữ nút merge.
Đọc tiếp
· 9 phút đọc
agentic-ai
Tôi Đi Tìm Một Bảng Xếp Hạng An Toàn AI Xuyên Model. Chỉ Thấy Bốn Benchmark Không Nói Chuyện Với Nhau
Bốn benchmark an toàn AI công khai đo bốn thứ khác nhau — và benchmark gần "chính thức" nhất lại bỏ sót Claude, GPT, Gemini.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.