
BÀI VIẾT
XERJ: Công cụ tìm kiếm AI mã nguồn mở và sự thật đằng sau những con số
Một công cụ tìm kiếm mã nguồn mở đang tăng trưởng nhanh quảng cáo giảm 40 lần số token so với grep cho agent lập trình AI. Benchmark của chính dự án lại cho ra con số 2,7 lần. Đây là những gì repo, tài liệu bảo mật và case study thực sự cho thấy.
Trong bài viết
Tóm tắt trong 60 giây
XERJ (github.com/xerj-org/xerj) là một máy chủ tìm kiếm cục bộ, mã nguồn mở theo giấy phép Apache-2.0, chạy dưới dạng một file binary duy nhất, lập chỉ mục bất kỳ thư mục nào — code, tài liệu, log, PDF — để agent lập trình AI tìm đúng đoạn văn bản theo nghĩa thay vì phải grep và đọc nguyên cả file vào context. Dự án còn rất trẻ (tạo ngày 2026-06-30, đã đạt 6.976 sao và 355 fork) nhưng vẫn đang phát triển tích cực, commit gần nhất là một ngày trước khi bài này được viết. Mô tả một dòng trên GitHub của chính dự án quảng cáo “giảm 40 lần số token so với grep.” Nhưng benchmark do chính dự án công bố, chạy trên một agent lập trình thật với 8 tác vụ ở 4 ngôn ngữ, đo được mức giảm thực tế là 2,7 lần số token đầu ra so với agent dùng grep, ở cùng tỷ lệ giải đúng 16/16 — vẫn là một cải thiện thật, có thể lặp lại, chỉ là không đúng con số ghi trên nhãn. Nếu đội của bạn đang chạy agent lập trình AI trên code riêng tư hoặc mới viết gần đây, đây là thứ đáng thử trong 20 phút trước khi tin vào bất kỳ con số nào trong hai con số trên.
Vấn đề mà công cụ này nhắm tới
Một agent lập trình AI chỉ dựa vào trí nhớ sẽ thử đi thử lại vô tận với bất kỳ API hay quy ước nội bộ nào nó chưa từng học — không có gì để tra cứu, nên nó đoán. Grep giải quyết được phần “không có gì để tra cứu” nhưng không giải quyết được chi phí: nó tìm ra các file khả nghi, rồi agent phải đọc nguyên cả file vào context để tìm ra dòng nào thực sự liên quan, việc này tốn token rất nhanh với bất kỳ file nào lớn hơn một chút. Với một đội đang chạy agent trên một monorepo riêng tư lớn, hoặc trên code viết sau thời điểm model được huấn luyện, chi phí token đó cộng dồn qua từng tác vụ, từng ngày. Mục tiêu của XERJ là rút ngắn bước “tìm đúng dòng” từ việc đọc nguyên file xuống việc trả về đúng đoạn văn bản, lập chỉ mục một lần và truy vấn nhiều lần, qua một giao diện tương thích với các client Elasticsearch hiện có.
Một tình huống cụ thể
Hình dung một đội kỹ sư 12 người đang duy trì một dịch vụ billing nội bộ viết bằng Rust đã 5 năm tuổi, với các quy ước và thư viện helper mà chưa model công khai nào từng thấy. Mỗi lần ai đó nhờ Claude Code hay Cursor thêm một tính năng, agent hoặc bịa ra một hàm trông hợp lý nhưng không khớp với pattern thật của codebase, hoặc tốn hàng chục nghìn token đọc các file lân cận để tìm ra hàm thật. Đội này không cần một sản phẩm chat mới — họ cần agent hiện có ngừng đọc cả cái kho để tìm một con ốc vít. Đó chính là trường hợp hẹp mà benchmark của XERJ được xây để đo, và cũng là trường hợp mà mức tiết kiệm ít có khả năng là chiêu trò marketing nhất: code mà model không có cơ hội đã biết từ lúc huấn luyện.
Một phép thử trước khi dùng thật, không phải kết luận cuối cùng
Trước khi đưa công cụ này vào dùng hằng ngày, phép thử rẻ nhất là chạy lại đúng dạng so sánh mà XERJ công bố nhưng trên codebase của chính bạn, thay vì tin vào con số quảng cáo của bất kỳ bên nào: lấy 8-10 ticket thật mà đội bạn đã từng giải, chạy agent theo ba cách (chỉ trí nhớ, grep, có XERJ lập chỉ mục), ghi lại số token và tỷ lệ đúng/sai cho từng cách, rồi so với cách đội bạn thực sự đã giải. Phép thử này chưa được thực hiện cho bài viết này — các con số của XERJ được trích từ case study do chính dự án công bố, không phải từ kiểm chứng độc lập ở đây. Con số nên dùng để quyết định có áp dụng hay không không phải là dòng tagline trên repo, mà là mức tiết kiệm token có còn đúng trên tỷ lệ giải đúng thực tế của codebase bạn, chứ không chỉ trên một bộ dữ liệu demo.
Cài đặt và chạy thử
- Một file binary tĩnh duy nhất, không cần JVM, cài bằng một dòng lệnh:
curl -fsSL https://xerj.org/get | sh(github.com/xerj-org/xerj). - Khởi động một node cục bộ, lập chỉ mục một dự án, rồi truy vấn:
xerj --insecure --data-dir ./data &, sau đóxerj autoindex ~/my-project, rồixerj search "how do we rotate the WAL segment"để nhận các đoạn văn bản theo thứ hạng dạng file:line (cùng nguồn). - Hai lệnh CLI khác đáng chú ý:
xerj def "symbol_name"để nhảy tới định nghĩa (file:line kèm chữ ký hàm), vàxerj gain, được dự án mô tả là báo cáo công cụ thực sự đã giúp được gì, “đếm thật, không phải ước lượng” (cùng nguồn). - Cùng một cơ chế lập chỉ mục, bốn mục đích sử dụng khác được liệt kê: hỏi-đáp và RAG trên codebase với trích dẫn file:line thay vì liệt kê thư mục; audit bảo mật truy vấn các pattern nguy hiểm và secret trên mọi loại file; phân tích log/sự cố qua các chỉ mục có kiểu dữ liệu rõ ràng với các phép tổng hợp kiểu Elasticsearch; và bộ nhớ dài hạn cho agent, lưu theo namespace dưới
/_memory, truy hồi theo nghĩa ở phiên làm việc sau (cùng nguồn).
Cách các phần thực sự ghép lại với nhau
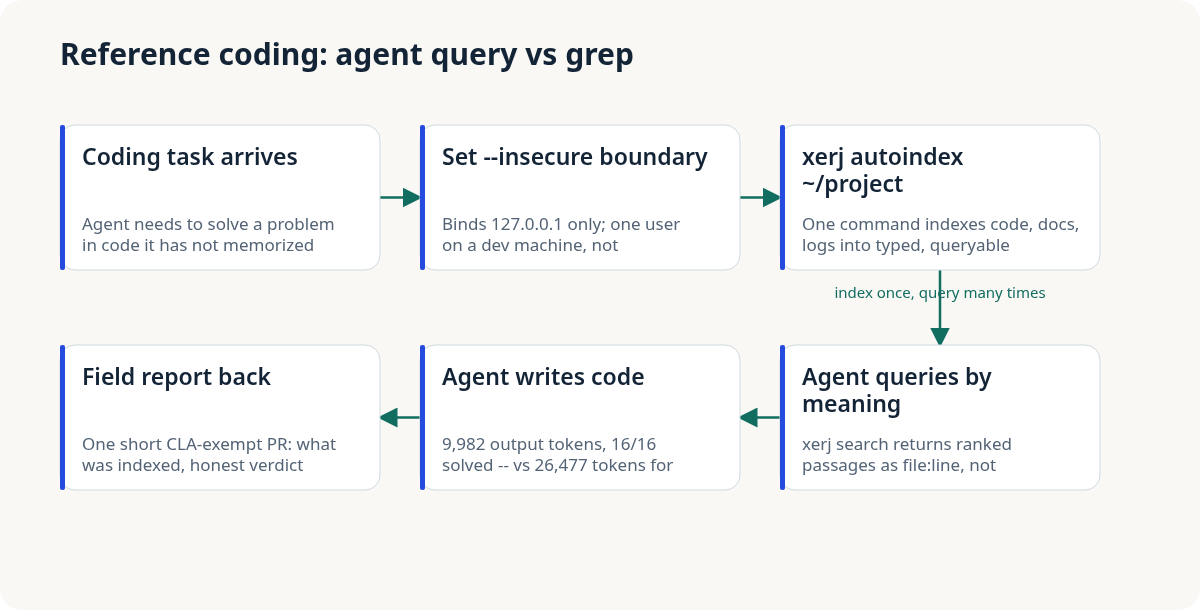
Case study của chính XERJ đo cả vòng lặp từ đầu đến cuối: 8 tác vụ, 4 ngôn ngữ, 16 lần chạy cho mỗi phương án, đếm token đầu ra thật từ claude -p. Chỉ dùng trí nhớ tốn 260.916 token đầu ra và 11,18 đô la, giải đúng 11/16. Agent dùng grep tốn 26.477 token và 3,27 đô la, giải đúng 16/16. Agent dùng XERJ tốn 9.982 token và 1,58 đô la, cũng giải đúng 16/16 — giảm 2,7 lần số token so với grep và 26 lần so với chỉ dùng trí nhớ ở cùng tỷ lệ giải đúng, có lúc giảm tới 278 lần trên một tác vụ Java trong cùng lần chạy (xerj.org/case-studies/reference-coding). Riêng về khả năng tương thích API Elasticsearch và hiệu năng thô, dự án công bố một bảng so sánh 88 ô đối đầu trực tiếp với Elasticsearch: 55 thắng, 26 hòa, 4 thua, 3 không áp dụng, với thông lượng ghi (bulk-ingest) cao hơn 1,72 lần và dung lượng đĩa nhỏ hơn 1,61 lần (176,2 MB so với 283,0 MB của Elasticsearch) trên cùng bộ dữ liệu và phần cứng (xerj.org/benchmarks) — và dự án công khai cả các trường hợp thua chứ không chỉ khoe phần thắng.
Cái giá phải trả và những điểm dễ gãy
Hãy đọc kỹ khoảng cách giữa dòng tagline và nội dung thật trước khi trích dẫn bất kỳ con số nào trong nội bộ. Mô tả một dòng trên GitHub của chính dự án quảng cáo “giảm 40 lần số token so với grep.” Nhưng kết quả đo được trong README — benchmark có kiểm soát duy nhất mà dự án dẫn ra — là giảm 2,7 lần số token đầu ra so với agent dùng grep ở cùng tỷ lệ giải đúng 16/16 (giảm 26 lần so với chỉ dùng trí nhớ) — con số 40 lần không xuất hiện ở bất kỳ đâu trong phần kết quả đo được. Đây không phải bằng chứng của sự thiếu trung thực; các “báo cáo thực tế” (do người dùng gửi, không có kiểm soát) cho thấy mức tiết kiệm hằng ngày vào khoảng 5 lần. Nhưng đây là lời nhắc để đọc kỹ phần thân bài trước khi lặp lại con số quảng cáo của một bên nào đó như một sự thật, cùng một nguyên tắc mà blog này đã áp dụng với mọi benchmark do nhà cung cấp tự công bố khác.
Dự án nói rõ ràng về điểm mà lợi thế này biến mất: giá trị “bị giới hạn bởi khả năng ghi nhớ của model” — nó thắng trên code riêng tư, nội bộ, hiếm gặp, hoặc viết sau thời điểm huấn luyện, và trở nên “trung tính tới có hại” trên các thư viện công khai phổ biến mà model đã biết rõ. Nếu codebase của đội bạn chủ yếu là lớp kết nối quanh các framework công khai nổi tiếng, đừng kỳ vọng mức cải thiện tương tự.
Bảo mật là khoản chi phí khác cần tính trước khi dùng cho production. Chạy XERJ đòi hỏi cờ --insecure tường minh để khởi động mà không cần TLS hay xác thực API-key; ở chế độ đó, bất kỳ ai gọi được tới cổng này đều là superuser, có thể đọc hoặc xóa mọi chỉ mục, kể cả các namespace bộ nhớ của agent. Một node mới mặc định chỉ bind vào 127.0.0.1, và việc bind sang giao diện khác mà không có TLS/xác thực sẽ từ chối khởi động trừ khi được cho phép tường minh — được dự án ghi rõ là ranh giới tin cậy “một người dùng trên một máy phát triển,” không phải một tư thế bảo mật cho production (docs/SECURITY_MODEL.md). Cùng tài liệu này khá chi tiết so với một dự án mã nguồn mở còn non trẻ: mọi khẳng định về phân quyền đều được gắn với tên file và số dòng mã nguồn cụ thể, kể cả một ghi chú rằng các đoạn đường dẫn được giải mã percent-decode trước khi phân loại, chính là để một đường dẫn đã mã hóa không thể lách qua một kiểm tra viết cho dạng đã giải mã — một mức độ chặt chẽ đáng ghi nhận với một dự án mới, dù đây chỉ là mô tả về ý định của code, không phải một cuộc kiểm toán bảo mật độc lập.
Cuối cùng, điều duy nhất dự án yêu cầu đổi lại cho file binary miễn phí là một pull request “báo cáo thực tế” ngắn — bạn đã lập chỉ mục gì, dùng để làm gì, đánh giá thật của bạn, kể cả đánh giá tiêu cực — và các PR này được miễn CLA, merge mà không cần ký thỏa thuận cấp phép đóng góp; cả người và agent đều được mời gửi báo cáo (github.com/xerj-org/xerj). Đây là cách đóng góp ít rào cản, nhưng cũng có nghĩa tín hiệu tăng trưởng của dự án (số sao, số lượng báo cáo) là tự báo cáo theo thiết kế, không phải một chỉ số trung lập từ bên thứ ba.
Nguồn
- Dữ liệu metadata repository xerj-org/xerj từ GitHub API — truy cập 2026-10-17
- README của xerj-org/xerj — truy cập 2026-10-17
- Tài liệu mô hình bảo mật của XERJ — truy cập 2026-10-17
- Bảng benchmark XERJ so với Elasticsearch — truy cập 2026-10-17
- Case study lập trình tham chiếu của XERJ — tham chiếu qua README, 2026-10-17
Bước tiếp theo
Nếu đội của bạn đang cân nhắc có nên tích hợp một công cụ tìm kiếm có lập chỉ mục vào agent lập trình AI hay không, câu hỏi đáng dành năm phút không phải là dòng tagline trên repo — mà là liệu mức tiết kiệm token có còn đúng trên tỷ lệ giải đúng của codebase bạn, và liệu hệ thống triển khai của bạn có chấp nhận được ranh giới bảo mật một người dùng hiện tại trước khi mở nó ra cho cả một server dùng chung. Nếu bạn muốn hỗ trợ thiết kế một phép thử như trên dựa trên lịch sử ticket thật của đội mình trước khi áp dụng một công cụ như thế này, bộ phận tư vấn của Thuận Lương có thể giúp chạy đúng dạng thử nghiệm đó; liên hệ qua luonghongthuan.com/vi/lien-he.
Bài viết liên quan
· 12 phút đọc
AI Ideas
Magnitude: Startup YC Đặt Cược Rằng Kernel AI Tổng Quát Đang Lãng Phí Tốc Độ
Một startup từ Y Combinator làm engine chạy AI mã nguồn mở, tự nhận nhanh hơn Ollama nhờ tinh chỉnh kernel theo đúng chip của bạn. Benchmark của chính họ cho thấy mức tăng trung bình 1,3-2,2 lần, không phải khẩu hiệu 'nhanh hơn 2 lần'. Đây là những gì repo, benchmark và tài liệu thực sự cho thấy.
Đọc tiếp
· 8 phút đọc
AI Ideas
Tư vấn tự động hoá quy trình bằng AI của flowscope: Thử nghiệm tự làm trước khi trả tiền
Một startup được YC hậu thuẫn chào bán AI agent lập bản đồ quy trình và tự động hoá đúng một bước giá trị cao nhất. Đây là những gì bằng chứng công khai thực sự chứng minh được, cùng một mẫu thử nghiệm tự làm trong hai tuần bất kỳ đội nhóm nào cũng có thể chạy trước.
Đọc tiếp
· 9 phút đọc
AI Ideas
Agent AI SRE Mã Nguồn Mở Của IncidentFox: Thực Chất Bạn Nhận Được Gì
Một startup được YC rót vốn hứa hẹn agent AI sẽ tự điều tra sự cố production thay bạn. Đây là những gì repo công khai, file license và metadata GitHub thực sự cho thấy, sau khi bỏ qua trang landing page.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.