
BÀI VIẾT
Magnitude: Startup YC Đặt Cược Rằng Kernel AI Tổng Quát Đang Lãng Phí Tốc Độ
Một startup từ Y Combinator làm engine chạy AI mã nguồn mở, tự nhận nhanh hơn Ollama nhờ tinh chỉnh kernel theo đúng chip của bạn. Benchmark của chính họ cho thấy mức tăng trung bình 1,3-2,2 lần, không phải khẩu hiệu 'nhanh hơn 2 lần'. Đây là những gì repo, benchmark và tài liệu thực sự cho thấy.
Trong bài viết
Tóm tắt trong 60 giây
Magnitude (github.com/magnitudedev/magnitude) là một startup thuộc lứa Y Combinator Summer 2025, làm ra một “inference engine” (bộ máy chạy mô hình AI) mã nguồn mở (Apache-2.0, viết bằng Rust) để chạy cục bộ. Đội ngũ chỉ 2 người ở San Francisco — CEO Tom Greenwald, từng làm PM tại SimpliSafe, và CTO Anders Lie, từng là kỹ sư phần mềm tại AWS. Ý tưởng cốt lõi: các engine phổ thông như Ollama, llama.cpp hay LM Studio dùng chung một bộ “kernel” (các đoạn tính toán cấp thấp) cho mọi loại phần cứng, vì việc tinh chỉnh tay cho từng chip, từng model là quá tốn công với một đội nhỏ. Magnitude thay vào đó bỏ ra tối đa một phút cho mỗi model vừa tải về, thử nhiều cách chia nhỏ phép tính khác nhau ngay trên con chip thực tế của người dùng, rồi giữ lại cách nào nhanh nhất mà không làm thay đổi kết quả đầu ra của model. Bản benchmark do chính công ty công bố, so với cấu hình mặc định của Ollama trên 11 model mở, đo được tốc độ prefill nhanh hơn trung bình 1,32 lần và decode nhanh hơn trung bình 2,19 lần trên máy Mac M4 Pro, còn trên máy NVIDIA DGX Spark là 1,34 lần và 2,17 lần — là mức tăng thật, nhưng thấp hơn khẩu hiệu “nhanh hơn 2 lần” treo trên trang chủ, và trang benchmark cũng thẳng thắn liệt kê 3 trường hợp Magnitude chạy chậm hơn Ollama. Sản phẩm là ứng dụng desktop cho macOS, Windows, Linux kèm CLI, kết nối được với Claude Code, Codex, Cline và nhiều agent khác qua một endpoint tương thích chuẩn OpenAI. Nếu đội của bạn đã chạy model mở cục bộ cho coding agent và quan tâm đến số token/giây, nên tự đo trên khối lượng công việc thật của mình trước khi tin vào con số quảng cáo của bên nào.
Vấn đề mà sản phẩm nhắm tới
Các đội chạy model mở cục bộ quan tâm đến độ trễ trên mỗi token, nhưng engine đa dụng lại dùng chung một bộ kernel cho đủ loại phần cứng khác nhau — bộ nhớ hợp nhất của Apple Silicon, GPU rời của NVIDIA, card AMD, hay máy chỉ chạy CPU — vì tinh chỉnh tay cho từng chip là cả một dự án kỹ thuật riêng mà phần lớn đội phát triển không đủ người để làm. Hệ quả là mỗi máy đều đang bỏ phí một phần tốc độ mà một lượt tinh chỉnh riêng cho máy đó, chỉ cần làm một lần, có thể lấy lại được. Cược của Magnitude là biến chi phí tinh chỉnh tay đó thành một bước tự động, chạy một lần cho mỗi model trên mỗi máy, thay vì một lần cho mỗi phiên bản engine. Giả thuyết khách hàng ở đây khá hẹp và cần nói rõ: đó là các lập trình viên và đội nhỏ đã quyết định chạy inference cục bộ — vì lý do chi phí, bảo mật dữ liệu hoặc cần chạy offline — và đủ nhạy cảm với độ trễ để quan tâm đến mức tăng tốc đo được dao động 0,9-3,5 lần tùy model, chứ không phải nhóm người chưa từng dùng inference cục bộ.
Một tình huống cụ thể
Hình dung một đội nhỏ đang chạy Qwen hoặc Gemma cục bộ qua Ollama để phục vụ một coding agent nội bộ, trên máy Mac Studio hoặc một máy NVIDIA DGX Spark dùng chung, vì không muốn code nội bộ lọt ra ngoài qua các prompt gửi đi. Agent chạy chậm hơn cả API trên mây mà họ đang cố tránh trả tiền, nhưng quay lại dùng model trên mây thì mất hết ý nghĩa ban đầu. Thay vào đó, họ cài ứng dụng desktop của Magnitude, chạy bước thiết lập một lần cho mỗi model, rồi trỏ base URL của agent đang dùng sang endpoint tương thích OpenAI của Magnitude thay vì của Ollama — giữ nguyên prompt, giữ nguyên agent, giữ nguyên trọng số model, chỉ đổi engine chạy bên dưới. Các lựa chọn thay thế hiện có gồm Ollama, dùng thẳng llama.cpp, LM Studio, và các lựa chọn cấp server như vLLM; chính FAQ của Magnitude cũng thừa nhận tất cả đều dùng kernel đa dụng vì lý do nêu trên. Điểm khác biệt của Magnitude không nằm ở một model mới hay một framework agent mới — mà là một lớp inference có thể thay thế trực tiếp, với lời hứa vượt các đối thủ về tốc độ thô trên cùng model mở, trong khi vẫn miễn phí, mã nguồn mở và chạy hoàn toàn cục bộ.
Một phép thử nhu cầu trước khi dùng thật, không phải kết luận cuối cùng
Hiện tại phạm vi của Magnitude là thay thế engine inference trên một máy hoặc một server đơn lẻ — đây không phải là một dịch vụ inference được vận hành (hosted/managed). Không có dashboard cho cả đội, không có tính phí theo lượng dùng, và đáng chú ý là trang web của công ty không hề có trang báo giá. Đó là một điểm khởi đầu hẹp và cụ thể: trở thành thứ nhanh nhất mà một lập trình viên có thể trỏ client tương thích OpenAI của mình vào, trên phần cứng họ đã có sẵn. Trước khi dùng thật, phép thử rẻ nhất (bài viết này chưa tự chạy thử, vì số liệu của Magnitude lấy từ benchmark do chính họ công bố, không phải kiểm chứng độc lập ở đây) là: lấy một model đang chạy qua Ollama, tải model tương đương vào Magnitude, trỏ agent thật của bạn vào cả hai endpoint với cùng 10-20 prompt thực tế, rồi ghi lại số token/giây đo thực tế cùng việc đầu ra có đủ giống nhau để tin dùng hay không. Con số quyết định việc có nên dùng hay không không phải là mức trung bình mà bên nào quảng cáo — mà là liệu mức tăng tốc có giữ được trên đúng model, đúng phần cứng, đúng prompt và đúng mức lượng tử hóa của bạn hay không, vì chính mẫu 11 model của Magnitude đã dao động từ giảm tốc 0,91 lần đến tăng tốc 3,51 lần tùy model.
Cách cài đặt và chạy thử
- Ứng dụng desktop kèm CLI cho macOS, Windows, Linux. Cách cài trên Linux (chạy không giao diện/trên server) theo tài liệu: tải file cài .deb, rồi
sudo apt install ./magnitude-desktop.deb, sau đómagnitude server setup, lệnh này đăng ký Magnitude thành một dịch vụ systemd (LaunchDaemon trên macOS) và in ra một khóa truy cập mạng được sinh tự động (docs.magnitude.dev/remote-server). - Server lắng nghe ở cổng 10100 với một endpoint tương thích OpenAI tại
http://SERVER_IP:10100/inference/v1, dùng khóa truy cập làm API key và đúng ID model đã tải làm tên model — nên Claude Code, Codex, Cline, Oh My Pi, hay bất kỳ script tự viết nào tương thích client OpenAI đều có thể trỏ vào chỉ bằng cách đổi một dòng base URL (cùng nguồn). - Quản lý model qua một bộ lệnh CLI nhỏ:
magnitude hardwaređể nhận diện máy,magnitude catalog recommendations --preference balanced --limit 5để gợi ý model,magnitude catalog pull MODEL_IDđể tải về và kích hoạt bước tự tinh chỉnh, cùngmagnitude models status MODEL_ID/magnitude models load MODEL_IDđể kiểm tra hoặc tải trước vào bộ nhớ (cùng nguồn). - Danh mục model tính đến thời điểm viết bài có 19 model, từ model dense 4B đến một model hỗn hợp chuyên gia (MoE) 180B với 6B tham số hoạt động, trải khắp Qwen, Google Gemma 4, Meta Muse Glimmer, OpenBMB MiniCPM-V và Liquid AI, phần lớn giấy phép Apache-2.0 hoặc giấy phép cộng đồng của nhà cung cấp, cửa sổ ngữ cảnh lên tới 256K (magnitude.dev/models).
- Windows chưa có chế độ server gốc — tài liệu gợi ý bọc lệnh
magnitude servebằng NSSM để chạy như một dịch vụ Windows. Server cũng tự kiểm tra bản cập nhật khoảng mỗi giờ và cài đặt vào lúc máy rảnh, điều đáng biết trước khi đưa nó vào một pipeline chạy không giám sát (docs.magnitude.dev/remote-server).
Cách các phần thực sự ghép lại với nhau
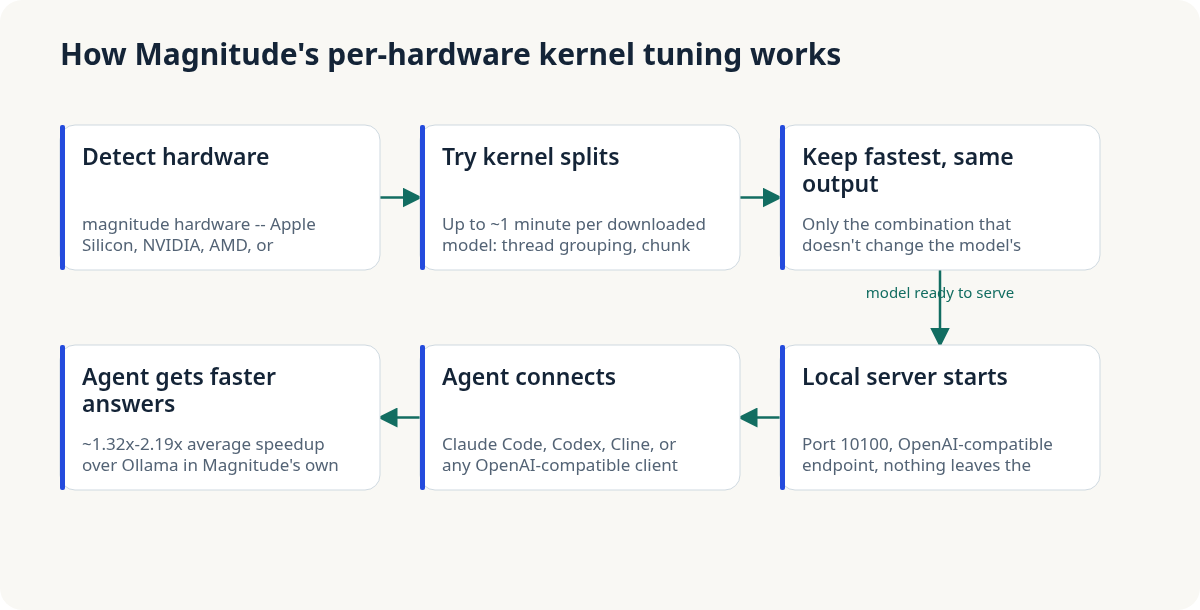
Về mặt cơ chế, FAQ của chính dự án giải thích khá cụ thể vì sao cách này hiệu quả: các engine đa dụng dùng chung một bộ kernel cho mọi chip vì tinh chỉnh tay cho từng model trên từng chip sẽ tốn quá nhiều công sức để một đội nhỏ duy trì qua từng bản phát hành. Magnitude thay vào đó bỏ ra tối đa một phút cho mỗi model vừa tải về để thử các cách chia nhỏ phép tính khác nhau — cách nhóm luồng trên GPU, kích thước khối xử lý, mức độ tải trước dữ liệu — ngay trên chip thực tế của người dùng, rồi giữ lại cách nào nhanh nhất mà vẫn cho ra đầu ra giống hệt phiên bản chưa tinh chỉnh.
Bản benchmark do công ty công bố (magnitude.dev/benchmarks) so sánh Magnitude với Ollama v0.35.1 ở cấu hình mặc định trên 11 model mở phổ biến, lượng tử hóa khoảng 4-bit, cả hai đều bật speculative decoding. Trên máy Mac mini M4 Pro 48GB so với runner MLX của Ollama: nhanh hơn trung bình 1,32 lần ở prefill và 2,19 lần ở decode. Trên máy NVIDIA DGX Spark (GB10, 128GB) so với runner llama.cpp của Ollama: nhanh hơn trung bình 1,34 lần ở prefill và 2,17 lần ở decode. Mức tăng tốc decode theo từng model trên Mac dao động từ giảm tốc 0,91 lần ở Gemma 4 E2B (tức là chậm hơn một chút, không phải nhanh hơn) đến tăng tốc 3,51 lần ở Gemma 4 31B — nên con số trung bình “khoảng 2 lần” không phải là cam kết cho bất kỳ model cụ thể nào.
Phần mô tả phương pháp đo khá thẳng thắn về giới hạn của chính nó: hai engine không chạy cùng trọng số, cùng template hay cùng cách tính số, nên đầu ra có khác nhau; trên Mac, runner MLX của Ollama chỉ “draft” được rất ít token cho ba model Gemma dù đã bật drafter, khiến con số decode của Magnitude ở phần đó bị đội lên phần nào; và trang benchmark nêu rõ 3 trường hợp Magnitude chạy chậm hơn Ollama — decode của Nemotron 3.5 trên DGX Spark, prefill của Gemma 4 E2B trên Mac, và prefill của Gemma 4 26B trên DGX Spark — đồng thời khẳng định cả ba đều được tính vào số trung bình công bố, không bị loại ra. Về việc có thực sự mã nguồn mở hay không, repo công khai (7.208 sao, 497 fork, 54 issue đang mở tính đến lúc viết, tạo ngày 2026-06-12, lần push gần nhất cùng ngày với lúc nghiên cứu bài này) thực sự chứa mã nguồn của engine: các thư mục inference, inference-v2, inference-v3, inference-v4, old-inference, CLI và ứng dụng desktop đều nằm ngay trong repo, không phải chỉ một trình cài đặt bọc quanh một file nhị phân đóng. Giấy phép là Apache 2.0, và dự án khẳng định prompt, file và model không bao giờ rời khỏi máy, không cần internet sau khi đã tải model về.
Chi phí thực tế và những điểm chưa được kiểm chứng
Bản thân phần mềm miễn phí và dùng giấy phép Apache-2.0. Chi phí thật nằm ở phần cứng bạn đã có sẵn (hoặc cần mua thêm), cộng với một lượt tinh chỉnh một lần cho mỗi model, tối đa khoảng một phút mỗi model trên mỗi máy, cộng với dung lượng ổ đĩa cho mỗi model tải về. Không có gói thuê bao, không tính phí theo token, và không phụ thuộc vào đám mây sau khi đã tải model về.
Điểm chưa được kiểm chứng: đây là một công ty chỉ 2 người, repo được tạo từ tháng 6/2026 — phát triển rất nhanh, có commit trong cùng ngày và 54 issue đang mở, nhưng đi kèm sự mong manh của một dự án như vậy nếu ai đó coi nó là thành phần sản xuất thay vì công cụ chạy cục bộ. Không có SLA, không có gói doanh nghiệp được ghi rõ ở đâu cả. Cụ thể hơn, trang web của công ty không hề có trang báo giá (magnitude.dev/pricing trả về lỗi 404), nên mô hình kinh doanh của công ty, nếu đã có, không được công bố công khai. Mọi suy đoán về việc Magnitude sẽ kiếm tiền bằng cách nào chỉ là suy đoán: các hướng khả dĩ cho một công ty có hình dạng như thế này gồm một gói server được vận hành có trả phí trong tương lai, hỗ trợ doanh nghiệp trả phí, hoặc một khoản phí cho kho model được tuyển chọn — nhưng không điều nào trong số này được xác nhận ở bất kỳ tài liệu nào của công ty tính đến lúc viết bài. Hãy coi đây là một câu hỏi còn bỏ ngỏ, không phải một lộ trình đã định.
Sự khác biệt của Magnitude cũng có giới hạn rõ ràng: nó chỉ hữu ích khi bạn đã quyết định chạy inference cục bộ. Nó không giúp được gì cho các đội đang dùng API trên mây, và toàn bộ giá trị của nó biến mất nếu điểm nghẽn thực sự của bạn là chất lượng model chứ không phải tốc độ thô tính theo token mỗi giây.
Nguồn tham khảo
- Hồ sơ công ty Magnitude trên Y Combinator — truy cập 2026-10-20
- README của magnitudedev/magnitude — truy cập 2026-10-20
- Dữ liệu metadata repo magnitudedev/magnitude qua GitHub API — truy cập 2026-10-20
- Benchmark và phương pháp đo Magnitude so với Ollama — truy cập 2026-10-20
- Tài liệu thiết lập server từ xa của Magnitude — truy cập 2026-10-20
- Danh mục model của Magnitude — truy cập 2026-10-20
Bước tiếp theo
Nếu đội của bạn đã chạy model mở cục bộ cho coding agent hoặc cho dữ liệu không được phép rời khỏi hệ thống nội bộ, câu hỏi đáng dành 20 phút để trả lời không phải là con số tăng tốc trên trang chủ của bên nào — mà là liệu mức tăng tốc đo được có giữ được trên đúng model, phần cứng và prompt của bạn, và bạn có thoải mái khi phụ thuộc vào một công ty 2 người, mới 4 tháng tuổi, chưa công bố giá, cho một phần nằm trong đường đi suy luận của hệ thống hay không. Nếu bạn cần hỗ trợ lên kế hoạch một phép thử nhu cầu như trên, hoặc cân nhắc giữa inference cục bộ và chi phí API trên mây cho đội của mình, đội tư vấn của Thuận Lương có thể giúp chạy đúng kiểu đánh giá này; liên hệ qua luonghongthuan.com/vi/lien-he.
Bài viết liên quan
· 10 phút đọc
AI Ideas
XERJ: Công cụ tìm kiếm AI mã nguồn mở và sự thật đằng sau những con số
Một công cụ tìm kiếm mã nguồn mở đang tăng trưởng nhanh quảng cáo giảm 40 lần số token so với grep cho agent lập trình AI. Benchmark của chính dự án lại cho ra con số 2,7 lần. Đây là những gì repo, tài liệu bảo mật và case study thực sự cho thấy.
Đọc tiếp
· 8 phút đọc
AI Ideas
Tư vấn tự động hoá quy trình bằng AI của flowscope: Thử nghiệm tự làm trước khi trả tiền
Một startup được YC hậu thuẫn chào bán AI agent lập bản đồ quy trình và tự động hoá đúng một bước giá trị cao nhất. Đây là những gì bằng chứng công khai thực sự chứng minh được, cùng một mẫu thử nghiệm tự làm trong hai tuần bất kỳ đội nhóm nào cũng có thể chạy trước.
Đọc tiếp
· 9 phút đọc
AI Ideas
Agent AI SRE Mã Nguồn Mở Của IncidentFox: Thực Chất Bạn Nhận Được Gì
Một startup được YC rót vốn hứa hẹn agent AI sẽ tự điều tra sự cố production thay bạn. Đây là những gì repo công khai, file license và metadata GitHub thực sự cho thấy, sau khi bỏ qua trang landing page.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.