
BÀI VIẾT
6. Tăng tốc chatbot và giữ chất lượng
Tối ưu context, output, caching, retrieval và inference theo ngân sách độ trễ, token từ đầu đến cuối.
Trong bài viết
Kỹ thuật Chatbot · Bài 6 trong 9 bài · Nguồn được đối chiếu ngày 7 tháng 10 năm 2026. Thiết kế và giả định đề xuất được phân biệt với kết quả triển khai đã đo.
Tối ưu thời gian và chi phí để hoàn thành tác vụ, không chỉ token mỗi giây. Model nhanh nhưng retrieval chậm, gọi tool lặp lại và hàng đợi tắc có thể tạo cảm giác chậm hơn model lớn với luồng xử lý tốt. Streaming giúp thấy tiến độ sớm hơn nhưng không làm phép tính miễn phí.
Đo từng giai đoạn
Ghi độ trễ client đến server, chờ hàng đợi, routing, retrieval, chạy tool, chuẩn bị prompt, time to first token, sinh token và render frontend. Dùng phân bố như p50, p95 dưới mức tải đồng thời nêu rõ. Đo cold startup riêng với inference đã warm.
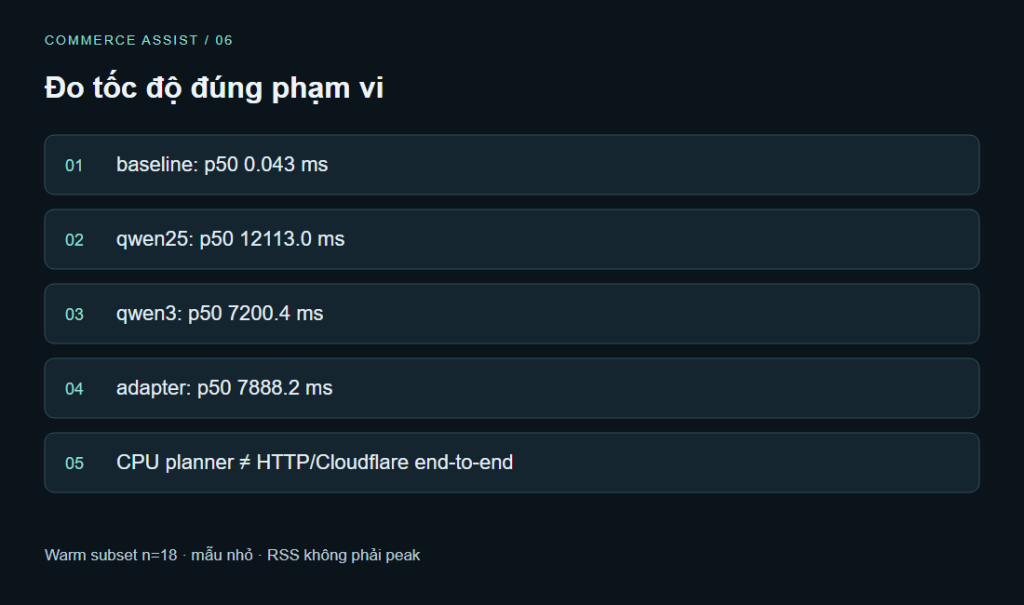
Case study routing CPU đo khoảng 12,69 ms p50 và 14,09 ms p95 cho inference local đã warm trên chuỗi fixture nhỏ. Số này chưa gồm HTTP, Cloudflare, hàng đợi, startup và sinh câu trả lời. Nạp model mất khoảng 10,5 giây. Không trình bày latency routing như latency toàn bộ hội thoại data agent. Bằng chứng thử nghiệm CPU, bằng tiếng Anh.
Loại công việc không cần thiết trước
Xác thực, kiểm tra quyền và lookup chính xác bằng code. Trả template đã duyệt cho yêu cầu điều hướng sản phẩm đơn giản khi đủ hoàn thành tác vụ. Với chỉ số, một lần gọi lập kế hoạch có kiểu dữ liệu và một lần giải thích tùy chọn có thể đủ; không thêm “thinking agent” riêng ở mọi bước khi chưa có bằng chứng.
Chạy retrieval độc lập song song chỉ khi quyền và kết quả cho phép. Giữ thao tác phụ thuộc theo thứ tự: query chờ kế hoạch hợp lệ, hành động chờ phê duyệt. Giới hạn vòng tool và retry để một tool lỗi không tạo vòng lặp tốn kém.
Đặt ngân sách context
Phân bổ prompt cho chỉ dẫn ổn định, schema tool, yêu cầu hiện tại, bằng chứng được phép và lịch sử thiết yếu. Retrieval chunk liên quan thay vì toàn thư viện. Loại đoạn trùng và dùng định danh ngắn để nguồn trích vẫn truy được.
Với hội thoại dài, duy trì trạng thái tác vụ có cấu trúc: workspace, chỉ số, kỳ thời gian và câu hỏi chưa giải quyết. Tóm tắt lịch sử bằng model có thể bỏ sót ràng buộc, nên giữ quyền và định danh quan trọng trong trạng thái tin cậy. Test chất lượng sau khi nén thay vì mặc định ít token luôn tốt hơn.
Giới hạn độ dài đầu ra theo tác vụ. Giải thích chỉ số ngắn hiếm khi cần bài luận dài. Dùng bảng cho các dòng và tệp tải cho kết quả lớn. Reasoning token ẩn cũng có thể ảnh hưởng usage provider; dùng đúng nhóm token bị tính phí thay vì chỉ đếm chữ hiển thị.
Hiểu mỗi cache tiết kiệm gì
| Cache | Công việc tránh lặp | Ranh giới cần có |
|---|---|---|
| Retrieval cache | Tìm lại dữ liệu không đổi | Tenant, quyền truy cập, phiên bản index |
| Cache kết quả chỉ số | Query database đã duyệt lặp lại | Tenant, phiên bản chỉ số, bộ lọc, snapshot |
| Prefix/KV cache | Xử lý lại prefix prompt | Cô lập runtime và cơ chế cache được hỗ trợ |
| Cache câu trả lời | Sinh lại toàn bộ câu trả lời | Đầy đủ bằng chứng, quyền và cấu hình trả lời |
Không chia sẻ câu trả lời riêng của một tenant chỉ vì người khác hỏi câu gần nghĩa. Kiểm tra quyền lại khi cache hit và vô hiệu hóa khi quyền hoặc phiên bản nguồn đổi. TTL đơn thuần không xử lý được quyền đã bị thu hồi.
Automatic prefix caching của vLLM dùng lại phép tính prefix đủ điều kiện; nó không bỏ được công việc sinh câu trả lời mới. Lợi ích phụ thuộc mức tái sử dụng prompt và model/runtime triển khai. Tài liệu prefix caching của vLLM.
Tài liệu caching hiện tại của OpenAI phân biệt dòng model mới, cache read và cache write có phí. Prefix giống chính xác và thiết lập request có vai trò quan trọng. Đo usage và hóa đơn thực tế, nhất là prompt ít tái sử dụng, thay vì áp dụng hệ số “rẻ hơn 90%” cho mọi trường hợp. Tài liệu prompt caching của OpenAI.
Tối ưu runtime sau luồng request
Đánh giá quantization theo bộ nhớ, throughput và chất lượng tác vụ cùng lúc. Đặt context tối đa thực tế thay vì luôn dự phòng cửa sổ lớn nhất model quảng cáo. Batch serving có thể tăng tận dụng tài nguyên nhưng hàng đợi quá tải làm người dùng chờ lâu hơn. Đặt admission limit theo tenant và thời gian chờ tối đa.
Speculative decoding có thể hữu ích trong triển khai phù hợp nhưng có thể thêm draft model và độ phức tạp vận hành. Vì dự án muốn giảm phụ thuộc model, trước tiên hãy thử context ngắn hơn, đầu ra giới hạn, prefix reuse và model chính vừa kích thước.
Hiển thị việc hủy và quá tải
Nút Dừng nên dừng công việc khi backend hỗ trợ. Nếu thread hay tool bên ngoài tiếp tục sau khi client ngắt, vẫn tính tài nguyên của nó đến khi kết thúc. Nếu không, request bị hủy có thể vượt concurrency cap dự kiến. Demo hiện tại giữ cơ chế tính này.
Trả trạng thái bận có ý nghĩa, hướng dẫn retry và UI có thể khôi phục. So sánh chất lượng và chi phí tác vụ thành công trước, sau mỗi tối ưu. Mục tiêu release là làm đúng nhanh hơn dưới tải thực tế, giữ căn cứ và cô lập tenant.
Thực hành: ngân sách latency cho một lượt phân tích
Với Commerce Assist, một lượt gồm lập plan, một query được duyệt và giải thích. Ngân sách nối tiếp đề xuất có thể dành 50 ms cho xác thực/validation, 150 ms queue, 250 ms retrieval khi cần, 600 ms planning, 150 ms query và 900 ms giải thích: tổng 2.100 ms. Đây là phân bổ giả định, chưa phải p95 đo được. Không cộng đơn giản p95 từng bước để suy ra p95 toàn luồng.
Đo clock request từ ingress đến hoàn tất, dùng span tìm bước chiếm phần lớn. Nếu queue mất ba giây dưới tải, giảm 20 ms parse JSON không giải quyết vấn đề. Nếu sinh giải thích chậm nhất, rút câu trả lời và test metric card xác định có đủ mà không cần lần gọi generation không.
Ngân sách token trước và sau
| Thành phần | Token đầu giả định | Token gọn đề xuất | Thay đổi |
|---|---|---|---|
| Chỉ dẫn | 1.000 | 600 | Bỏ yêu cầu lặp |
| Schema tool | 2.500 | 700 | Chỉ cung cấp tool tác vụ được phép |
| Bằng chứng | 5.000 | 1.500 | Chunk liên quan, bỏ trùng |
| Lịch sử | 3.000 | 500 | Trạng thái tin cậy + ngữ cảnh thiết yếu |
| Yêu cầu hiện tại | 200 | 200 | Giữ yêu cầu người dùng |
| Tổng | 11.700 | 3.500 | Giảm khoảng 70,1% input token |
Phép tính minh họa ngân sách, chưa phải tối ưu đã đạt. Validate bằng tokenizer từng ứng viên vì tiếng Anh, Việt token hóa khác nhau. Chạy lại cùng bộ câu trả lời sau nén. Theo dõi lỗi thiếu bằng chứng và hiểu sai câu tiếp theo, không chỉ giảm input.
Cache key phản ánh ranh giới hiệu lực
Key cache chỉ số cần tenant, phiên bản quyền, phiên bản chỉ số, kỳ chuẩn hóa, grouping, tiền tệ, snapshot. Cache câu tài liệu còn phụ thuộc phiên bản document/index, ngôn ngữ và policy trả lời. Hash bản serialize chuẩn để key hữu hạn. Không log text nhạy cảm nguyên văn chỉ vì đã dùng tạo key.
key_material = {
    "tenant": authenticated_tenant,
    "scope_version": trusted_scope_version,
    "metric_version": "net_revenue_v1",
    "period": ["2026-09-01", "2026-10-01"],
    "group_by": "channel",
    "currency": "USD",
    "snapshot": approved_snapshot_id
}
# Canonically serialize and hash. Reauthorize before returning a cached result.
Quyền tài liệu đổi phải vô hiệu hóa hoặc bỏ qua kết quả cũ dù TTL còn hạn. Test beta không lấy được response cache của alpha. Prefix cache provider khác result cache của ứng dụng; cấu hình cô lập và billing riêng.
Hiểu queue trước khi tăng concurrency
Định luật Little liên hệ công việc đang xử lý trung bình, throughput và thời gian trung bình trong hệ ổn định: L = λW. Hai request mỗi giây, thời gian lưu trung bình hai giây thì trung bình có bốn request trong hệ. Công thức không cho peak concurrency an toàn, không tính burst, không biến trung bình thành bảo đảm p95. Dùng kiểm tra sơ bộ rồi đo tải, bộ nhớ.
Test lưu lượng đều và burst ngắn riêng. Ghi request nhận, từ chối, timeout, hủy, queue time, memory. Tăng queue có thể chỉ giấu quá tải bằng thời gian chờ dài. Ưu tiên queue giới hạn và trạng thái bận rõ thay vì để request chờ lâu rồi lỗi.
Thứ tự tối ưu có kỷ luật
Trước hết bỏ model call không cần. Giới hạn bằng chứng, tool, lịch sử, output. Thêm cache cô lập đúng. Sau đó chỉnh kích thước model, quantization, serving. Chỉ thêm cơ chế decoding nếu số đo chứng minh đáng. Mỗi thay đổi giữ cấu hình trước và so chất lượng, latency, chi phí thành công toàn luồng.
Đầu ra là trace trước/sau trên cùng workload, gồm số lỗi. Ảnh chụp happy path nhanh hơn chưa chứng minh cải thiện production.
Xem quan hệ hàng đợi và giả định trong bài giảng MIT về định lý Little.
Từ bài viết đến thử nghiệm chạy được
Benchmark và training là thử nghiệm trên dữ liệu giả lập do tác giả xây dựng, có các template tương quan. Không chứng minh tương đương model lớn hoặc chất lượng trên dữ liệu khách hàng. Model sinh plan được đo offline; demo công khai dùng baseline có kiểm soát. Benchmark: đã hoàn thành bốn candidate. LoRA: completed, 64/64 bước.
Lộ trình và kết quả thực nghiệm · Thử demo với dữ liệu giả lập · Tải code minh họa
Bài học từ triển khai này
Không cộng p50 CPU planner vào p95 của mạng rồi gọi đó là độ trễ người dùng. Đo cold start riêng, warm subset riêng và thời gian HTTP public riêng. Không có hosted fallback trong demo; ngoài phạm vi phải hỏi lại hoặc từ chối thay vì tiêu token âm thầm.
| Candidate | Đúng plan | Đúng kết quả / metric | Output không hợp lệ | p50 / ms | RSS / MiB |
|---|---|---|---|---|---|
| baseline | 120/120 | 60/60 | 0 | 0.043 | 25 |
| qwen25 | 8/120 | 7/60 | 37 | 12113.0 | 618 |
| qwen3 | 29/120 | 24/60 | 9 | 7200.4 | 920 |
| adapter | 80/120 | 50/60 | 2 | 7888.2 | 918 |
| Candidate | Cold / s | p50 / ms | p95 / ms | Input / mean | Output / mean |
|---|---|---|---|---|---|
| baseline | 0.00 | 0.043 | 0.131 | n/a | n/a |
| qwen25 | 3.80 | 12113.0 | 20635.6 | 229.3 | 83.7 |
| qwen3 | 3.40 | 7200.4 | 9239.9 | 233.3 | 56.1 |
| adapter | 1.84 | 7888.2 | 10989.3 | 233.3 | 46.8 |
Cold là thời gian khởi tạo model server đến health ready; baseline không có model loader. Warm được đo sau bộ test, trên sáu ca monthly đầu tiên lặp ba lần, không đại diện cho toàn bộ loại câu hỏi. Độ trễ request đầu nằm trong từng row JSON. Các giá trị này không đo startup của web service LXC.
Qwen2.5 có 36 output sai schema, 1 output sai JSON và 1 output chạm giới hạn 160 token. Các nhóm có thể giao nhau. Tăng budget không sửa được schema hoặc kỳ thời gian sai; cần kiểm tra lỗi trước khi tối ưu token.
Bài viết liên quan
07 Oct 2026 · 5 phút đọc
agentic-ai
Agent Của OpenAI “Quậy” Wikipedia Suốt 5 Tháng — Và OpenAI Không Phải Người Phát Hiện Ra
Thông báo ngày 5/10 của Wikimedia hé lộ nhiều tháng traffic agent OpenAI trái phép trên hạ tầng của họ — điều tra do chính nạn nhân thực hiện, không phải nhà cung cấp.
Đọc tiếp
07 Oct 2026 · 11 phút đọc
agentic-ai
5. Train hành vi, retrieval kiến thức: thực hành LoRA
Chuẩn bị dữ liệu có giám sát, cấu hình thử nghiệm adapter và đánh giá giá trị vận hành của fine-tuning.
Đọc tiếp
07 Oct 2026 · 9 phút đọc
agentic-ai
7. Vận hành chatbot riêng tư trên production
Thiết kế cô lập tenant, tool giới hạn, kiểm soát phát hành, khôi phục lỗi và observability cho chatbot.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.