
BÀI VIẾT
5. Train hành vi, retrieval kiến thức: thực hành LoRA
Chuẩn bị dữ liệu có giám sát, cấu hình thử nghiệm adapter và đánh giá giá trị vận hành của fine-tuning.
Trong bài viết
Kỹ thuật Chatbot · Bài 5 trong 9 bài · Nguồn được đối chiếu ngày 7 tháng 10 năm 2026. Thiết kế và giả định đề xuất được phân biệt với kết quả triển khai đã đo.
Fine-tuning hữu ích nhất cho hành vi ổn định: chọn tool, theo schema, hỏi đúng câu làm rõ và trả lời theo định dạng nhất quán. Retrieval thường phù hợp hơn với chính sách và kiến thức sản phẩm thay đổi. Phép tính kinh doanh và quyền truy cập thuộc mã ứng dụng.
Xác định training có xử lý đúng lỗi không
Nếu câu trả lời sai vì retrieval đưa chính sách cũ, sửa ingestion và chọn phiên bản. Nếu sai vì query dùng doanh thu gộp thay vì thuần, sửa hợp đồng chỉ số. Nếu model gốc đủ năng lực vẫn liên tục vi phạm định dạng đầu ra ổn định dù prompt rõ, thử nghiệm adapter có giám sát là hợp lý.
So sánh bốn giai đoạn: model gốc, prompt và tool đã cải thiện, model adapter, và adapter quantized khi triển khai. Giữ bằng chứng và đầu vào đánh giá cố định. Tính cả độ phức tạp training, evaluation và serving; cải thiện chất lượng nhỏ có thể chưa đáng để vận hành thêm artifact.
Chuẩn bị ví dụ có giám sát
Bản ghi training cần có yêu cầu người dùng, ngữ cảnh liên quan được phép và đầu ra trợ lý mong muốn. Với data agent, train yêu cầu chỉ số có kiểu dữ liệu thay vì câu trả lời số tự bịa. Bổ sung yêu cầu mơ hồ, chỉ số chưa hỗ trợ, thiếu bằng chứng và từ chối phù hợp bên cạnh tác vụ thành công.
{"messages":[
 {"role":"system","content":"Return an approved metric request or ask for missing scope."},
 {"role":"user","content":"Show September 2026 net revenue in USD by channel."},
 {"role":"assistant","content":"{\"metric\":\"net_revenue\",\"period\":{\"start\":\"2026-09-01\",\"end_exclusive\":\"2026-10-01\"},\"group_by\":\"channel\",\"currency\":\"USD\"}"}
]}
Ví dụ giữ nguyên schema và code như bản tiếng Anh để dùng chung hợp đồng tool. Loại bỏ credential, định danh và nội dung kinh doanh riêng tư nếu chưa có cơ sở training hợp lệ được duyệt. Ghi nguồn gốc và giấy phép mỗi nguồn. Ví dụ tổng hợp cần người kiểm tra; lỗi tự tin của teacher model có thể trở thành mục tiêu train. Kiểm tra thỏa thuận provider trước khi dùng đầu ra hosted để distillation.
Dùng LoRA hoặc QLoRA cho thử nghiệm đầu tiên
LoRA train một tập tham số adapter nhỏ hơn và giữ trọng số gốc. QLoRA dùng backbone quantized giữ nguyên để giảm bộ nhớ khi train adapter. Cả hai đều không có nghĩa model đã học được hệ thống phân quyền database an toàn. Bài nghiên cứu QLoRA.
Tài liệu PEFT mô tả nạp bốn bit, NF4, double quantization và chuẩn bị cho adapter training. Dùng compute dtype tương thích GPU thực tế và kiểm tra backend đã cài. Hướng dẫn quantization của PEFT.
Cấu hình thử nghiệm cụ thể
Với baseline text Qwen3-4B, bắt đầu bằng context ngắn, batch size một, gradient accumulation và rank adapter vừa phải. Thiết lập dưới đây là điều kiện khởi đầu đề xuất, chưa phải cấu hình tối ưu qua đo lường hay một lần train đã hoàn tất.
base_model: Qwen/Qwen3-4B
revision: PIN_THE_REVIEWED_COMMIT
quantization: 4bit_nf4
adapter:
  rank: 16
  alpha: 32
  dropout: 0.05
  targets: [q_proj, k_proj, v_proj, o_proj]
training:
  max_length: 1024
  per_device_batch: 1
  gradient_accumulation: 16
  learning_rate: 0.0001
  epochs: 1
  gradient_checkpointing: true
  seed: 42
evaluation:
  development_each_epoch: true
  locked_test_after_selection: true
Kiểm tra tên module model trước khi chọn adapter target. Cùng tên có thể không bao phủ kiến trúc hybrid mới hơn. Bắt đầu bằng một smoke batch, kiểm tra số tham số train được và xác minh loss tính trên token câu trả lời mong muốn. Kiểm tra ví dụ dài có bị cắt mất phần assistant hay không.
Đồng bộ template training và serving
Dùng chat template của model và quyết định rõ cách biểu diễn thinking mode. Sai lệch có thể tạo reasoning không mong muốn hoặc JSON lỗi lúc inference. TRL hỗ trợ supervised training hội thoại và assistant-only loss khi template có generation marker cần thiết. Tài liệu TRL SFT Trainer có phiên bản.
Chỉ pin môi trường sau khi smoke test pass trên máy mục tiêu. Lưu package lock, thông tin CUDA/driver, hash tokenizer, hash dataset và tham số training cùng adapter. Bài này không cung cấp dependency lock chưa kiểm chứng và không khẳng định đã chạy GPU.
Đánh giá trước khi merge hoặc quantize
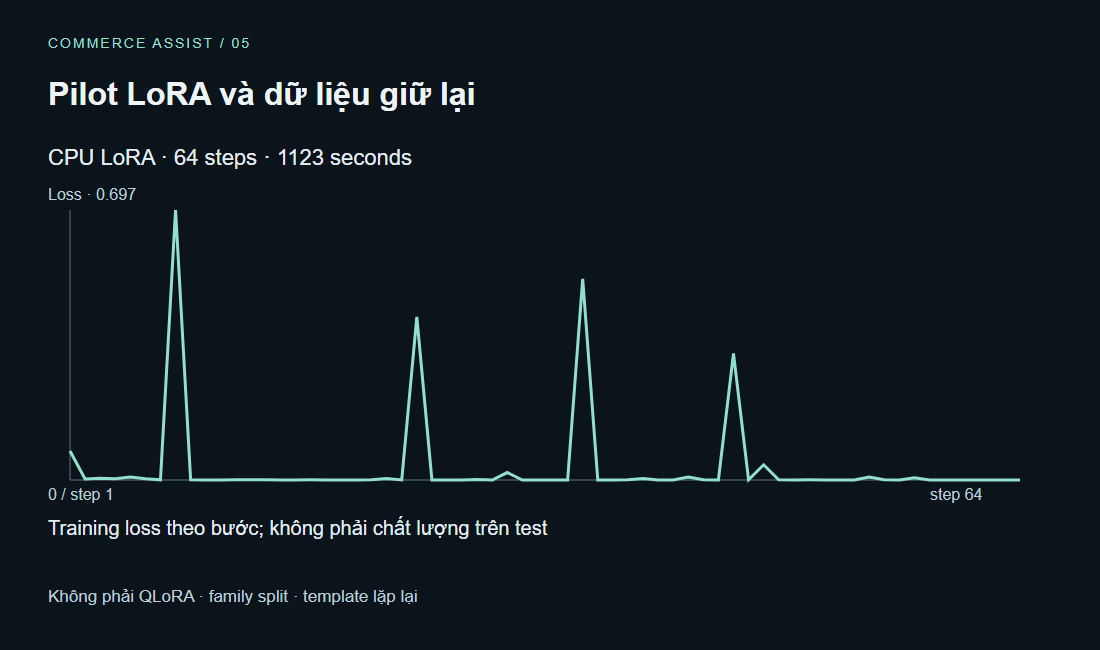
Chạy bộ tác vụ độc lập với model gốc và adapter. Kiểm tra theo schema, khả năng từ chối kết luận hoặc hỏi làm rõ khi phù hợp (abstention), chất lượng song ngữ và regression ở tác vụ khác. Training loss giảm chưa chứng minh hoàn thành công việc tốt hơn. Dừng hoặc sửa thử nghiệm nếu model học được định dạng nhưng mất khả năng làm rõ chính xác.
Nếu merge adapter để serving, giữ artifact gốc và adapter. Đánh giá lại model đã merge và quantized bằng đúng template production và giới hạn context. Tối ưu inference có thể đổi hành vi ngay cả khi tên model không đổi.
Ưu tiên backbone dùng lại được
Dùng cấu hình client và retrieval cho thương hiệu, định nghĩa chỉ số và tài liệu. Chỉ thêm adapter riêng khi lỗi lặp lại cho thấy khác biệt hành vi ổn định mà cấu hình không giải quyết được. Quản lý hàng chục adapter tạo thêm chi phí rollout, cô lập, routing và nạp model lúc cold start.
Mốc đầu tiên là cải thiện hẹp có thể tái lập so với model gốc, được đánh giá độc lập hỗ trợ. Tái tạo quy trình training độc quyền của Jev hoặc đạt tương đương model hàng đầu trên mọi tác vụ là mục tiêu nghiên cứu khác, chưa được chứng minh ở đây.
Thực hành: thử nghiệm adapter trả lời câu hỏi thật
Câu hỏi thử nghiệm là “Adapter có cải thiện việc lập plan chỉ số có cấu trúc và hỏi làm rõ phù hợp so với baseline Qwen3-4B nguyên gốc không?”. Không phải “Training loss có giảm không?”. Giữ retrieval, tool và danh mục chỉ số cố định. Ví dụ song ngữ dùng cùng hợp đồng đầu ra; ngôn ngữ là lát cắt dữ liệu, không phải lý do đổi schema.
Dataset pilot đề xuất có thể gồm 400 yêu cầu chỉ số được duyệt, 200 câu cần làm rõ, 200 yêu cầu chưa hỗ trợ hoặc bị cấm và 200 case định dạng câu trả lời tài liệu. Đây là giả định thiết kế, chưa phải số tối thiểu đã xác nhận. Giữ dev/test độc lập từ nhóm yêu cầu hoặc tác giả khác. Nếu production chủ yếu hỏi chỉ số, đánh giá cả cơ cấu thật lẫn bộ chẩn đoán cân bằng.
Kiểm tra ví dụ trước khi tốn GPU
Mỗi record cần kiểm tra nguồn gốc, trường bắt buộc, JSON assistant hợp lệ, ngữ nghĩa đúng, không có secret hay định danh client. Record chỉ số ở phần trước dạy plan thô; thử nghiệm nhiều tác vụ cần outcome envelope: metric_plan có payload, clarify có câu hỏi và trường thiếu, refuse có lý do và phương án hỗ trợ, document_answer có text và citation. Validate từng outcome bằng schema riêng. Chỉ payload metric-plan dùng validator hợp đồng tool của sample; không đưa clarification, refusal, câu tài liệu vào query executor. Tokenize theo template, xem ví dụ gần giới hạn. Ví dụ bị cắt mất target không phải dữ liệu giám sát hữu ích.
Thêm biến thể tương phản: hỏi rõ tháng Chín, thiếu kỳ và yêu cầu export cấp khách hàng bị cấm. Reviewer xác nhận câu làm rõ chỉ hỏi thông tin thiếu, câu từ chối giải thích phương án được hỗ trợ. Không dạy model từ chối mọi câu có thuật ngữ nhạy cảm; điều đó làm hỏng phân tích tổng hợp hợp lệ.
Scaffold training Python cụ thể
Scaffold dưới nhắm API SFT TRL 0.26 được tài liệu mô tả và môi trường Transformers/PEFT/bitsandbytes tương thích. Đây là recipe GPU đề xuất, chưa phải dependency lock đã test GPU. Pin revision đã review qua biến môi trường. Dataset JSONL có trường prompt, completion tạo từ ví dụ được duyệt. Completion-only loss tránh dựa vào assistant-mask template chưa kiểm chứng.
import os
import torch
from datasets import load_dataset
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
from peft import LoraConfig, prepare_model_for_kbit_training
from trl import SFTConfig, SFTTrainer

name = "Qwen/Qwen3-4B"
revision = os.environ["MODEL_REVISION"]
dtype = torch.bfloat16 if torch.cuda.is_bf16_supported() else torch.float16
tokenizer = AutoTokenizer.from_pretrained(name, revision=revision)
model = AutoModelForCausalLM.from_pretrained(
    name, revision=revision, device_map={"": 0},
    quantization_config=BitsAndBytesConfig(
        load_in_4bit=True, bnb_4bit_quant_type="nf4",
        bnb_4bit_use_double_quant=True, bnb_4bit_compute_dtype=dtype
    )
)
model = prepare_model_for_kbit_training(model)
model.config.use_cache = False
data = load_dataset("json", data_files={"train": "train.jsonl", "validation": "dev.jsonl"})
trainer = SFTTrainer(
    model=model, processing_class=tokenizer,
    train_dataset=data["train"], eval_dataset=data["validation"],
    peft_config=LoraConfig(r=16, lora_alpha=32, lora_dropout=0.05,
        target_modules=["q_proj", "k_proj", "v_proj", "o_proj"], task_type="CAUSAL_LM"),
    args=SFTConfig(output_dir="adapter", max_length=1024,
        per_device_train_batch_size=1, gradient_accumulation_steps=16,
        learning_rate=1e-4, num_train_epochs=1, completion_only_loss=True,
        gradient_checkpointing=True, bf16=(dtype == torch.bfloat16),
        fp16=(dtype == torch.float16), eos_token="<|im_end|>", eval_strategy="epoch", seed=42)
)
batch = next(iter(trainer.get_train_dataloader()))
assert (batch["labels"] != -100).any(), "No supervised completion tokens remain"
trainer.train()
trainer.save_model("adapter")
Render prompt bằng non-thinking chat template dự kiến và bảo đảm completion chứa token kết thúc assistant phù hợp. Smoke batch kiểm tra quy ước trước train. Scaffold dành riêng baseline text; không thay trực tiếp loader cho Qwen3.5 đa phương thức hay Gemma. Kiểm tra syntax không chứng minh tương thích GPU hoặc học có ích.
Tạo một JSONL record bằng template đúng
Ví dụ dưới tạo một record minh họa định dạng, chưa phải dataset train dùng được. Lặp chuẩn bị với record được review độc lập, giữ dev case riêng. Adapter ứng dụng validate outcome envelope, lấy metric_plan.payload rồi gọi validator chỉ số.
import json
from transformers import AutoTokenizer
import os

tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen3-4B", revision=os.environ["MODEL_REVISION"])
messages = [
    {"role": "system", "content": "Return a supported outcome envelope. Ask if scope is missing."},
    {"role": "user", "content": "Show September 2026 net revenue in USD by channel."}
]
target = {"kind": "metric_plan", "payload": {
    "metric": "net_revenue", "period": {"start": "2026-09-01", "end_exclusive": "2026-10-01"},
    "group_by": "channel", "currency": "USD"
}}
prompt = tokenizer.apply_chat_template(messages, tokenize=False,
    add_generation_prompt=True, enable_thinking=False)
completion = json.dumps(target, ensure_ascii=False, separators=(",", ":")) + "<|im_end|>"
assert len(tokenizer(prompt + completion, add_special_tokens=False)["input_ids"]) <= 1024
with open("example-record.jsonl", "w", encoding="utf-8") as handle:
    handle.write(json.dumps({"prompt": prompt, "completion": completion}, ensure_ascii=False) + "\n")
Kiểm tra smoke batch thực tế: label prompt được mask, completion giữ lại, padding bỏ qua. Assertion trong scaffold kiểm tra còn token được giám sát; không thay việc kiểm tra ranh giới đúng trên nhiều record dài. Xem cả EN, VI; từ chối hoặc tổ chức lại record quá dài thay vì âm thầm mất target.
Chạy ablation nhỏ rồi quyết định
Giữ kết quả model gốc. Chạy một cấu hình adapter đầu. Nếu dev metric tốt hơn, thử một learning rate thấp hơn hoặc rank thấp hơn, không chạy hàng chục trial theo bộ test khóa. Ghi effective batch size, độ dài token ví dụ, số tham số train, peak GPU memory và thời gian. Chọn theo tác vụ đúng, abstention hữu ích, không theo training loss.
Sau chọn, chạy test độc lập một lần và đánh giá artifact quantized triển khai. Phân tích adapter có học mẹo format, từ chối quá mức câu tiếng Việt hay ghi nhớ mẫu ngày không. Nếu lợi ích mất trên case độc lập, giữ model gốc đơn giản hơn.
Lưu thử nghiệm thành artifact kiểm tra được
Lưu revision gốc, trọng số adapter, tokenizer, package lock sau smoke test pass, hash dữ liệu, template, seed và hồ sơ evaluation. Giữ ví dụ riêng tư trong storage được phép, không đưa lên model repo công khai. Đầu ra chấp nhận là cải thiện có bằng chứng độc lập trên tác vụ xác định, không chỉ có adapter tải được.
Từ bài viết đến thử nghiệm chạy được
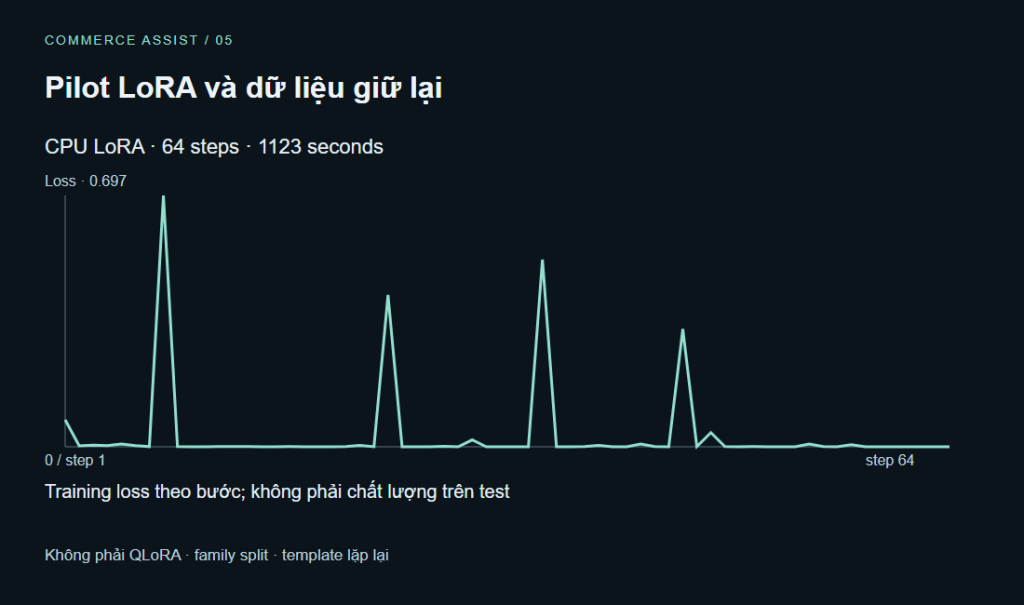
Benchmark và training là thử nghiệm trên dữ liệu giả lập do tác giả xây dựng, có các template tương quan. Không chứng minh tương đương model lớn hoặc chất lượng trên dữ liệu khách hàng. Model sinh plan được đo offline; demo công khai dùng baseline có kiểm soát. Benchmark: đã hoàn thành bốn candidate. LoRA: completed, 64/64 bước.
Lộ trình và kết quả thực nghiệm · Thử demo với dữ liệu giả lập · Tải code minh họa
Bài học từ triển khai này
Pilot chỉ cập nhật 1.146.880 tham số LoRA; prompt bị mask, completion và EOS nhận supervision. Dữ liệu train 64 bản ghi có template lặp; loss thấp có thể phản ánh học thuộc. Chỉ bật adapter nếu bộ test và dữ liệu thực xác nhận chất lượng, an toàn và tốc độ.
| Candidate | Đúng plan | Đúng kết quả / metric | Output không hợp lệ | p50 / ms | RSS / MiB |
|---|---|---|---|---|---|
| baseline | 120/120 | 60/60 | 0 | 0.043 | 25 |
| qwen25 | 8/120 | 7/60 | 37 | 12113.0 | 618 |
| qwen3 | 29/120 | 24/60 | 9 | 7200.4 | 920 |
| adapter | 80/120 | 50/60 | 2 | 7888.2 | 918 |
Adapter có giúp ích không?
Trên cùng 120 ca, Qwen3 gốc đúng 29 plan; adapter đúng 80, chênh lệch +51 ca. Đây là một lần chạy với một seed trên fixture hẹp, không phải ước lượng chất lượng tổng quát.
Output không hợp lệ giảm từ 9 xuống 2; đề xuất metric ở các ca cần từ chối giảm từ 25 xuống 11. Warm p50 của adapter là 7.89 giây so với 7.20 giây của base. Adapter cải thiện contract nhưng chưa đạt điều kiện bật public; demo tiếp tục dùng baseline. Đây không phải bằng chứng tương đương model lớn.
So sánh từng ca: 51 cải thiện, 0 hồi quy, 69 không đổi. Các ID và output trước/sau có trong results.json.
Bài viết liên quan
07 Oct 2026 · 5 phút đọc
agentic-ai
Agent Của OpenAI “Quậy” Wikipedia Suốt 5 Tháng — Và OpenAI Không Phải Người Phát Hiện Ra
Thông báo ngày 5/10 của Wikimedia hé lộ nhiều tháng traffic agent OpenAI trái phép trên hạ tầng của họ — điều tra do chính nạn nhân thực hiện, không phải nhà cung cấp.
Đọc tiếp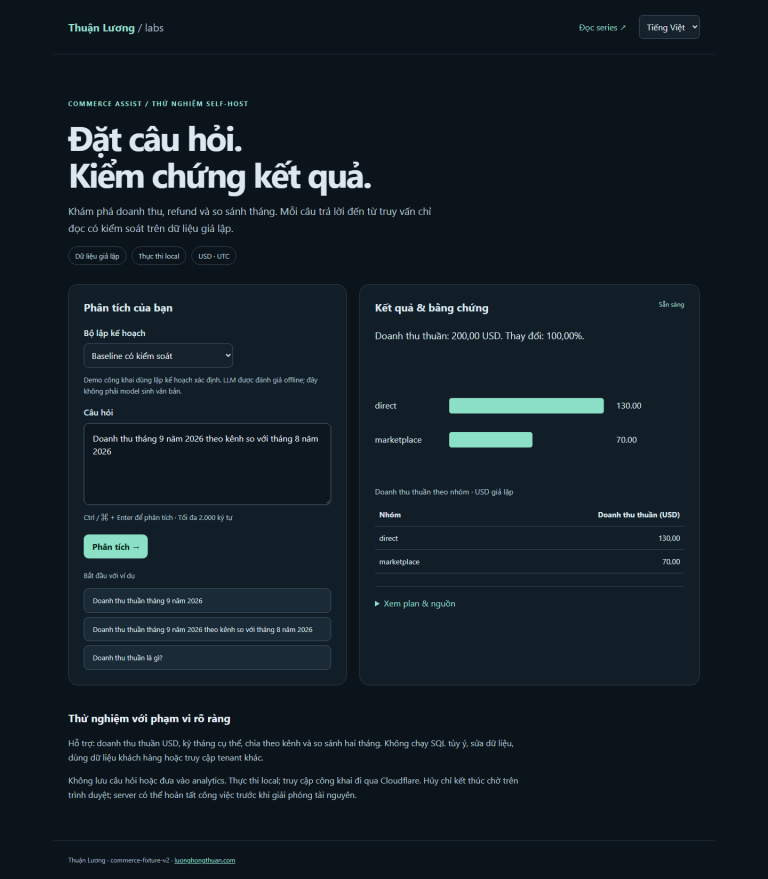
07 Oct 2026 · 9 phút đọc
agentic-ai
9. Thiết kế chatbot dễ tin cậy, cấu hình và khôi phục
Thiết kế quy trình trả lời và phân tích, cấu hình an toàn, accessibility và hướng dẫn dùng demo thực tế.
Đọc tiếp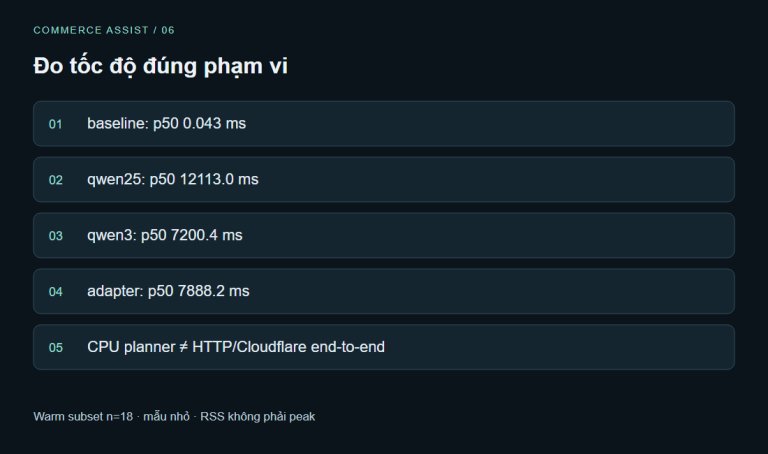
07 Oct 2026 · 9 phút đọc
agentic-ai
6. Tăng tốc chatbot và giữ chất lượng
Tối ưu context, output, caching, retrieval và inference theo ngân sách độ trễ, token từ đầu đến cuối.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.