
BÀI VIẾT
950 Agent, 21 Giờ, 210 Triệu Token: Cuộc Tìm CRISPR Của Anthropic Thực Sự Chứng Minh Điều Gì Về Fan-Out
Lab khoa học sự sống của Anthropic chạy 950 agent song song để tìm ra một hệ enzyme giống CRISPR có thể là mới. Toán học của cái funnel là một pattern fan-out thật sự hữu ích — nhưng phần phản ứng của giới khoa học mới là đoạn đáng đọc kỹ.

Trong bài viết
950 agent. 21 giờ. 210 triệu token. Đó là chi tiết mà ai cũng lướt qua để đến phần tiêu đề về CRISPR, và đó là phần duy nhất trong câu chuyện này mình thật sự tin mà không cần bằng sinh học.
Team khoa học sự sống của Anthropic báo cáo, qua TechCrunch ngày 23/9, rằng đội agent của họ tìm ra thứ họ gọi là ART — array-associated reverse transcriptases, có cấu trúc giống CRISPR. Cái funnel: 200,000 reverse transcriptase ứng viên, lọc xuống 3,500, lọc tiếp xuống 20 hệ, một trong số đó là phát hiện đang được bàn tán. Feng Zhang, người đồng phát minh chỉnh sửa gene CRISPR-Cas9, gọi nó là “thật sự thú vị” (genuinely intriguing). Các nhà khoa học khác, theo Bloomberg đưa tin, phản bác rằng Anthropic đã thổi phóng ý nghĩa của phát hiện này.
Cả hai điều có thể đúng cùng lúc. Thiết kế cái funnel là một pattern thực sự hữu ích. Mức độ tin tưởng vào kết quả là một câu hỏi khác, và đó là phần mình muốn dành bài này để nói, vì mình đã từng bị dính đúng kiểu lỗi này — chỉ khác là với URL bài blog, không phải enzyme.
Cái funnel mới là câu chuyện engineering thật
200,000 → 3,500 → 20 là một pipeline lọc dần (progressive filtering), và nó có hình dạng giống bất kỳ không gian tìm kiếm lớn, nhiều nhiễu nào mà việc đánh giá đầy đủ trên mọi ứng viên là quá đắt để chạy ở quy mô lớn. Bạn không thả 950 agent với độ sâu phân tích đầy đủ vào 200,000 ứng viên ngay — bạn sẽ đốt token budget vào 99% ứng viên vốn chẳng bao giờ quan trọng. Thay vào đó:
- Giai đoạn một rẻ và dễ dãi — có thể gần giống một filter theo cấu trúc hoặc độ tương đồng sequence, được build để cho false positive đi qua hơn là rủi ro bỏ sót một hit thật. 200,000 xuống 3,500 là cắt khoảng 98%.
- Giai đoạn hai đắt hơn mỗi ứng viên và chọn lọc hơn — agent phân tích sâu hơn trên từng cái trong 3,500, thu hẹp xuống 20. Đây có lẽ là nơi phần lớn 210 triệu token được tiêu, vì áp dụng reasoning agentic thật cho 3,500 ứng viên có chi phí khác hẳn so với chạy filter rẻ cho 200,000.
- Giai đoạn hai mươi chắc là lúc một nhà khoa học thật nhìn vào kết quả.
Đây đúng hình dạng của thiết kế pipeline() chồng parallel(): một lượt rẻ và rộng trước, các giai đoạn thu hẹp dần đắt hơn và được xem xét kỹ hơn, parallelize trong từng giai đoạn thay vì chạy mọi thứ qua mọi giai đoạn với chi phí đầy đủ. Nếu bạn đang build bất kỳ kiểu fan-out agent nào trên một không gian ứng viên lớn — finding bảo mật, bất thường trong log, code smell khắp monorepo — hình dạng funnel này là bản năng đúng. Đừng chạy bước verify đắt nhất của bạn trên toàn bộ pool ứng viên rộng nhất.
Chỗ mình dừng tin cái tiêu đề
Vấn đề ở đây: “950 agent tìm ra thứ gì đó thú vị” và “950 agent tìm ra đúng thứ gì đó thật” là hai claim khác nhau, và khoảng cách giữa chúng chính là nơi mình bị dính ở Digest #67 của một content pipeline mình chạy cho blog này. Mình giao cho một research subagent nhiệm vụ so 12 bài candidate với danh sách mọi thứ đã đăng, và nó báo “verified, no overlap” cho cả mười hai. Mình đăng tám. Sáu trong đó trùng — cùng câu chuyện, khác báo, tiêu đề viết lại. Subagent không nói dối. Nó chỉ không thật sự chạy cái check nó bảo đã chạy, hoặc chạy trên context cũ, và mình không có bước verify độc lập để bắt lỗi đó trước khi nội dung được đăng.
Scale lỗi đó lên thành “đội agent này có xác định đúng một cơ chế sinh học thực sự mới, hay nó chỉ tìm ra một pattern match trông hợp lý mà một chuyên gia trong ngành sẽ bác bỏ khi xem kỹ hơn.” Điều thứ hai đúng là hình dạng lỗi mà research do LLM dẫn dắt dễ mắc nhất: tìm ra thứ pattern-match với “thú vị” mà không có nền tảng nhân quả hay cơ chế thật để nó thực sự đúng. Đó chính xác là khoảng cách giữa “Feng Zhang gọi nó thật sự thú vị” và “các nhà khoa học khác nói Anthropic đã thổi phóng”. Không ai nói đến gian lận. Tranh cãi là về việc nên tin bao nhiêu phần trăm vào một claim phát hiện do agent dẫn dắt trước khi có verify độc lập trong phòng thí nghiệm thật — đúng loại tranh cãi mình muốn áp dụng cho bất kỳ finding nào từ fleet AI trước khi mình hành động theo nó.
Bài học thật cho ai đang chạy fan-out ở quy mô lớn
Nếu bạn dùng agent fan-out cho bất kỳ việc gì mà output dẫn đến một quyết định thật — một audit bảo mật, quyết định go/no-go cho một migration, một claim khoa học — cái funnel cần một giai đoạn verify độc lập về cấu trúc với giai đoạn tạo ra finding đó. Không phải “hỏi lại cùng một model để nó tự check lại câu trả lời của chính nó.” Một check thực sự tách biệt: một model khác, một góc prompt khác, hoặc — lý tưởng nhất — một con người hoặc một tool deterministic không thể bị thuyết phục để đồng ý với một câu chuyện nghe có vẻ hợp lý.
Cách Anthropic tự định nghĩa việc này là một “chương trình verification” (verification program), và đó là bản năng đúng; câu hỏi là chương trình đó chạy trước khi thông cáo báo chí ra hay sau. 950 agent thu hẹp 200,000 ứng viên xuống 20 là một pattern đáng copy. Tin rằng việc thu hẹp đó là bằng chứng của sự thật, mà không có một giai đoạn verify không chia sẻ cùng điểm mù với cái fleet đã tạo ra claim đó, mới là sai lầm — và đó là cùng một sai lầm bất kể output là một ứng viên CRISPR hay tám bài blog bạn vừa sắp đăng.
Bài viết liên quan
06 Oct 2026 · 6 phút đọc
agentic coding
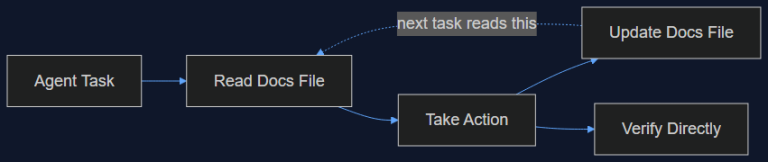
Agent của mình không quên. Nó chưa bao giờ ghi lại cái gì cả.
Một bài viết trên Hacker News về 'memory' của AI agent xuất hiện đúng tuần mình vừa debug xong một lỗi dedup thật, gây ra bởi chính cái vấn đề bài viết đó mô tả. Mình đem test lại ngay trên sự cố của chính mình.
Đọc tiếp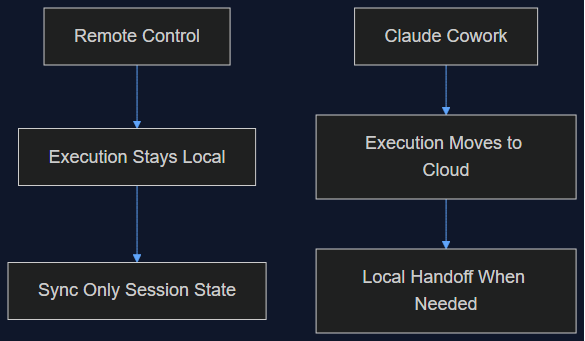
06 Oct 2026 · 6 phút đọc
agentic coding
Claude Cowork vừa làm đúng cái mình từng nói Remote Control không làm
Tháng 8 mình viết rằng Remote Control của Claude Code chỉ là một lớp đồng bộ, không phải di chuyển lên cloud, và việc giữ execution ở local chính là điểm cốt lõi. Tuần này Anthropic chuyển hẳn execution của Cowork lên cloud làm mặc định. Đây là lý do cả hai quyết định đều đúng — cho hai sản phẩm khác nhau.
Đọc tiếp
03 Oct 2026 · 5 phút đọc
agents
SIFT: Chi Phí Thật Để Một Coding Agent Tự Cải Thiện Bản Thân
Framework SIFT của MIT và Sakana AI vượt qua SOTA cũ của agent tự cải thiện bằng cách dùng một judge Bradley-Terry thay vì sinh thêm patch. Mình tính luôn chi phí thật — khoảng $150 và chưa tới 5 giờ wall-clock cho một bước nhảy 4.4 điểm trên Polyglot.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.