
BÀI VIẾT
Benchmark Agent SQL Của ClickHouse: Điểm Nghẽn Đã Dịch Lên Trước Bước Viết SQL
ClickHouse chấm 28 model trên 201 câu hỏi phân tích thực tế, cho agent tối đa 60 lượt mỗi câu. Lỗi thực thi SQL gần như biến mất. Nguyên nhân thất bại chiếm đa số, 53-82% các trường hợp, là agent lập sai kế hoạch trước khi viết một câu SQL nào.
Trong bài viết
ClickHouse vừa công bố kết quả một benchmark mà bất kỳ ai đang xây agent phân tích dữ liệu (analytics agent) cũng nên đọc kỹ, vì nó lật ngược một giả định mà nhiều hệ thống eval vẫn đang dựa vào: cho rằng phần khó nhất của text-to-SQL là viết đúng câu SQL.
Benchmark này, mã nguồn mở với tên data-agent-mnist, lấy 201 câu hỏi phân tích thực tế từ lưu lượng sản xuất của DWAINE, agent phân tích nội bộ của chính ClickHouse, rồi chạy trên một bản dựng lại tổng hợp nhưng trung thực của data warehouse của họ. 28 model, cả đóng và mở trọng số, mỗi model được cấp tối đa 60 lượt (turn) cho mỗi câu hỏi để khám phá schema, viết query, xem kết quả, rồi đưa ra câu trả lời. Không có một câu SQL chuẩn để so khớp. Độ đúng được chấm dựa trên kết quả mà một hội đồng ground-truth đa nhà cung cấp và một hội đồng LLM-làm-giám-khảo đồng thuận, mỗi giám khảo bị loại khỏi việc chấm các model cùng họ với nó.
Cách thiết kế này quan trọng. Phần lớn benchmark text-to-SQL thưởng cho việc khớp với một câu query tham chiếu. Benchmark này thưởng cho việc ra đúng số, bất kể agent đi đường nào để đến đó. Nó gần với cách một trợ lý phân tích (analytics copilot) thực sự được dùng, và chính vì vậy dữ liệu về thất bại mới đáng để xem kỹ.
Lỗi thực thi SQL gần như đã được giải quyết
ClickHouse chia câu trả lời sai thành năm loại lỗi: FM1 (không trả lời), FM2 (sai kế hoạch), FM3 (sai dữ liệu), FM4 (sai cách triển khai), và FM5 (lỗi thực thi). FM5, loại lỗi tương ứng với việc SQL không chạy được, giờ gần như không còn xuất hiện. Chỉ 4 trong 28 model ghi nhận có lỗi thực thi, và chỉ một model, Gemma 4 31B, vượt mốc 2%. Với mọi model hàng đầu trong danh sách, việc viết ra SQL chạy được trên schema đã là bài toán giải xong.
Đây là một kết quả thật, không phải chi tiết phụ. Trong nhiều năm, một phần đáng kể lỗi text-to-SQL là lỗi cú pháp: tham chiếu sai cột, join sai, hoặc model không biết một đặc thù dialect nào đó. Dữ liệu của ClickHouse cho thấy giai đoạn đó phần lớn đã qua với các model hàng đầu hiện nay, khi chúng hoạt động trong một vòng lặp agent nhiều lượt, có thể thấy thông báo lỗi và tự sửa.
Lỗi chiếm đa số xảy ra trước khi có bất kỳ câu SQL nào
Đây là con số cần thay đổi cách các team nghĩ về eval cho agentic analytics: FM2, sai kế hoạch, là loại lỗi phổ biến nhất, chiếm 53 đến 82% tổng số lỗi ở mọi model có số lỗi đủ lớn để thống kê. Đây không phải là chênh lệch nhẹ giữa hai loại lỗi gần nhau. Đây là nguyên nhân chính gây thất bại của toàn bộ task, và nó xảy ra hoàn toàn trước khi agent viết SQL.
Sai kế hoạch nghĩa là agent chọn sai bảng, sai đường join, hoặc sai điều kiện lọc trước khi viết bất kỳ query nào. Câu SQL sinh ra từ kế hoạch đó có thể đúng cú pháp hoàn hảo, chạy trơn tru, và vẫn trả lời một câu hỏi không ai hỏi. Một model có thể đạt điểm FM5 bằng không mà vẫn fail task, vì thứ nó làm sai chưa bao giờ có thể biểu diễn thành một lỗi SQL. Đó là lỗi đọc hiểu và lỗi định hướng trong schema.
Cách ClickHouse tự diễn giải điều này rất rõ: cú pháp và việc thực thi SQL không còn là điểm nghẽn với các model hiện nay; với agentic analytics, việc mô hình hóa dữ liệu (data modeling) và ngữ cảnh schema mới là yếu tố quyết định. Đây là một nhận định cụ thể, có thể kiểm chứng, dựa trên dữ liệu benchmark của chính họ, không phải một nhận xét chung về việc AI đang trưởng thành.
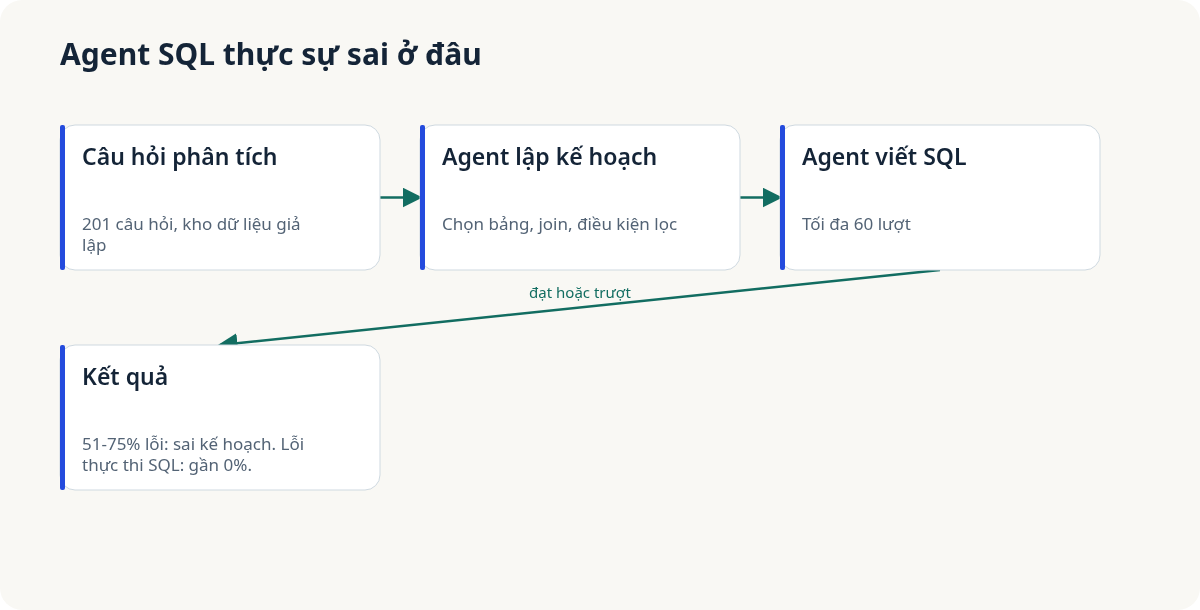
Sơ đồ trên cho thấy 201 câu hỏi của benchmark thực sự vỡ ra ở đâu. Agent trước tiên phải lập kế hoạch: chọn đúng bảng, đúng join, đúng điều kiện lọc, dựa trên việc đọc câu hỏi đối chiếu với một schema mà nó phải tự khám phá. Chỉ sau khi có kế hoạch, nó mới viết SQL, với tối đa 60 lượt để lặp lại. Kết quả phân chia rất rõ: lỗi thực thi SQL gần như bằng không, còn lỗi sai kế hoạch chiếm phần lớn mọi thứ đi sai. Điểm nghẽn nằm hoàn toàn ở ô đầu tiên, không phải ô thứ hai.
Vì sao điều này quan trọng với team xây copilot phân tích dữ liệu
Nếu bạn đang xây hoặc đánh giá một công cụ BI dạng agentic trong công ty, kết quả này có hệ quả trực tiếp đến việc nên phân bổ ngân sách eval ở đâu. Nhiều bộ eval text-to-SQL vẫn dành phần lớn công sức để kiểm tra SQL sinh ra có parse được, chạy được, và khớp hình dạng query mong đợi hay không. Dữ liệu của ClickHouse cho thấy công sức đó giờ phần lớn bị lãng phí vào một bài toán mà các model hàng đầu hiện nay đã tự giải xong, đặc biệt khi được cấp một vòng lặp nhiều lượt để thấy và phản ứng với lỗi thực thi.
Thứ đáng đo thay vào đó là chất lượng kế hoạch, độc lập với việc SQL cuối cùng có chạy được hay không:
- Agent có chọn đúng các bảng cho câu hỏi không, kể cả những bảng cần một đường join không hiển nhiên để tới được?
- Nó có áp đúng các điều kiện lọc mà câu hỏi thực sự ngụ ý (đúng khoảng thời gian, đúng cờ trạng thái, đúng phạm vi thực thể), hay chỉ là các điều kiện nghe hợp lý nhưng sai?
- Nó có giải nghĩa đúng các thuật ngữ nghiệp vụ mơ hồ dựa trên schema, hay chỉ đoán cột nào tương ứng với một thuật ngữ như “người dùng hoạt động” hay “doanh thu thuần”?
- Khi kế hoạch sai, agent có cách nào để tự nhận ra, ngoài việc con số cuối cùng nhìn rõ ràng là bất thường?
Không câu hỏi nào trong số này là câu hỏi về độ đúng của SQL. Đây là câu hỏi về việc agent có hiểu đúng cần tính gì trước khi nó thử tính hay không. Một bộ eval chỉ kiểm tra câu query cuối hoặc kết quả cuối, mà không tách riêng lỗi ở tầng kế hoạch với lỗi ở tầng thực thi, sẽ tiếp tục báo cáo sai vấn đề: nó sẽ trông như một bài toán sinh SQL, trong khi thực chất là một bài toán đọc hiểu, và các team sẽ tiếp tục tinh chỉnh sai giai đoạn trong pipeline.
Về mặt thực hành, điều này gợi ý nên ghi nhận lỗi theo đúng cách ClickHouse làm, theo từng giai đoạn, không chỉ theo đạt hay không đạt. Một lỗi chỉ ghi là “trả lời sai” không cho bạn biết gì về việc nên đầu tư vào tài liệu schema và tầng ngữ nghĩa (semantic layer) tốt hơn, hay vào việc cải thiện prompt sinh SQL và thiết kế tool. Một lỗi ghi là “sai kế hoạch, dùng bảng orders thay vì view fulfilled_orders” thì cho bạn biết chính xác nên dành giờ kỹ thuật tiếp theo vào đâu.
Nhận định biên tập
Model dẫn đầu bảng xếp hạng của ClickHouse, Claude Fable 5.1, đạt độ đúng 76,6% trên 201 câu hỏi, trong khi một model rẻ hơn như DeepSeek V4 Flash đạt 65,7% với chi phí chạy toàn bộ benchmark thấp hơn khoảng 52 lần. Đó là những con số hữu ích để chọn model. Nhưng phát hiện bền vững hơn nằm ở cách phân loại lỗi, vì nó nói lên vấn đề còn tồn đọng thực sự của lĩnh vực này nằm ở đâu, độc lập với việc model nào đang đứng đầu bảng xếp hạng tại thời điểm hiện tại.
Những team tiếp tục tối ưu độ đúng của việc sinh SQL, chỉnh prompt template cho các đặc thù dialect, thêm vòng lặp retry cho lỗi cú pháp, đang đánh bóng một bề mặt mà các model hàng đầu đã làm nhẵn từ trước. Việc còn lại thực sự là làm cho khả năng hiểu câu hỏi của agent, và bản đồ schema của nó, đủ đáng tin để kế hoạch đúng trước khi một dòng SQL nào được viết ra. Đó là một bài toán khó eval hơn, vì nó đòi hỏi đánh giá ý định chứ không chỉ kết quả, nhưng đó chính là bài toán mà dữ liệu cho thấy vẫn chưa được giải.
Nguồn: ClickHouse, “The Agentic Analytics Benchmark: Measuring model accuracy and efficiency in analytical agents”, benchmark data-agent-mnist, 201 câu hỏi, tối đa 60 lượt mỗi câu, đánh giá trên 28 model.
Bài viết liên quan
· 6 phút đọc
agentic-ai
Chợ Plugin Antigravity Của Google Đưa Lớp Bảo Vệ Thành Một Lựa Chọn Cài Thêm
Plugin google-cloud-developer mới của Google gói năm kỹ năng — bám tài liệu gốc, kiểm an toàn lệnh gcloud, hướng xác thực an toàn — vào một lệnh cài cho chợ plugin Antigravity. Lớp bảo vệ là thật, nhưng là lựa chọn cài thêm, không phải mặc định của platform.
Đọc tiếp
· 6 phút đọc
agentic-ai
76% Agent AI Đang Ngủ Im. Không Cái Nào Mất Chìa Khóa.
Báo cáo 2026 của Arrakis Security cho thấy hầu hết agent AI ngủ im sau vài tháng nhưng vẫn giữ credential còn sống — 19% dùng API key không hết hạn, và một phần tư có thể bị kích hoạt bởi webhook không ký từ bên ngoài tổ chức.
Đọc tiếp· 5 phút đọc
agentic-ai
EMBRACE: Lỗi Trình Duyệt Giấu Trong Năm Công Cụ Coding AI
Forever Security phát hiện Cursor, GitHub Copilot, Claude Desktop, VS Code và Codex đều nhúng trình duyệt với quyền lớn hơn trình duyệt thật — dẫn tới thực thi code, đánh cắp file và giả mạo địa chỉ. Hai trong năm lỗi vẫn chưa được vá.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.