
BÀI VIẾT
GitHub Viết Lại Runtime Copilot Bằng Rust. Điều Đáng Học Là Họ Làm Chậm Đến Mức Nào.
GitHub chuyển runtime của Copilot language server từ Node.js sang Rust qua khoảng 128 pull request. Cách làm từng bước này, không phải việc chọn ngôn ngữ, mới là điều đáng học.
Trong bài viết
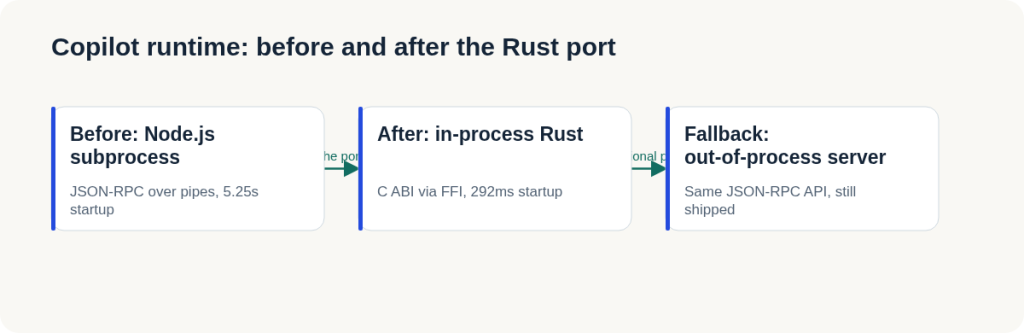
Nửa cuối năm 2026, GitHub thay toàn bộ runtime phía dưới Copilot language server, chuyển từ Node.js sang Rust. Chuyện một runtime của language server bị viết lại để cải thiện hiệu năng thì không có gì mới. Điều đáng chú ý ở đây là hình dạng của quá trình migrate, không phải ngôn ngữ đích. GitHub không dừng mọi thứ lại để ship một bản rewrite toàn bộ. Họ chạy khoảng 128 pull request trong khoảng mười bốn tuần rưỡi, giữ nguyên đường Node.js cũ như một fallback suốt cả quá trình, và chỉ chuyển default sang đường mới khi đường mới đã chứng minh được giá trị. Đây là một quyết định cụ thể, đáng học, và đi ngược hẳn với cách phần lớn các cuộc rewrite ngôn ngữ nổi tiếng thường được thực hiện.
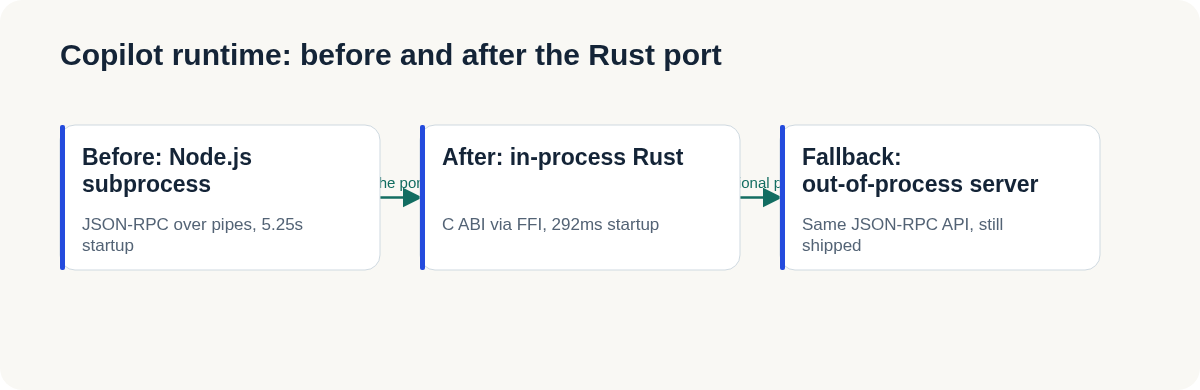
Lý do kỹ thuật cho việc rewrite khá rõ ràng. Kiến trúc cũ chạy Copilot language server như một process Node.js riêng cho mỗi client editor, nói chuyện qua JSON-RPC qua các pipe stdio. Mỗi cửa sổ editor là một subprocess riêng, một lần handshake JSON-RPC riêng, một khoảng độ trễ khởi động riêng. Theo báo cáo của chính GitHub về dự án này, thời gian cold-start của Node.js khoảng 5,25 giây, so với khoảng 292 milligiây cho runtime Rust mới chạy trong cùng process, được gọi qua C ABI bằng FFI thay vì spawn ra một process riêng. Đó là mức cải thiện gần 18 lần chỉ riêng ở thời gian khởi động, và con số này nhân lên theo từng cửa sổ editor mà một developer mở trong một ngày làm việc.
Vì sao đường đi chậm mới là câu chuyện thật
Viết lại một runtime nằm trong đường hot path của mọi lần gõ phím, trên mọi editor được hỗ trợ, là một loại thay đổi nguy hiểm. Làm sai thì bạn không nhận được một bug report đơn giản, mà là độ trễ âm thầm tăng lên hoặc crash rải rác trên một lượng người dùng khổng lồ, chạy đủ loại editor, phiên bản OS và tổ hợp extension mà GitHub không thể liệt kê hết trong một test matrix. Cách team xử lý rủi ro đó mang tính kiến trúc, không chỉ là quy trình: xây core Rust mới phía sau đúng interface mà server Node.js cũ đang expose, ship nó dưới một flag kiểm soát được, và giữ server JSON-RPC như một đường fallback thường trực chứ không phải code path legacy chờ ngày xóa. Server cũ không trở thành nợ kỹ thuật để dọn sau — nó vẫn gánh tải thật cho tới khi đường mới chứng minh được là chịu được tải tương đương.
Chia công việc thành khoảng 128 pull request trong mười bốn tuần rưỡi là phần cần sự kỷ luật mà phần lớn team không có khi một cuộc rewrite được bật đèn xanh. Cách này lên kế hoạch chậm hơn, review chậm hơn, và nghĩa là phải mang hai runtime song song trong codebase suốt nhiều tháng. Cái được đổi lại là mỗi PR trong 128 PR đó có thể revert độc lập, test độc lập, và bisect độc lập nếu có gì hỏng trên production. Một PR làm giảm âm thầm độ trễ completion cho một cấu hình editor hiếm gặp sẽ bị phát hiện và rollback mà không kéo sập cả cuộc migrate. Một PR 50.000 dòng thay cả runtime trong một lần không cho bạn lựa chọn đó — khi có gì hỏng, bạn phải debug cả cuộc rewrite, không phải chỉ một PR.
Ví dụ ngược lại đáng để suy nghĩ
Cũng cần nói tới cách làm ngược lại, vì nó cũng hiệu quả. Việc Jarred Sumner viết lại phần công cụ JavaScript-sang-native của Bun từ Zig sang Rust trong khoảng mười một ngày là ví dụ nổi bật nhất gần đây về một cuộc rewrite kiểu big-bang chạy bằng agent mà vẫn thành công sạch sẽ. Sumner mô tả việc dùng Claude Code để dẫn dắt phần lớn cuộc chuyển đổi đó trong một khoảng thời gian ngắn, dồn dập, không phải một chiến dịch từng bước kéo dài. Cả hai cách đều ra được software hoạt động được. Khác biệt nằm ở phạm vi rủi ro và cấu trúc team, không nằm ở việc ai giỏi hơn. Cuộc chuyển đổi của Bun đụng tới một mảng công cụ có bán kính ảnh hưởng nhỏ hơn, gọn hơn, với một team có thể giữ toàn bộ trạng thái của cuộc rewrite trong đầu vài người. Cuộc chuyển đổi của GitHub nằm dưới một lượng người dùng trải rộng từ VS Code, Visual Studio, các IDE của JetBrains, Vim, và bất cứ nơi nào khác Copilot được ship tới — một lượng người dùng quá lớn và quá đa dạng để một người có thể suy luận hết mọi failure mode trước khi merge.
Đó mới là tiêu chí quyết định thật, và nó không liên quan gì tới việc ngôn ngữ nào tốt hơn về mặt khách quan hay team nào giỏi hơn. Rewrite kiểu big-bang hợp lý khi bán kính ảnh hưởng đủ nhỏ để một nhóm nhỏ kỹ sư giữ được toàn bộ phạm vi trong đầu, câu chuyện rollback đơn giản (revert một PR, hoặc đơn giản là không merge nó), và cái giá phải trả cho việc sai trong vài giờ là thấp. Rewrite từng bước, có fallback bảo vệ, hợp lý khi bán kính ảnh hưởng là một lượng người dùng bạn không thể liệt kê hết, hệ thống nằm trong đường hot path nhạy về độ trễ, và việc sai dù chỉ trong thời gian ngắn cũng gây ra một sự suy giảm hiển hiện cho những người dùng chưa bao giờ chọn tham gia vào cuộc migrate của bạn.
Áp dụng gì nếu bạn đang lên kế hoạch cho một cuộc migrate kiểu này
Nếu bạn đang đứng trước một cuộc migrate có hình dạng tương tự — thay một thành phần đang gánh tải cho một lượng người dùng bạn không thể quan sát hết — pattern của GitHub cho bạn một checklist cụ thể, không phải một cảm giác chung. Giữ đường cũ sống và gọi được, không lên lịch xóa nó cho tới khi đường mới đã chạy đủ lâu trên production để xứng đáng được tin. Chia cuộc migrate thành những phần nhỏ đủ để mỗi phần revert độc lập được; nếu một PR trong kế hoạch của bạn không thể revert an toàn một mình, nó đang quá lớn. Đặt đường mới sau một flag bạn kiểm soát được, để một lần regression chỉ là một thay đổi config, không phải một lần rollback deploy khẩn cấp. Và hãy thành thật về bán kính ảnh hưởng thật của bạn trước khi chọn chiến lược — câu trả lời thành thật cho phần lớn các cuộc migrate công cụ nội bộ là bán kính ảnh hưởng đủ nhỏ để cách làm từng bước trở nên thừa, còn với phần lớn hạ tầng hướng tới người dùng nằm trong đường hot path, đó lại là cách duy nhất không đánh cược với ngày làm việc của người khác.
Những con số Rust sẽ là phần được trích dẫn trong các bảng so sánh. Bài học thật sự đáng mang theo nằm ở trước đó: GitHub coi chính cuộc migrate là thứ rủi ro, không chỉ coi code đích là thứ rủi ro, và xây một quy trình cho phép nó thất bại theo từng mảnh nhỏ thay vì thất bại cùng một lúc.
Bài viết liên quan
· 5 phút đọc
ai-agents
GitHub Làm Ra Một Benchmark Để Bắt Bài AI Code Reviewer Đang “Nổ”
ReviewBench (5/10) của GitHub gồm 219 PR để bắt bài AI review code giỏi demo nhưng gãy ở production. Đáng chú ý nhất là quy trình 5 bước làm ground truth đáng tin.
Đọc tiếp
· 6 phút đọc
agentic coding
Agent của mình không quên. Nó chưa bao giờ ghi lại cái gì cả.
Một bài viết trên Hacker News về 'memory' của AI agent xuất hiện đúng tuần mình vừa debug xong một lỗi dedup thật, gây ra bởi chính cái vấn đề bài viết đó mô tả. Mình đem test lại ngay trên sự cố của chính mình.
Đọc tiếp
· 4 phút đọc
agentic coding
Claude Code Mods: viết middleware cho AI agent, cảm giác như quay về thời Express.js 2014
Anthropic vừa ra mắt TypeScript hook API cho Claude Code — prompt.submit, tool.call, turn.complete. Mình viết một mod theo dõi chi phí trong 20 phút, và nó gãy theo cách dạy mình nhiều hơn cả docs.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.