
BÀI VIẾT
GitHub Làm Ra Một Benchmark Để Bắt Bài AI Code Reviewer Đang “Nổ”
ReviewBench (5/10) của GitHub gồm 219 PR để bắt bài AI review code giỏi demo nhưng gãy ở production. Đáng chú ý nhất là quy trình 5 bước làm ground truth đáng tin.
Trong bài viết
Công cụ AI review code nào trên thị trường cũng có thể demo cho bạn xem nó bắt được một con bug mà con người bỏ sót. Không công cụ nào chịu show cho bạn những pull request mà nó bỏ sót thứ một reviewer junior cũng thấy, hoặc gắn cờ bốn mươi nitpick chẳng ai hỏi. Ngày 5/10, GitHub công bố ReviewBench, một benchmark mở dựng riêng để phơi bày nửa còn lại của câu chuyện đó: 219 pull request, lấy từ 187 repo công khai trên 19 ngôn ngữ, với ground truth đủ tin cậy để chính GitHub dùng để chấm điểm sản phẩm của mình.
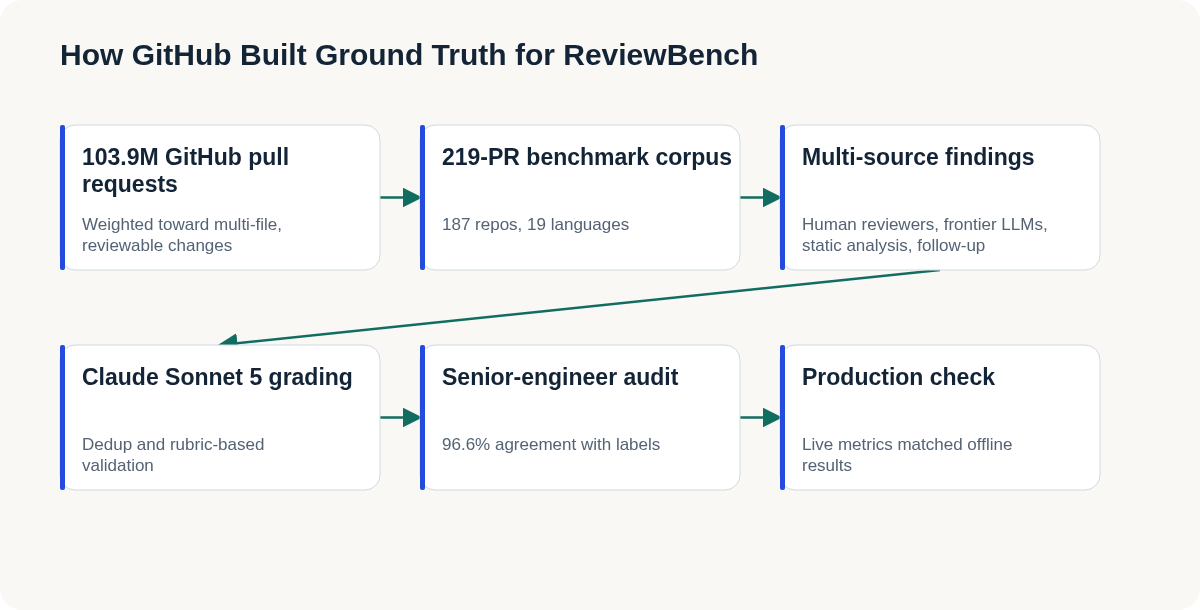
Bản thân bộ dữ liệu không phải điểm đáng nói. Benchmark nào cũng có một đống pull request. Cái đáng đọc kỹ là quy trình 5 bước GitHub dùng để quyết định thế nào mới tính là một phát hiện đúng — vì quy trình đó chính là khuôn mẫu thật sự cho bất kỳ benchmark nào bạn muốn tin đủ để hành động theo.
Xuất phát từ phân bố thật, không phải mẫu tiện tay
GitHub phân tích 103,9 triệu pull request trước khi chọn ra 219 cái lọt vào benchmark, và cố ý ưu tiên các thay đổi đa file, thực sự cần review, thay vì những diff một-file đơn giản chiếm phần lớn khối lượng PR thô. Chi tiết này quan trọng hơn vẻ ngoài của nó. Một benchmark dựng từ những PR dễ cào nhất sẽ lệch về phía thay đổi đơn giản — đúng chỗ mọi công cụ AI review đã trông có vẻ giỏi sẵn. Những ca khó, loại thực sự phân biệt được một reviewer hữu ích với một reviewer ồn ào, nằm ở các thay đổi đa file chạm vào nhiều mối quan tâm cùng lúc.
Đừng tin một nguồn duy nhất cho ground truth
Với mỗi PR, GitHub thu thập phát hiện từ bốn nguồn riêng biệt — reviewer con người, các LLM hàng đầu, công cụ static analysis, và chính các commit sửa tiếp theo của tác giả — rồi khử trùng lặp theo ngữ nghĩa và xác thực lại theo một rubric chung, dùng Claude Sonnet 5 làm mô hình chấm điểm. Chi tiết cuối này đáng dừng lại suy nghĩ: một mô hình AI đang làm một phần việc quyết định thế nào là câu trả lời đúng trong một benchmark sẽ được dùng để chấm điểm các mô hình AI khác. Câu trả lời của GitHub cho phản biện hiển nhiên đó nằm ở bước tiếp theo.
Kiểm toán cả người kiểm toán
Trước khi phát hành, các kỹ sư senior tự tay gán nhãn lại ground truth một cách độc lập, rồi so với nhãn của ReviewBench — tỉ lệ đồng thuận 96,6%. Đây mới là con số khiến bước chấm điểm bằng Claude Sonnet 5 trở nên đứng vững thay vì tự biện minh vòng tròn. Đây cũng là con số mà đa số team bỏ qua khi tự xây bộ eval nội bộ: chọn một mô hình chấm điểm, tin kết quả của nó, rồi không bao giờ đối chiếu lại với một người làm cùng việc đó một cách độc lập. Tỉ lệ đồng thuận 96,6% đạt được theo cách này là một tuyên bố mạnh hơn nhiều so với một benchmark chỉ đơn giản khẳng định nhãn của mình là đúng.
ReviewBench cũng báo cáo sáu chỉ số riêng biệt thay vì gộp thành một điểm duy nhất: precision, recall và F1 đo theo golden set cố định, cộng thêm phiên bản mở rộng của mỗi chỉ số để ghi nhận khi công cụ tìm ra vấn đề thật mà golden set bỏ sót. Kết quả lọc được theo mức độ nghiêm trọng — Critical, Medium, Low — và theo nhóm: Correctness, Security, Reliability, Maintainability, Testing. Một công cụ điểm cao ở Maintainability mức Low chẳng nói lên gì về việc nó có bắt được lỗi Security mức Critical thực sự quan trọng hay không. Gộp hết vào một con số leaderboard duy nhất chính là cách benchmark kết thúc bằng việc đo rất kỹ một thứ không quan trọng.
Đối chiếu với production, không chỉ tự soi mình
Bước mà hầu hết benchmark không bao giờ làm: GitHub chạy một thử nghiệm ensemble đa mô hình rồi so số liệu offline của ReviewBench với những gì thực sự xảy ra khi cùng thay đổi đó lên production. Addressed rate — một proxy thô cho precision, vì nó theo dõi tần suất một vấn đề bị gắn cờ thực sự được sửa — tăng 8,0% ở cả đo lường offline lẫn online. Recall cải thiện 13,6%. Số lượng comment tăng 61%, và comment mức critical tăng 227% ở offline so với 262% ở production — không khớp tuyệt đối, nhưng cùng hướng, và đó mới là tiêu chuẩn quan trọng. Chi phí mỗi lượt review giảm 8,0%. Cách GitHub tự diễn giải khá thẳng: “các thay đổi offline luôn chỉ cùng một hướng với những gì chúng tôi thấy sau đó ở production.” Đây là một benchmark tự nhận là có tính dự đoán, kèm bằng chứng đối chiếu công khai, chứ không phải một benchmark tự nhận là tuyệt đối đúng.
Nếu đang chọn công cụ review code, nên làm gì với thông tin này
Đừng tin ngay con số độ chính xác trên trang chủ của bất kỳ nhà cung cấp nào, kể cả Copilot Code Review của chính GitHub — công ty này đã dùng chính benchmark này để đánh giá nội bộ qua nhiều phiên bản, đó là bối cảnh hữu ích chứ không phải bằng chứng công cụ không bị thiên vị bởi chính benchmark nó được tinh chỉnh theo. Hỏi bên bán cho bạn bộ eval bốn câu: tập test được lấy mẫu từ phân bố thực tế nào, có bao nhiêu nguồn độc lập đóng góp vào ground truth, ai kiểm toán nhãn và tỉ lệ đồng thuận là bao nhiêu, và đã ai đối chiếu điểm offline với những gì thực sự lên production chưa. ReviewBench trả lời công khai cả bốn câu. Đa số benchmark của nhà cung cấp không trả lời câu nào, và khoảng cách giữa hai trạng thái đó mới chính là thứ bạn đang mua khi chọn một công cụ review code.
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.