
BÀI VIẾT
Cloudflare xây agent bảo mật tự kiểm tra trích dẫn trước khi analyst nhìn thấy
Harness Managed Defense mới của Cloudflare thừa nhận prototype đầu tiên bị hallucinate, rồi thiết kế lại quanh việc kiểm chứng trích dẫn bằng code thay vì tin một agent lớn.
Trong bài viết
Ngày 7/10/2026, hai kỹ sư Cloudflare Deanna Tran và Blake Darché đăng một bài blog với lời thừa nhận hiếm thấy từ một vendor: phiên bản đầu tiên của AI security analyst họ xây bị hallucinate. Không phải thỉnh thoảng. Đủ nhiều để họ bỏ hẳn thiết kế cũ, xây lại theo một nguyên tắc khác — model không được phép khẳng định điều gì mà con người không truy ngược được về một bằng chứng cụ thể.
Hệ thống này là một agentic harness nằm trong sản phẩm Managed Defense của Cloudflare, hiện đang ở giai đoạn early beta, chỉ mở cho khách hàng enterprise qua đội account. Không self-serve, và cũng không phải là Clef — dòng decision model mã nguồn mở Cloudflare ra mắt cùng tuần đó. Clef là một classifier đa dụng bạn tự chạy được trên Workers AI. Còn SOC harness này là một ứng dụng nội bộ cụ thể, dùng Clef như một thành phần trong số nhiều thành phần khác. Đáng tách bạch hai thứ này, vì chính changelog Workers AI của Cloudflare liệt kê một ví dụ định tuyến ticket chạy “không cần con người trong vòng lặp” — một use case hoàn toàn khác, mức rủi ro hoàn toàn khác so với một cuộc điều tra bảo mật. SOC harness không vận hành theo kiểu đó, và gộp chung hai thứ sẽ mô tả sai cả hai.
Recon trước, inference sau
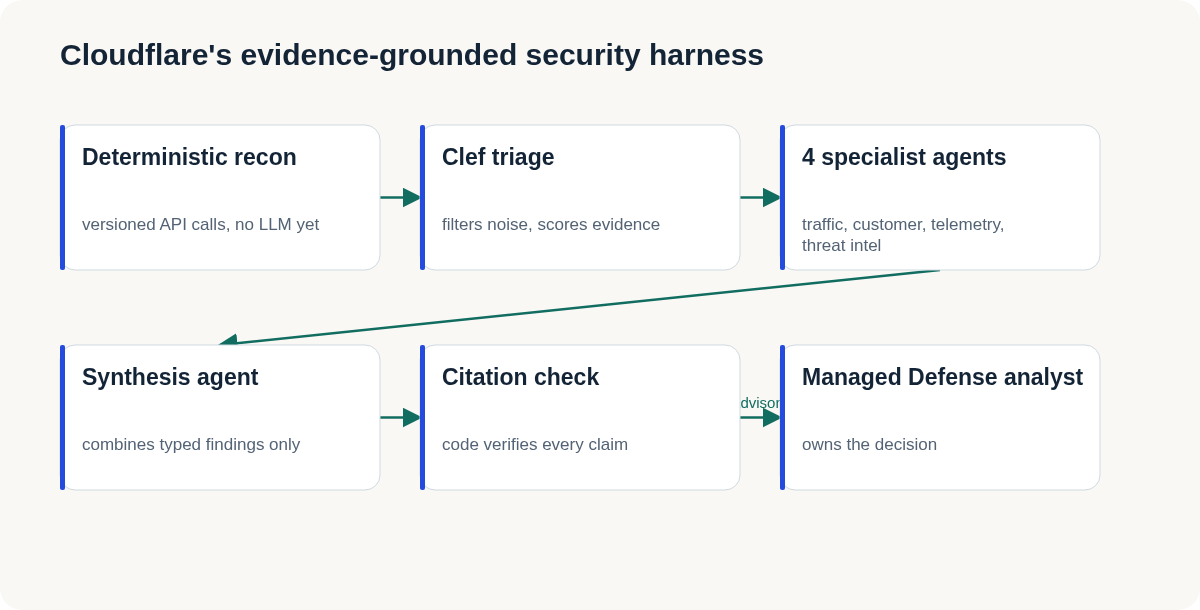
Kiến trúc bắt đầu từ chỗ không hào nhoáng chút nào: trước khi gọi bất kỳ LLM nào, code xác định sẵn (deterministic) chạy một tập workflow trinh sát cố định qua các API đã versioned. Không model nào quyết định tra cứu cái gì trước. Một script làm việc đó. Chỉ khi bằng chứng đã tồn tại, Clef mới vào cuộc — thật ra là hai lần. Lần đầu lọc nhiễu trên output trinh sát thô, lần sau chấm điểm xem bằng chứng thu thập được đã đủ chưa, trước khi các bước reasoning tốn kém bắt đầu.
Thứ tự này mới là bài học thiết kế thật sự ở đây, quan trọng hơn bất kỳ lựa chọn công cụ cụ thể nào. Đa số pipeline agent mình thấy đều gọi model ngay lập tức vì đó là phần vui để xây. Đội Cloudflare làm phần nhàm chán, kiểm chứng được trước, và chỉ cho inference chạm vào dữ liệu đã được một script thu thập qua một đường cố định, review được. Nếu có gì sai, bạn replay lại bước trinh sát độc lập với bất cứ điều gì model nói.
Vì sao một agent duy nhất không đủ
Đây là câu đáng dừng lại đọc kỹ: “Prototype đầu tiên của chúng tôi cho thấy giới hạn của một agent đa dụng duy nhất. Nó tạo ra phân tích hữu ích, nhưng cũng hallucinate những khẳng định mà bằng chứng không hỗ trợ.” Đó là một đội thừa nhận bản năng đầu tiên của họ — một model đủ mạnh làm hết cả cuộc điều tra — không trụ được trước thứ mà công việc bảo mật thật sự cần: khẳng định sống sót qua audit, không phải khẳng định nghe có vẻ hợp lý.
Cách sửa không phải là model to hơn hay system prompt dài hơn. Mà là phân rã công việc cộng với một lớp kiểm chứng không phải model. Bốn specialist agent chạy song song, mỗi agent phạm vi hẹp: phân tích traffic, ngữ cảnh khách hàng, telemetry toàn cục, threat intelligence. Không agent nào trong số đó viết advisory cuối cùng. Một synthesis agent riêng gộp các phát hiện đã được type-hoá của chúng lại — và Cloudflare xây agent này sao cho nó không thể tự đi lấy bằng chứng mới hay chọn một phân loại nằm ngoài danh sách được duyệt sẵn. Nó chỉ được sắp xếp lại những gì các specialist đã tìm ra.
Rồi đến phần thật sự giải quyết vấn đề hallucination: trước khi bất cứ thứ gì tới tay con người, code ứng dụng — không phải model — kiểm tra từng trích dẫn trong output có tồn tại thật, có thuộc đúng cuộc điều tra này, và có thật sự hỗ trợ cho khẳng định đi kèm nó hay không. Nếu một trích dẫn không qua được kiểm tra, khẳng định đó không được xuất ra. Cả mẹo chỉ có vậy. Bạn không nhờ một LLM thứ hai chấm bài cho LLM thứ nhất rồi hy vọng nó trung thực hơn. Bạn viết một bộ kiểm tra xác định cho đúng một thứ quan trọng nhất: trích dẫn này có trỏ tới cái gì có thật hay không.
Chỉ tư vấn, không tự hành động — và họ nói rõ điều đó
Cloudflare nói thẳng đây chỉ là tư vấn: “Harness tạo ra một bản advisory và không hành động thay cho Managed Defense Analyst”, và “Managed Defense Analyst vẫn chịu trách nhiệm cho quyết định và mọi biện pháp xử lý.” Không có con số nào được công bố về việc hệ thống này tiết kiệm bao nhiêu thời gian cho analyst, hay bước kiểm tra trích dẫn thực sự chặn được bao nhiêu khẳng định sai trước khi xuất ra — Cloudflare không công bố cả hai, và mình sẽ không đoán mò. Thứ họ công bố là lý do thiết kế, mà thật ra hữu ích hơn một con số accuracy được chọn lọc kỹ càng.
Điều mình sẽ áp dụng cho các pipeline agent khác
Nếu bạn đang xây bất cứ thứ gì mà output của agent cần sống sót qua sự săm soi — compliance, incident response, báo cáo tài chính, review pháp lý — mô hình ở đây áp dụng được rộng hơn ngoài bảo mật. Tách thu thập bằng chứng khỏi reasoning, và làm cho bước thu thập xác định được, replay được. Đừng để bước synthesis bịa ra fact mới; giới hạn nó chỉ được sắp xếp lại những gì các bước trước đã kiểm chứng. Và xây bộ kiểm tra trích dẫn bằng code ứng dụng thuần, không phải một lần gọi model khác, vì model kiểm tra model chỉ đẩy rủi ro hallucination xuống một bước sau chứ không loại bỏ nó. Phần thật sự đáng chú ý trong kiến trúc này không phải là Cloudflare dùng bốn agent thay vì một. Mà là họ không tin bất kỳ agent nào tự chấm bài cho chính nó.
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.