
BÀI VIẾT
Kubernetes vừa đổi một default khiến node cũ của bạn không boot lên được
Field failCgroupV1 của kubelet đổi default thành true từ bản 1.35. Node chỉ chạy cgroup v1 giờ không khởi động được nữa trừ khi bạn override. Cách kiểm tra ngay hôm nay.
Trong bài viết
Một field trong cấu hình kubelet mà gần như không ai từng gõ tay, `failCgroupV1`, vừa đổi default từ false sang true kể từ Kubernetes 1.35. Đây không phải một lần gỡ bỏ. Nó âm thầm hơn, và với nhiều cluster thì còn gây xáo trộn hơn: một node vẫn đang chạy cgroup v1 giờ sẽ từ chối khởi động trừ khi bạn chủ động override field này. Nếu node image của bạn được build từ hai ba năm trước và chẳng ai đụng vào base image từ đó tới giờ, đây đúng kiểu thay đổi sẽ hiện ra dưới dạng một lần upgrade thất bại lúc 2 giờ sáng, chứ không phải thứ ai lên kế hoạch thời gian xử lý trước.
Đề xuất liên quan là KEP-5573, “Remove cgroup v1 support”, xây trên nền KEP-4569 (cgroup v1 chuyển sang maintenance mode, GA từ bản 1.31). Mình muốn đính chính một chi tiết hay bị lặp lại sai trong nhiều bài đưa tin: KEP này không cam kết gỡ hỗ trợ v1 ở đúng bản 1.38. Nguyên văn là việc gỡ bỏ “sẽ được thực hiện không sớm hơn 1.38, để giữ đúng chính sách deprecation của k8s”. Ngay trong KEP còn có một đánh dấu chưa giải quyết (unresolved), cho thấy kế hoạch gỡ bỏ vẫn đang được các maintainer SIG Node bàn. Nên cách nói trung thực là một mốc sàn, không phải một ngày cụ thể: không có gì trước 1.38, và cũng chưa có mục tiêu cam kết sau đó.
Vì sao việc đổi default quan trọng hơn cả thời điểm gỡ bỏ cuối cùng
Cái ngày gỡ bỏ chưa rõ ràng gần như là một chi tiết gây xao nhãng so với thứ đã thật sự ra mắt rồi. `failCgroupV1` chuyển default thành true từ bản 1.35 nghĩa là ngay bây giờ, upgrade kubelet trên một node cgroup v1 chưa được audit có thể khiến node đó rớt khỏi cluster của bạn. Bạn không có một chu kỳ cảnh báo deprecation như bạn nghĩ cho trường hợp này — kubelet đơn giản là không khởi động sạch trên host chỉ có v1 trừ khi override đã được bật. Kiểm tra điều này trước lần upgrade kubelet tiếp theo, đừng để sau mới kiểm tra.
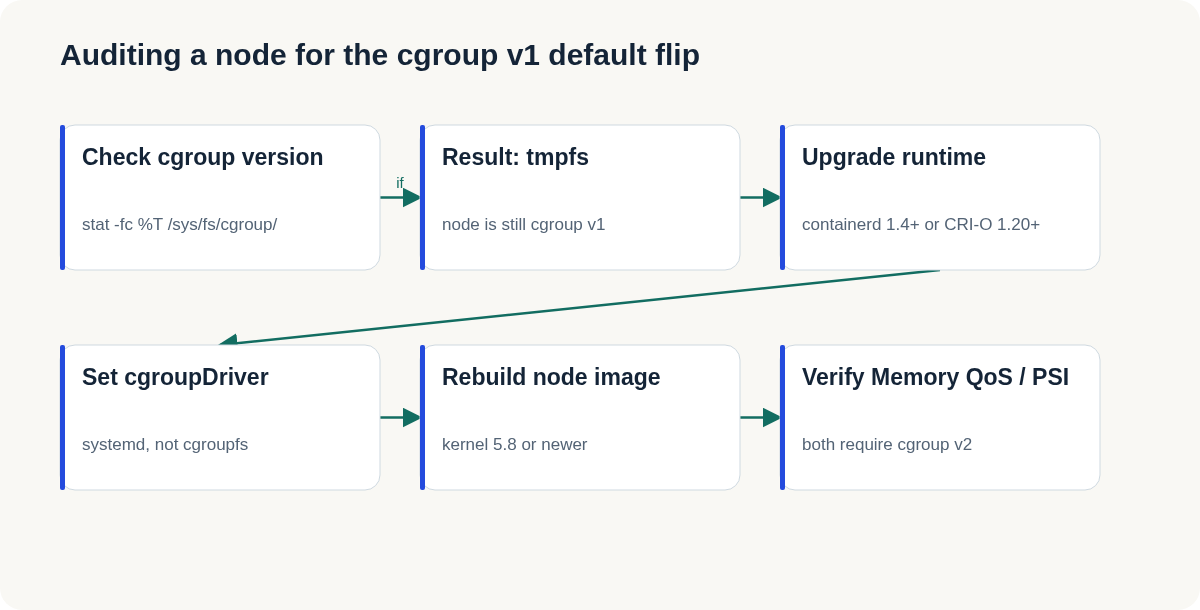
Cách kiểm tra chỉ gói trong một lệnh, chạy trên node:
stat -fc %T /sys/fs/cgroup/Kết quả `cgroup2fs` nghĩa là bạn đã ở v2, ổn. Kết quả `tmpfs` nghĩa là node vẫn đang ở v1 và bạn cần lên kế hoạch migrate trước khi đụng vào phiên bản kubelet mới. Chạy lệnh này trên toàn bộ fleet node ngay bây giờ, đừng để tới lúc xử lý sự cố mới chạy. Chỉ mất năm phút audit mà biến một lần downtime bất ngờ thành một đợt migrate có lịch hẳn hoi.
Migrate thật sự cần những gì
Cgroup v2 cần kernel Linux từ 5.8 trở lên, containerd từ 1.4 trở lên (hoặc CRI-O từ 1.20 trở lên), và cgroup driver của kubelet phải đặt là `systemd` thay vì driver `cgroupfs` cũ — chính tài liệu container runtime của Kubernetes nói rõ cgroupfs là lựa chọn sai một khi đã dùng v2. Đa số distro phổ biến đã chuyển sang v2 làm mặc định từ nhiều năm trước, nên nếu node image của bạn đến từ bản Ubuntu, Debian hay RHEL hiện hành, nhiều khả năng bạn đã ổn. Rủi ro nằm cụ thể ở những golden image cũ, đóng băng từ lâu — loại được build một lần rồi không ai rebuild lại vì “nó vẫn chạy mà”.
Bạn mất gì nếu vẫn ở v1 dù override vẫn còn chạy được
Kể cả gạt chuyện override sang một bên, cgroup v1 vẫn đang âm thầm tụt lại về những tính năng quan trọng cho độ ổn định production. Memory QoS (KEP-2570, beta và default-on từ bản 1.37) yêu cầu rõ ràng cgroup v2 — không khả dụng trên node v1, chấm hết. Pressure Stall Information cũng cần cgroup v2; feature gate của PSI đã khoá về true từ bản 1.36, nhưng nó không cho ra kết quả gì hữu ích trên host v1. Và xử lý OOM thật sự tốt hơn dưới v2: nó có thể kill cả một process group như một đơn vị thông qua `memory.oom.group`, trong khi v1 chỉ kill được từng process riêng lẻ, dễ khiến container rơi vào trạng thái nửa sống nửa chết thay vì restart sạch sẽ.
Kubernetes managed không nhất thiết đã đi trước bạn ở khoản này
Nếu bạn dùng dịch vụ managed, hãy kiểm tra đúng provider của mình thay vì mặc định tin rằng họ đã lo xong. GKE công bố timeline cụ thể nhất trong ba cloud lớn: cgroup v2 trở thành default cho node pool mới từ bản 1.26, v1 bị đánh dấu deprecated ở bản 1.31, cluster hiện có được auto-migrate ở bản 1.33, và GKE bỏ hẳn hỗ trợ v1 ở bản 1.35. Ngược lại, EKS chưa công bố ngày gỡ bỏ — chính FAQ deprecation AMI của AWS nói rõ ngày gỡ bỏ hoàn toàn “chưa được công bố”, dù vẫn khuyến nghị migrate sang AL2023, Bottlerocket, RHEL9+, Ubuntu 22.04+ hoặc Debian 11+. AKS xác nhận v2 đã là default từ Kubernetes 1.25 và có DaemonSet rollback, nhưng mình không tìm thấy timeline gỡ bỏ trong tương lai được Microsoft công bố để trích dẫn ở đây, nên mình sẽ không tự bịa ra.
Nếu bạn tự quản lý node — kOps, kubeadm, bare metal — thì mấy timeline của dịch vụ managed ở trên đằng nào cũng không áp dụng cho bạn, và việc đổi default `failCgroupV1` ở bản 1.35 mới chính là thứ cắn bạn trước tiên. Chạy lệnh `stat` kiểm tra trên toàn fleet ngay tuần này. Tốn năm phút mỗi node, còn phương án ngược lại là phát hiện ra vào đúng lần upgrade kubelet tiếp theo — thời điểm tệ hơn nhiều để phát hiện.
Bài viết liên quan
08 Oct 2026 · 6 phút đọc
ai-agents
Cloudflare xây agent bảo mật tự kiểm tra trích dẫn trước khi analyst nhìn thấy
Harness Managed Defense mới của Cloudflare thừa nhận prototype đầu tiên bị hallucinate, rồi thiết kế lại quanh việc kiểm chứng trích dẫn bằng code thay vì tin một agent lớn.
Đọc tiếp08 Oct 2026 · 5 phút đọc
ai-agents
Claude Haiku 5.5 và bài toán chi phí thật khi route model rẻ
Haiku 5.5 rẻ hơn 75% và giỏi hẳn ở task agent, nhưng tokenizer mới ăn bớt phần tiết kiệm — số thật không như quảng cáo.
Đọc tiếp
06 Oct 2026 · 6 phút đọc
agentic coding
Agent của mình không quên. Nó chưa bao giờ ghi lại cái gì cả.
Một bài viết trên Hacker News về 'memory' của AI agent xuất hiện đúng tuần mình vừa debug xong một lỗi dedup thật, gây ra bởi chính cái vấn đề bài viết đó mô tả. Mình đem test lại ngay trên sự cố của chính mình.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.