
BÀI VIẾT
Claude Haiku 5.5 và bài toán chi phí thật khi route model rẻ
Haiku 5.5 rẻ hơn 75% và giỏi hẳn ở task agent, nhưng tokenizer mới ăn bớt phần tiết kiệm — số thật không như quảng cáo.
Trong bài viết
Anthropic ra mắt Claude Haiku 5.5 ngày 7/10/2026, và con số quan trọng nhất với ai đang chạy agent loop ở quy mô lớn nằm im trong bảng giá: $0.10 cho mỗi triệu input token, $0.50 output — so với $2 và $10 của Sonnet 5.5. Đây không phải giảm giá nhẹ. Đây là một hạng mục chi phí khác hẳn.
Điểm benchmark cũng xác nhận điều đó. OSWorld 2.1 nhảy từ 15.7% (Haiku 4.5) lên 72.4% (Haiku 5.5). Terminal-Bench 4.0 từ 0.0% thẳng lên 39.2%. GDPval-AA — benchmark riêng của Anthropic đo hiệu suất trên các task nghề nghiệp thực tế — tăng từ 735 lên 1620 Elo, tức gần gấp đôi về mặt kỹ năng tương đối. Đây không phải sai số làm tròn. Đây là ranh giới giữa “đừng route subtask agent qua model này” và “nên cân nhắc thật”. Anthropic bán Haiku 5.5 đúng theo hướng đó: một model đủ rẻ cho việc khối lượng lớn, cần độ trễ thấp — phân loại, trích xuất, định tuyến, gọi subagent — nhưng lần đầu tiên cũng đủ giỏi cho các task terminal và computer-use vốn trước giờ cần model to hơn.
Mình tin vào cái pitch đó. Nhưng mình không tin con số giảm giá trên tiêu đề là toàn bộ câu chuyện.
Khoản thuế tokenizer mà thông báo không nhắc tới
Simon Willison test ngay trong ngày ra mắt và phát hiện một điều trang chính thức của Anthropic không hề đề cập: Haiku 5.5 dùng tokenizer mới, và nó kém hiệu quả hơn rõ rệt. Cùng một prompt dài, Haiku 5.5 tốn khoảng 1.25 lần số token so với Haiku 4.5. Đem con số này đối chiếu với tuyên bố “rẻ hơn khoảng 75%”, mức tiết kiệm thật trên các tác vụ context dài rơi về gần 60% thay vì 75%. Vẫn tốt. Chỉ không phải con số ghi trên landing page.
Đây là phần một tech lead cần tự tính trước khi đổi model trong pipeline production: chạy thử chính prompt thật của mình qua cả hai tokenizer rồi so token bị tính tiền, đừng tin giá niêm yết trên triệu token. Một model rẻ hơn 5 lần mỗi token nhưng tốn thêm 1.25 lần token cho đúng workload của bạn thì không còn là lợi 5 lần nữa — gần với 4 lần thôi. Vẫn đáng làm. Chỉ cần tính bằng prompt thật của mình, không phải prompt mẫu trong bài quảng cáo.
Reasoning không tắt được
Chi tiết đáng chú ý khác: Haiku 5.5 mặc định reasoning effort ở mức “medium”, và bạn không tắt hẳn reasoning được. Bài test pelican-SVG của Willison chạy 7 giây, tốn chưa tới một phần mười cent ở effort thấp nhất — nhưng 5 phút 9 giây và 3.4 cent ở effort cao nhất, trên cùng một prompt. Với một model được quảng bá vì tốc độ và khối lượng lớn, đây là một mâu thuẫn thiết kế thật sự. Nếu use case của bạn là “phân loại ticket hỗ trợ trong dưới 200ms”, hãy test xem effort tối thiểu thực sự tốn bao nhiêu độ trễ và token, vì sàn không phải là 0.
Có mặt khắp nơi — điều này quan trọng hơn vẻ ngoài
Haiku 5.5 ra mắt cùng lúc trên nền tảng Claude, AWS Bedrock, Google Cloud Vertex và Microsoft Foundry. Với một model ở phân khúc giá rẻ, việc có mặt đa cloud ngay ngày đầu quan trọng vì đây chính là model bạn sẽ gọi hàng triệu lần. Khoản discount committed-spend bạn đã đàm phán sẵn trên AWS hay Azure giờ trở thành đòn bẩy thật, không còn là chi tiết phụ. Đây là phép tính khác hẳn so với việc gắn bó một model reasoning đỉnh cao, nơi đội ngũ sẵn sàng chấp nhận lock-in một cloud để đổi lấy năng lực. Một model hạng phổ thông có mặt khắp nơi ngay từ đầu cho thấy nó được thiết kế để cạnh tranh bằng tổng chi phí sở hữu — gồm cả hợp đồng bạn đã ký — chứ không chỉ giá trên mỗi token trong biểu đồ.
Mình sẽ route Haiku 5.5 vào đâu
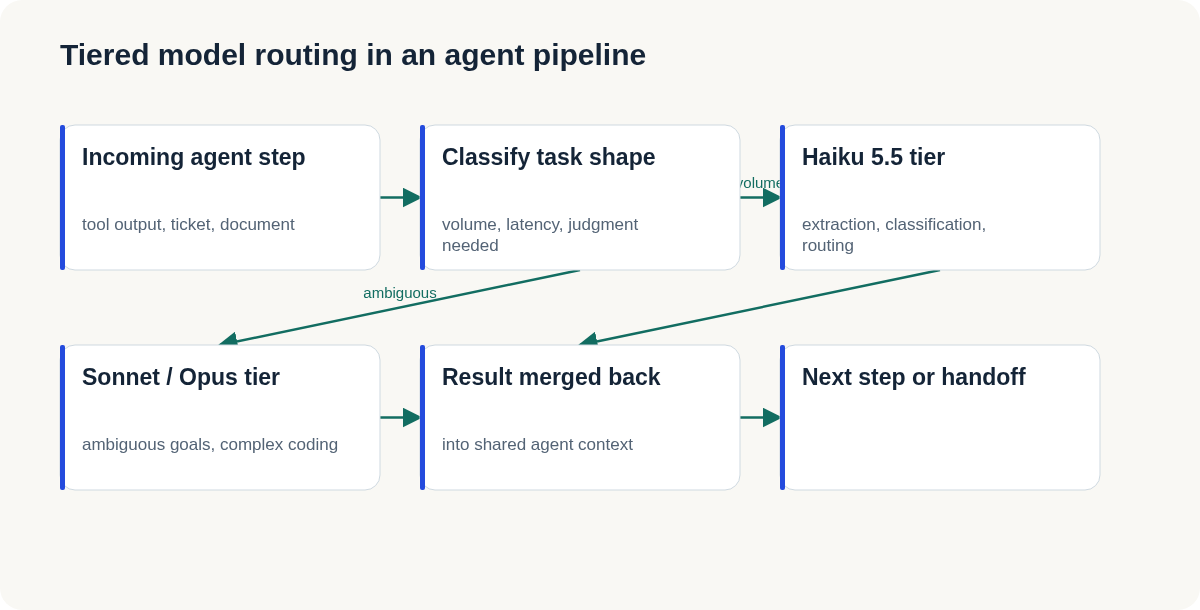
Tài liệu chính thức của Anthropic cũng thẳng thắn về giới hạn — Sonnet 5.5 và Opus 5.5 “vẫn là lựa chọn tốt hơn cho các task coding agentic phức tạp”. Mình tin điều đó. Chỗ Haiku 5.5 xứng đáng với giá của nó là phần giữa nhàm chán, khối lượng lớn trong pipeline agent: tóm tắt output của tool trước khi đưa vào context của model to hơn, phân loại xem bước tiếp theo cần hành động nào trong mười lựa chọn, chạy cùng một prompt trích xuất trên mười nghìn tài liệu. Không phải bước mà agent phải tự quyết định làm gì tiếp theo với hướng dẫn mơ hồ.
Asana báo cáo giảm hơn 30% độ trễ và nhanh hơn tới 2.5 lần mỗi lượt inference của agent sau khi chuyển sang Haiku 5.5, còn HubSpot đạt 92.8% trên bộ task audit CRM của riêng họ — cả hai đều là số liệu khách hàng đăng trên trang Anthropic, không phải benchmark độc lập, nên xem như định hướng chứ chưa phải bằng chứng. Nhưng chúng khớp với những gì giá và benchmark gợi ý: Haiku 5.5 là một bước nâng cấp thật cho phần kiến trúc agent chạy liên tục và không cần phán đoán.
Nếu bạn đang xây hệ multi-agent lúc này, đây chính là lý do nên có một lớp định tuyến theo tầng thay vì để một model duy nhất nhận mọi cuộc gọi: phân loại dạng task trước, rồi mới quyết định cần tốc độ của Haiku hay phán đoán của Sonnet. Haiku 5.5 vừa kéo ranh giới đó xa hơn bao giờ hết. Nhưng nó kéo cho phần việc hẹp, rõ ràng — không phải cho mọi thứ trước giờ quá đắt để tự động hoá.
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.