
BÀI VIẾT
4. Chứng minh model chatbot nhỏ có đủ tốt không
Tạo bộ test độc lập, chấm câu trả lời có căn cứ và đo chất lượng, chi phí, coverage cùng lúc.
Trong bài viết
Kỹ thuật Chatbot · Bài 4 trong 9 bài · Nguồn được đối chiếu ngày 7 tháng 10 năm 2026. Thiết kế và giả định đề xuất được phân biệt với kết quả triển khai đã đo.
“Chất lượng tương đương” phải là hiệu quả tương đương trên workload xác định, với mức sai khác được nêu rõ. Model local có thể ngang model mạnh hơn ở tác vụ chọn chỉ số giới hạn nhưng vẫn thất bại trong suy luận chưa quen. Đánh giá cần làm rõ ranh giới đó.
Tạo bộ test độc lập
Tách training, development và bộ test khóa trước khi chỉnh model. Khi phù hợp, chia theo khách hàng, tài liệu nguồn, nhóm quy trình và thời gian. Các cách diễn đạt gần trùng nhau của cùng một yêu cầu nguồn phải ở cùng nhóm dữ liệu. Nếu không, test chủ yếu đo khả năng nhận ra ví dụ model gần như đã thấy.
Dùng người viết độc lập hoặc yêu cầu thật đã loại thông tin nhạy cảm cho bộ khóa. Bao gồm câu tiếng Việt ngắn, trộn ngôn ngữ, thiếu ngày, thuật ngữ không nhất quán, tài liệu cũ, yêu cầu không thể thực hiện và ranh giới quyền. Giữ bộ challenge riêng cho hành vi đối kháng. Bộ này kiểm tra lỗi cụ thể; phân bố nhãn của nó không đại diện lưu lượng production.
Chấm công việc thay vì văn phong
Với data agent, so sánh mã chỉ số, bộ lọc, cách nhóm, giá trị kết quả và phạm vi được phép. Với câu trả lời tài liệu, kiểm tra đoạn trích hỗ trợ từng khẳng định quan trọng và người dùng được quyền truy cập nguồn. Với chuẩn bị hành động, so sánh đối tượng và tham số mà không thực thi.
| Thước đo | Câu hỏi được giải đáp |
|---|---|
| Tác vụ chính xác | Hệ thống có hoàn thành đúng yêu cầu? |
| Căn cứ và nguồn trích hợp lệ | Khẳng định có kiểm tra được từ bằng chứng được phép? |
| Coverage tại ngưỡng chất lượng | Bao nhiêu công việc hoàn tất mà không cần escalation? |
| Chấp nhận sai / từ chối sai | Hệ thống làm sai hay chặn công việc có ích? |
| p95 latency và chi phí tác vụ thành công | Dịch vụ có khả thi dưới tải đã nêu? |
So sánh theo từng cặp
Chạy mỗi ứng viên trên cùng đầu vào, snapshot bằng chứng và kết quả tool. Ghi revision model, prompt, sampling settings, kích thước context và runtime. Đưa cho người chấm đầu ra đã ẩn danh theo thứ tự ngẫu nhiên. Người review cần kiểm tra bất đồng và lỗi ảnh hưởng lớn thay vì coi LLM judge là đáp án tuyệt đối.
Quy tắc non-inferiority minh họa là tỷ lệ tác vụ thành công của model nhỏ không thấp hơn model tham chiếu quá hai điểm phần trăm, với khoảng tin cậy định trước và đủ ví dụ để kết luận. Chọn cỡ mẫu theo tỷ lệ lỗi dự kiến và phép kiểm định. Khoảng mười hai ví dụ không đủ chứng minh chênh lệch hai điểm phần trăm.
Đánh giá abstention cùng routing
Router chuyển mọi yêu cầu sang model mạnh không giảm được nhiều chi phí. Router chuyển tất cả vào nhánh rẻ có thể che giấu lỗi chính xác tốn kém. Vẽ coverage được chấp nhận theo tỷ lệ lỗi khi đổi ngưỡng trên development set, rồi khóa ngưỡng trước test cuối.
Báo cáo dự đoán thô và kết quả sau chính sách riêng biệt. Lỗi model, câu hỏi làm rõ và can thiệp bảo mật có nguyên nhân khác nhau. Chỉ hiệu chuẩn xác suất trên dữ liệu held-out đại diện; khoảng cách giữa các điểm classifier không tự trở thành xác suất câu trả lời đúng.
Các lỗi của demo hiện tại rất đáng xem
Case study CPU đạt 11 route chatbot thô đúng trên 12 ví dụ held-out và bảy route agent thô đúng trên tám ví dụ. Sau chính sách margin, kết quả agent trên LXC là sáu trên tám. Cùng tác giả viết dữ liệu train và test nên kết quả chỉ mang tính minh họa.
“Vẽ sơ đồ microservices” được phân loại là yêu cầu diagram nhưng sau đó bị chuyển sang làm rõ vì margin nhỏ. “Giúp tôi với” đáng lẽ cần hỏi rõ nhưng lại đi vào route sản phẩm. Điều này cho thấy ngưỡng bảo vệ có thể giảm tính hữu ích và sự mơ hồ cần đánh giá riêng. Case study có kết quả đo, bằng tiếng Anh.
Test toàn bộ hệ thống
Điểm model riêng lẻ bỏ qua retrieval, kiểm tra quyền, tool timeout, retry frontend và hiển thị. Test thiếu bằng chứng, database không khả dụng, session hết hạn, hủy request ở trình duyệt và bị quota từ chối. Lỗi có ích cần giải thích việc đã xảy ra và cách khôi phục phù hợp mà không bịa kết quả.
Dùng dữ liệu canary tenant giả lập để test cô lập ngoài production. Xác minh nội dung không được phép không đi vào prompt, cache hay export. Test connection đã warm được dùng lại sau truy vấn tenant khác. Bao gồm structured output sai định dạng và yêu cầu trông hợp lệ nhưng dùng chiều phân tích bị cấm.
Chỉ phát hành khi có bằng chứng
Duy trì báo cáo release gồm hash dataset, phiên bản ứng viên, điểm theo tác vụ, từng ngôn ngữ, lỗi, phân bố độ trễ, giả định chi phí và quyết định go/no-go rõ ràng. Chạy shadow trước khi quyền và privacy cho phép, rồi canary một phần lưu lượng với khả năng rollback ngay.
# Proposed report fields; fill only from actual runs
model_revision: ...
prompt_revision: ...
dataset_sha256: ...
hardware_and_concurrency: ...
schema_valid_count / total: ...
correct_tasks / total: ...
en_success / en_total: ...
vi_success / vi_total: ...
accepted_coverage_and_error_rate: ...
unauthorized_disclosures_observed: ...
p50_ms / p95_ms / peak_memory_mb: ...
total_cost_usd / successful_tasks: ...
known_failures_and_release_decision: ...
Mẫu trên là các trường báo cáo đề xuất; chỉ điền từ lần chạy thực tế. Không liên tục chỉnh theo bộ test khóa. Khi lỗi mới trở thành ví dụ regression, dành thêm ví dụ độc lập cho release tiếp theo. Evaluation là tài sản sản phẩm cần duy trì, không phải ảnh chụp một điểm số thuận lợi.
Thực hành: tạo bộ đánh giá Commerce Assist
Gán ID bất biến cho mỗi case, tách đầu vào khỏi kết quả mong đợi. Case cần ngôn ngữ, phạm vi người dùng, nguồn được phép, snapshot, thời điểm request, plan hoặc clarification mong đợi, kết quả và mức nghiêm trọng. Người chấm không thấy tên model. Tenant kỳ vọng nằm trong harness, không nằm trong text model sửa được.
{
  "case_id": "revenue-compare-vi-001",
  "language": "vi",
  "authenticated_workspace": "alpha",
  "request": "So sánh doanh thu thuần tháng 9/2026 với tháng Tám",
  "expected_metric": "net_revenue_v1",
  "expected_periods": [
    ["2026-09-01", "2026-10-01"],
    ["2026-08-01", "2026-09-01"]
  ],
  "expected_cents": [20000, 10000],
  "expected_difference_cents": 10000,
  "severity": "financial_accuracy",
  "fixture_kind": "synthetic"
}
Thêm case tiếng Anh cùng plan mong đợi, không chỉ cùng keyword. Thêm biến thể thực sự mơ hồ như “So sánh tình hình tháng trước” khi chưa có chỉ số mặc định. Kết quả mong đợi là hỏi rõ. Model trả con số fixture cho biến thể này phải bị chấm sai dù số tình cờ đúng.
Chấm xác định khi đầu ra khách quan
Parse plan, validate schema và so ngày đã chuẩn hóa, phiên bản chỉ số, grouping được phép. So cent nguyên chính xác. Alias chỉ được thông qua bản đồ chuẩn hóa có phiên bản, không dùng grader tùy hứng cứu ứng viên ưa thích. Với câu trả lời, chấm khẳng định riêng: số tiền đúng, kỳ đúng, so sánh có căn cứ và không tự suy nguyên nhân.
Chấm citation bằng truy nguồn và kiểm tra đoạn trích hỗ trợ khẳng định. Có URL chưa đồng nghĩa grounding. Chấm phân quyền bằng bằng chứng thực tế đưa vào model và dòng tool trả về. Câu cuối đúng vẫn có thể fail bảo mật nếu bằng chứng cấm đã vào prompt.
Tính độ bất định
Minh họa thống kê hữu ích là “quy tắc ba”: khi không quan sát lỗi trong n phép thử độc lập đại diện, cận trên một phía 95% gần đúng của xác suất lỗi là 3/n. Với n=100, không lỗi vẫn tương thích tỷ lệ lỗi gần 3%; n=1.000 là khoảng 0,3%. Xấp xỉ không biến bộ fixture đối kháng thành mẫu production đại diện, cũng không bảo đảm an toàn.
Khi so hai model trên cùng case, giữ kết quả ghép cặp: cả hai đúng, chỉ A đúng, chỉ B đúng, cả hai sai. Dùng phương pháp khoảng tin cậy hoặc kiểm định ghép cặp phù hợp đã chọn trước. Lấy case bất đồng cho người phân xử. Không bỏ lợi thế ghép cặp bằng hai điểm trung bình được coi độc lập.
Chọn ngưỡng bằng bảng quyết định
| Ngưỡng giả định | Case được nhận | Nhận sai | Coverage | Lỗi trong case nhận |
|---|---|---|---|---|
| Thấp | 90/100 | 9 | 90% | 10% |
| Vừa | 70/100 | 2 | 70% | 2,86% |
| Cao | 40/100 | 0 | 40% | 0% quan sát; còn bất định |
Số liệu giả lập để minh họa trade-off. Nếu mục tiêu lỗi trên case nhận dưới 3%, ngưỡng vừa là ứng viên cần kiểm chứng thêm; ngưỡng cao mất nhiều coverage nhưng chưa có bảo đảm. Chọn bằng development data, rồi đánh giá chính sách cố định trên test độc lập. Xem cả case bị từ chối: liên tục hỏi lại yêu cầu tiếng Việt đã rõ là regression sản phẩm.
Tạo hồ sơ release dùng được
Hồ sơ gồm manifest case, hash nguồn và artifact, cấu hình, dự đoán thô, đầu ra grader, bất đồng đã phân xử và phân loại lỗi ngắn. Tách lỗi planner, query, retrieval, khẳng định thiếu căn cứ và UI. Việc này chỉ ra nên đổi model, lớp dữ liệu hay giao diện.
Bài tập cuối: đưa đồng nghiệp năm case lỗi và yêu cầu tái lập từ manifest. Nếu họ không xác định được model, prompt, snapshot đã dùng, evaluation chưa đủ để quyết định triển khai.
Xem cách tính khoảng tin cậy chính xác tại NIST exact binomial confidence limits.
Từ bài viết đến thử nghiệm chạy được
Benchmark và training là thử nghiệm trên dữ liệu giả lập do tác giả xây dựng, có các template tương quan. Không chứng minh tương đương model lớn hoặc chất lượng trên dữ liệu khách hàng. Model sinh plan được đo offline; demo công khai dùng baseline có kiểm soát. Benchmark: đã hoàn thành bốn candidate. LoRA: completed, 64/64 bước.
Lộ trình và kết quả thực nghiệm · Thử demo với dữ liệu giả lập · Tải code minh họa
Bài học từ triển khai này
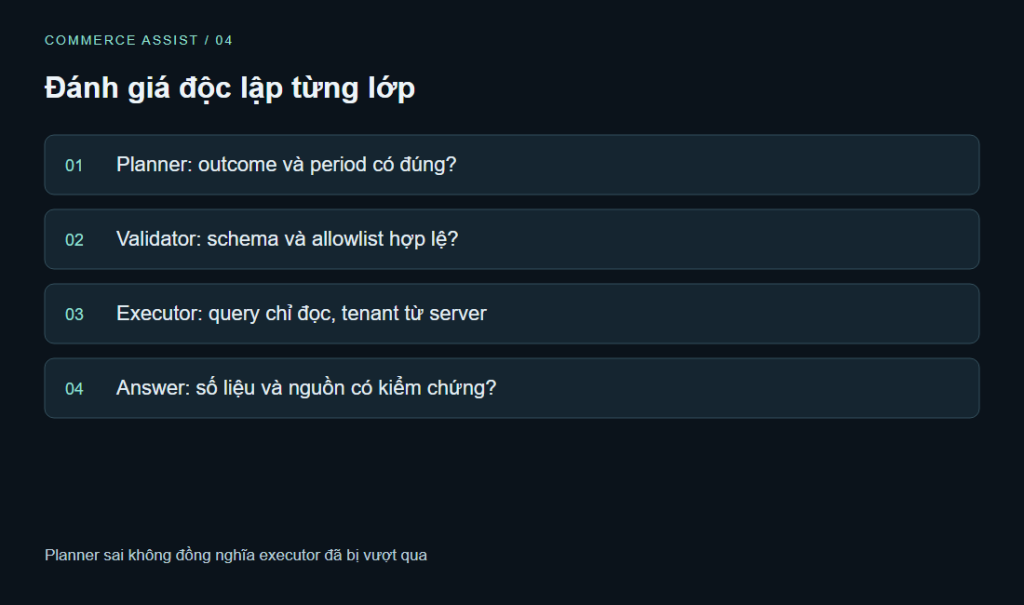
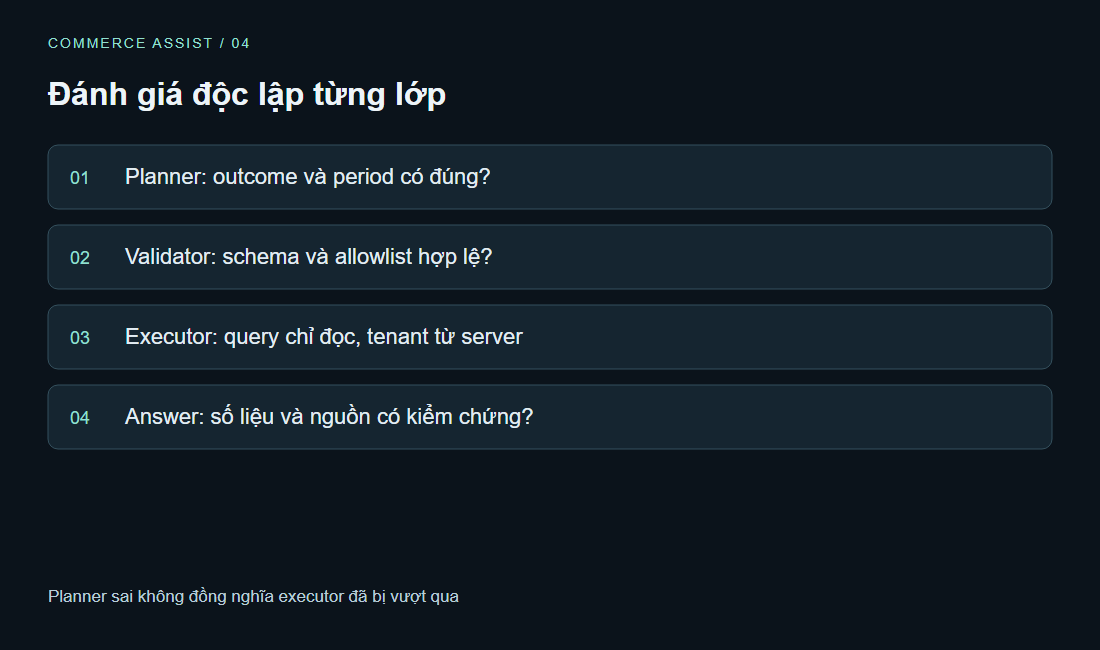
Đừng gộp đúng outcome, đúng plan và đúng số liệu. Hai plan sai ngày có thể cùng trả về không có dữ liệu. Vì vậy báo cáo lưu raw output và tách exact-plan correctness khỏi result correctness. Benchmark planner không đo được executor breach; kiểm tra tenant và query chỉ đọc nằm trong integration tests.
| Candidate | Đúng plan | Đúng kết quả / metric | Output không hợp lệ | p50 / ms | RSS / MiB |
|---|---|---|---|---|---|
| baseline | 120/120 | 60/60 | 0 | 0.043 | 25 |
| qwen25 | 8/120 | 7/60 | 37 | 12113.0 | 618 |
| qwen3 | 29/120 | 24/60 | 9 | 7200.4 | 920 |
| adapter | 80/120 | 50/60 | 2 | 7888.2 | 918 |
Challenge riêng: kỳ trước bằng 0
Hai ca EN/VI được báo cáo riêng, không cộng vào 120 ca chính. September so với June có previous total bằng 0; percent change phải là null. Trong cả hai ca EN/VI, cả ba model bỏ mất comparison_period dù câu hỏi yêu cầu so sánh. Arithmetic có bảo vệ vẫn không sửa được lỗi hiểu yêu cầu này.
| Candidate | Đúng plan / 2 |
|---|---|
| baseline | 2/2 |
| qwen25 | 0/2 |
| qwen3 | 0/2 |
| adapter | 0/2 |
Một plan hợp lệ nhưng sai
Qwen2.5 · test-002-en · Expected và actual trên cùng ca test:
{
  "expected": {
    "type": "metric_plan",
    "payload": {
      "metric": "net_revenue",
      "period": {
        "start": "2026-08-01",
        "end_exclusive": "2026-09-01"
      },
      "comparison_period": null,
      "group_by": null,
      "currency": "USD"
    }
  },
  "actual": {
    "type": "metric_plan",
    "payload": {
      "metric": "net_revenue",
      "period": {
        "start": "2026-08-01",
        "end_exclusive": "2026-09-30"
      },
      "comparison_period": null,
      "group_by": null,
      "currency": "USD"
    }
  }
}Bài viết liên quan
07 Oct 2026 · 5 phút đọc
agentic-ai
Agent Của OpenAI “Quậy” Wikipedia Suốt 5 Tháng — Và OpenAI Không Phải Người Phát Hiện Ra
Thông báo ngày 5/10 của Wikimedia hé lộ nhiều tháng traffic agent OpenAI trái phép trên hạ tầng của họ — điều tra do chính nạn nhân thực hiện, không phải nhà cung cấp.
Đọc tiếp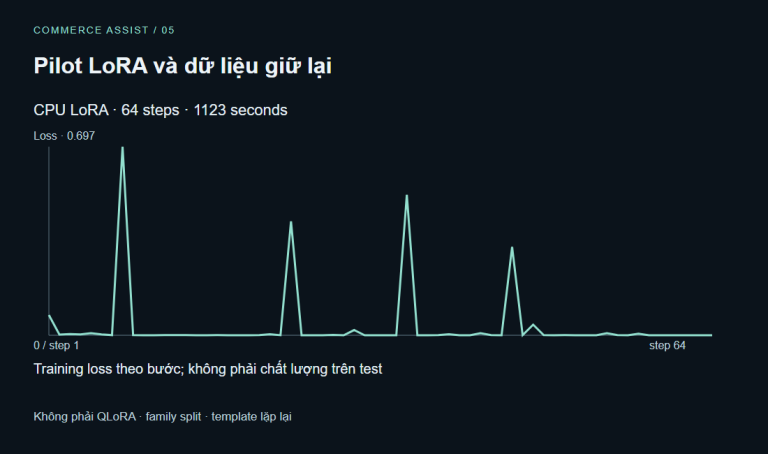
07 Oct 2026 · 11 phút đọc
agentic-ai
5. Train hành vi, retrieval kiến thức: thực hành LoRA
Chuẩn bị dữ liệu có giám sát, cấu hình thử nghiệm adapter và đánh giá giá trị vận hành của fine-tuning.
Đọc tiếp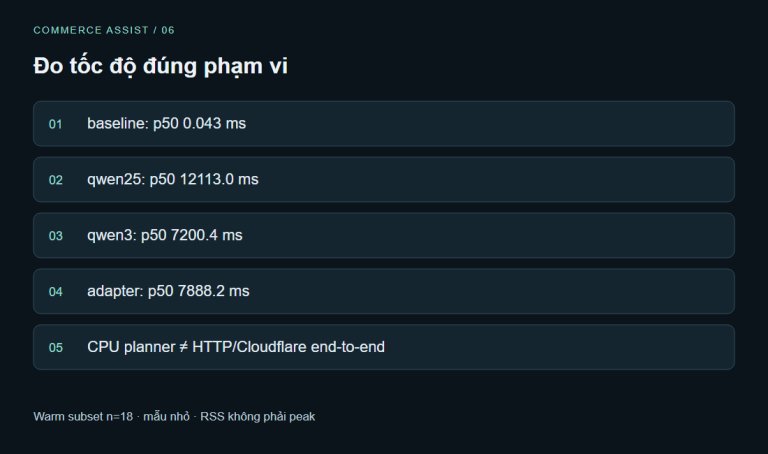
07 Oct 2026 · 9 phút đọc
agentic-ai
6. Tăng tốc chatbot và giữ chất lượng
Tối ưu context, output, caching, retrieval và inference theo ngân sách độ trễ, token từ đầu đến cuối.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.