
BÀI VIẾT
3. Chọn model chatbot có thể vận hành và train
So sánh model local, routing CPU và fine-tuning GPU theo chất lượng tác vụ, phần cứng và khả năng vận hành.
Trong bài viết
Kỹ thuật Chatbot · Bài 3 trong 9 bài · Nguồn được đối chiếu ngày 7 tháng 10 năm 2026. Thiết kế và giả định đề xuất được phân biệt với kết quả triển khai đã đo.
Model phù hợp nhất cho dự án là ứng viên nhỏ nhất được hỗ trợ và vượt qua ngưỡng chất lượng, độ trễ của dự án. Chưa thể kết luận có một model thắng mọi trường hợp nếu không benchmark EN/VI trên tác vụ mục tiêu. Dễ train, suy luận nhanh và chất lượng trả lời là những tiêu chí khác nhau.
Danh sách ứng viên thực tế để bắt đầu
| Ứng viên | Vai trò thử nghiệm | Điểm cần cân nhắc |
|---|---|---|
| Encoder đa ngôn ngữ giữ nguyên + classifier head | Routing ý định tại local | Phù hợp CPU; không sinh câu trả lời |
| Qwen3-4B | Baseline LoRA chỉ xử lý text | Tooling causal LM đã phổ biến; baseline cũ hơn |
| Qwen3.5-4B | Ứng viên model nhỏ mới hơn | Kiểm tra hỗ trợ kiến trúc hybrid, đa phương thức |
| Gemma 4 E4B IT | Ứng viên đối chiếu độc lập | Kiểm tra processor, adapter và runtime serving |
| Model hosted mạnh | Mốc chất lượng và escalation tùy chọn | Xử lý bên ngoài, chi phí biến đổi và khả dụng |
Đây là shortlist kỹ thuật, không phải bảng xếp hạng. Tôi sẽ bắt đầu thử nghiệm train text có thể tái lập bằng Qwen3-4B, rồi đối chiếu Qwen3.5-4B trước khi chốt hạ tầng production. Đề xuất này dựa vào sự đơn giản của toolchain, không khẳng định model cũ trả lời tốt hơn.
Model card hiện tại xác nhận điều gì?
Qwen3-4B cung cấp trọng số mở theo Apache 2.0, giao diện sinh text và tài liệu điều khiển thinking. Dùng đúng chat template của model và thử non-thinking cho tác vụ có cấu trúc ngắn. Tác vụ cần suy luận có thể cần ngân sách khác.
Qwen3.5-4B cũng dùng Apache 2.0 và có kiến trúc đa phương thức/hybrid mới hơn. Không sao chép recipe train causal LM sang kiến trúc khác một cách máy móc: kiểm tra loader, kernel attention, quantization được hỗ trợ và module gắn adapter.
Gemma 4 E4B IT là lựa chọn trọng số mở Apache 2.0 với tooling đa phương thức. Đây là ứng viên hiện tại đáng test; không được nhầm với giấy phép hay loader cũ của Gemma 3. Tuyên bố hỗ trợ nhiều ngôn ngữ trên model card chưa chứng minh chất lượng tiếng Việt cho dữ liệu kinh doanh của bạn.
Model nào dễ train nhất?
Với routing, encoder giữ nguyên kết hợp classifier head nhỏ là thử nghiệm dễ nhất trên phần cứng đã dùng ở đây. Nó cần ít compute hơn nhiều so với thích nghi backbone sinh nội dung và có không gian đầu ra hẹp, dễ kiểm tra. Demo hiện tại chứng minh cách này chạy được local, nhưng bộ đánh giá nhỏ chưa đủ cho production.
Với câu trả lời sinh nội dung, model instruction text nhỏ có stack Transformers/PEFT hỗ trợ là điểm khởi đầu đơn giản hơn. Train adapter thay vì toàn bộ backbone. Trước tiên xác nhận model gốc đã theo được schema và yêu cầu ngôn ngữ; fine-tuning khó cứu được một model vốn không phù hợp.
Chọn theo phần cứng thực tế
LXC demo có 4 GiB RAM và chạy inference bằng CPU. Nó phù hợp thử nghiệm routing hiện tại, chưa phù hợp làm dịch vụ sinh nội dung nhiều người dùng hay máy train QLoRA. Laptop và host Proxmox đã kiểm tra không có GPU NVIDIA. Điều này không nói lên cấu hình các host khác chưa kiểm tra trong cluster.
Bộ nhớ chỉ tính trọng số gần bằng số tham số nhân số byte mỗi tham số: bốn tỷ tham số ở bốn bit xấp xỉ hai gigabyte thập phân, chưa tính metadata quantization. Bộ nhớ runtime còn gồm KV cache, activation, framework và các sequence đồng thời. Training thêm gradient và trạng thái optimizer cho tham số được train. Dung lượng trọng số không phải cam kết VRAM.
Không áp dụng ví dụ bốn tỷ tham số cho mọi model có nhãn “4B”. Model card Gemma 4 E4B phân biệt khoảng 4,5 tỷ tham số hiệu dụng với tám tỷ nếu tính embedding. Tính bộ nhớ trọng số thường trú theo tensor thực sự được lưu và độ chính xác của chúng, không chỉ theo nhãn tham số hiệu dụng.
Test đúng context length, batch size và quantization trên phần cứng mục tiêu. Ghi peak memory và lỗi hết bộ nhớ. Thuê GPU tương thích trong thời gian ngắn để đo trước khi mua server riêng; “4B chạy vừa” chưa đồng nghĩa đã giải quyết số người dùng đồng thời.
Chọn bằng bảng điểm
So sánh schema hợp lệ, chỉ số chính xác, câu trả lời có căn cứ, chất lượng EN/VI, khả năng từ chối kết luận hoặc hỏi làm rõ khi phù hợp (abstention), p95 latency, chi phí mỗi tác vụ thành công và độ phức tạp vận hành. Loại ứng viên vi phạm yêu cầu quyền truy cập quan trọng dù điểm trung bình cao. Đánh giá bản quantized và không quantized riêng.
Đặt hành vi riêng của provider sau adapter nhưng giữ kiểm tra capability. Endpoint tương thích OpenAI chưa bảo đảm cùng cách ép structured output, tính token hay ngữ nghĩa tool. Pin revision model, tokenizer và runtime sau khi ứng viên vượt đánh giá.
Model hosted làm mốc đối chiếu
Dùng model hosted làm mốc chất lượng cho tác vụ đã chọn khi được phép xử lý dữ liệu test. Hướng dẫn chọn model của OpenAI đề cập đánh giá chất lượng, độ trễ và chi phí theo workload. Tài liệu pricing hiện tại cũng nêu nền tảng fine-tuning đang được thu hẹp và không mở cho người dùng mới. Đừng xây kế hoạch fine-tuning khách hàng mới dựa vào tutorial cũ mô tả dịch vụ luôn sẵn có.
Thực hành: bản ghi quyết định model cho Commerce Assist
Tách ba ngân sách: bộ nhớ inference, bộ nhớ training và công sức vận hành. Model dễ fine-tune vẫn có thể chậm ở concurrency yêu cầu. Model điểm benchmark công khai tốt có thể cần kernel server chưa hỗ trợ. Bản ghi quyết định phải nêu phần cứng được hỗ trợ, bộ tác vụ và người phụ trách nâng cấp.
| Bối cảnh | Thử nghiệm đầu | Lý do | Không được suy ra |
|---|---|---|---|
| LXC CPU 4 GiB hiện có | Encoder + classifier hiện tại | Đã minh họa trong phạm vi này | Host được chatbot sinh nội dung nhanh |
| Máy dev CPU nhiều RAM hơn | Generator nhỏ quantized được hỗ trợ | Đánh giá chức năng offline | Hiệu năng giữ nguyên khi nhiều người dùng |
| Một GPU tương thích | Baseline text 4B và một challenger | So sánh adapter, serving giới hạn | Chắc chắn vừa VRAM khi chưa đo |
| Client bắt buộc local | Model local + abstention rõ | Giữ ranh giới xử lý | Được escalation ra bên ngoài |
So sánh trong cùng điều kiện vận hành
Dùng cùng snapshot bằng chứng và danh mục tool có phiên bản. Mỗi model dùng chat template gốc đúng, nhưng cùng chỉ dẫn nghiệp vụ và hợp đồng đầu ra. Ghi thinking bật hay tắt, output cap và sampling. So sánh một model context 8.000 token với model 2.000 token là so sánh cả cấu hình, cần nêu rõ.
Chạy generator không router trước, rồi thêm routing như ablation riêng. Nếu không, khó biết model rẻ cải thiện hay router âm thầm chuyển câu khó. Báo cáo chất lượng nhánh local, nhánh escalation, tổng thể và tỷ lệ gọi bên ngoài. “Một model local” gây hiểu nhầm nếu một nửa công việc cần model hosted.
Dùng báo cáo không che được lỗi quan trọng
candidate,revision,quantization,template_version,thinking
task,language,test_count,correct_count,clarify_count,wrong_accept_count
schema_valid_count,forbidden_tool_attempts,unauthorized_results
context_tokens,output_tokens,p50_ms,p95_ms,peak_memory_mb
concurrency,external_escalation_count,cost_per_success_usd
Đây là cột báo cáo, chưa phải kết quả đã đo. Bắt đầu bằng hard gate về cô lập tenant và tool được phép. Sau đó so tác vụ thành công và abstention hữu ích, rồi mới tối ưu latency, chi phí. Điểm tổng có trọng số có thể dùng giữa ứng viên đủ điều kiện, nhưng không được bù lộ dữ liệu bằng tốc độ sinh nhanh.
Ví dụ giả định A hoàn thành 92/100 tác vụ, B đạt 91. Nếu thành công thêm của A là sửa format còn B tránh được câu trả lời lộ tenant của A, B có thể là ứng viên duy nhất đủ điều kiện. Một trăm câu tổng hợp vẫn ít bằng chứng cho chênh lệch nhỏ. Giữ từng lỗi riêng, không chỉ công bố tổng.
Ước lượng bộ nhớ theo kiến trúc
Với attention thông thường, KV cache phụ thuộc số layer, KV head, kích thước head, byte mỗi giá trị và token giữ lại; nhân hai cho key/value và nhân số sequence đồng thời. Grouped-query attention và kiến trúc hybrid thay đổi các thành phần. Quyết định mua phần cứng bằng allocation đo trong runtime triển khai; không áp công thức chung nguyên trạng cho Qwen3.5 hay mọi Gemma.
Context tăng nhỏ vẫn có thể giảm số session vừa bộ nhớ. Test ở 1, 2, 4, 8 request hoạt động nếu phù hợp lưu lượng mục tiêu. Hết bộ nhớ ở bốn request là phát hiện công suất, không chỉ lỗi chất lượng model. Ghi request bị từ chối và thời gian queue bên cạnh latency thành công.
Đưa quyết định có thể đảo ngược
Chọn một revision generator mặc định, một adapter nếu có giá trị và chính sách escalation rõ. Giữ giao diện gateway ổn định, kiểm tra capability khi startup. Lưu báo cáo ứng viên loại để lần nâng cấp sau nhắm đúng thiếu sót. Chạy lại workload khóa khi đổi quantization, tokenizer hay template.
Deliverable là bản ghi: “Chọn X cho tác vụ và phần cứng này vì vượt các ngưỡng ở mức tải này; còn các lỗi này; fallback theo chính sách này.” Trước khi có báo cáo, Qwen3-4B là baseline training đề xuất, Qwen3.5/Gemma là challenger, chưa phải model thắng đã xác nhận.
Từ bài viết đến thử nghiệm chạy được
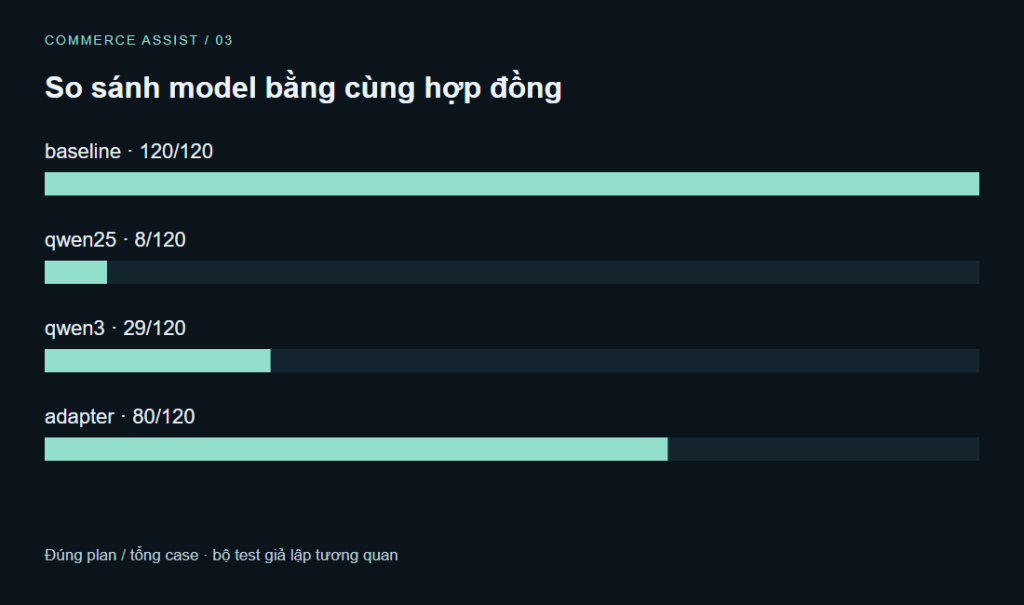
Benchmark và training là thử nghiệm trên dữ liệu giả lập do tác giả xây dựng, có các template tương quan. Không chứng minh tương đương model lớn hoặc chất lượng trên dữ liệu khách hàng. Model sinh plan được đo offline; demo công khai dùng baseline có kiểm soát. Benchmark: đã hoàn thành bốn candidate. LoRA: completed, 64/64 bước.
Lộ trình và kết quả thực nghiệm · Thử demo với dữ liệu giả lập · Tải code minh họa
Bài học từ triển khai này
Chọn model dựa trên exact plan trước khi xem tốc độ. Validation 20 ca chọn Qwen3 cho pilot; điểm test giữ lại được công bố riêng. Baseline có ưu thế trên phạm vi hẹp này vì quy tắc và fixture được thiết kế cùng hợp đồng, không chứng minh hiểu ngôn ngữ tổng quát.
| Candidate | Đúng plan | Đúng kết quả / metric | Output không hợp lệ | p50 / ms | RSS / MiB |
|---|---|---|---|---|---|
| baseline | 120/120 | 60/60 | 0 | 0.043 | 25 |
| qwen25 | 8/120 | 7/60 | 37 | 12113.0 | 618 |
| qwen3 | 29/120 | 24/60 | 9 | 7200.4 | 920 |
| adapter | 80/120 | 50/60 | 2 | 7888.2 | 918 |
Bài viết liên quan
07 Oct 2026 · 5 phút đọc
agentic-ai
Agent Của OpenAI “Quậy” Wikipedia Suốt 5 Tháng — Và OpenAI Không Phải Người Phát Hiện Ra
Thông báo ngày 5/10 của Wikimedia hé lộ nhiều tháng traffic agent OpenAI trái phép trên hạ tầng của họ — điều tra do chính nạn nhân thực hiện, không phải nhà cung cấp.
Đọc tiếp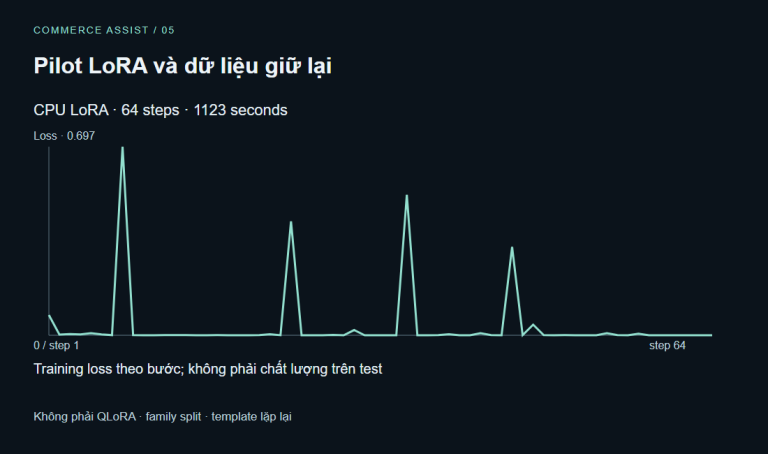
07 Oct 2026 · 11 phút đọc
agentic-ai
5. Train hành vi, retrieval kiến thức: thực hành LoRA
Chuẩn bị dữ liệu có giám sát, cấu hình thử nghiệm adapter và đánh giá giá trị vận hành của fine-tuning.
Đọc tiếp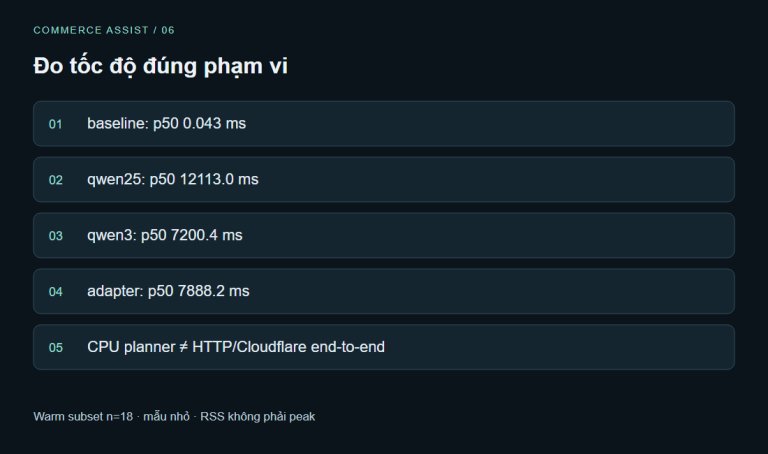
07 Oct 2026 · 9 phút đọc
agentic-ai
6. Tăng tốc chatbot và giữ chất lượng
Tối ưu context, output, caching, retrieval và inference theo ngân sách độ trễ, token từ đầu đến cuối.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.