
BÀI VIẾT
SIFT: Chi Phí Thật Để Một Coding Agent Tự Cải Thiện Bản Thân
Framework SIFT của MIT và Sakana AI vượt qua SOTA cũ của agent tự cải thiện bằng cách dùng một judge Bradley-Terry thay vì sinh thêm patch. Mình tính luôn chi phí thật — khoảng $150 và chưa tới 5 giờ wall-clock cho một bước nhảy 4.4 điểm trên Polyglot.

Trong bài viết
Darwin Gödel Machine là kết quả nổi nhất về coding agent tự cải thiện suốt gần cả năm nay — một agent tự viết lại code của chính nó, benchmark bản viết lại, và giữ version nào điểm cao hơn. Phản xạ tự nhiên của bất kỳ ai copy ý tưởng này là: sinh nhiều candidate rewrite hơn, benchmark nhiều hơn, để cái tốt nhất thắng bằng brute force. Paper SIFT của MIT và Sakana AI làm ngược lại hoàn toàn. Nó gần như không tốn thêm compute để sinh patch, mà đổ ngân sách vào việc chọn patch nào thực sự tốt hơn — và nó vượt điểm của DGM theo cách đó.
Đây là phần đáng ngẫm trước khi nhìn vào số benchmark. Cái lever thực sự kéo điểm lên không phải “thử nhiều hơn”, mà là “có một judge tốt hơn”.
Mảnh ghép DGM còn thiếu
Loop của DGM là: mutate code của chính agent, chạy nó qua một tập con benchmark, giữ lại bản mutate nếu điểm tăng. Bước tính điểm là một lượt chạy benchmark đầy đủ — đắt, chậm, và chỉ cho bạn biết con số tổng, không cho biết thay đổi cụ thể nào thực sự giúp.
SIFT thêm một tín hiệu thứ hai, rẻ hơn nhiều: một LLM judge so sánh theo cặp (pairwise). Thay vì hỏi “patch này điểm benchmark cao hơn không”, SIFT hỏi một model judge “giữa patch này và patch kia, cái nào thực sự tốt hơn”, lặp lại nhiều lần, qua nhiều cặp. Các so sánh cặp đó được đưa vào một mô hình Bradley-Terry — cùng loại toán đứng sau Elo trong cờ vua và phần lớn reward model trong RLHF — biến một đống vote cặp-cặp có nhiễu thành một điểm xếp hạng duy nhất cho mỗi candidate. Sau đó SIFT giữ một archive gồm tối đa 10 candidate đứng đầu theo ranking đó, không chỉ giữ một cái “tốt nhất tính đến hiện tại” — để một patch mạnh nhưng chưa phải số 1 không bị vứt bỏ oan.
Ba phần chạy bất đồng bộ với nhau: sinh patch, judge, và benchmark không chờ nhau theo kiểu lockstep. Trong khi một patch đang được benchmark, judge đã đang xếp hạng batch trước, và việc sinh patch đã đang tạo ra cái tiếp theo.
Những con số biện minh cho thiết kế này
Trên Polyglot (eval khó hơn trong hai eval SIFT công bố), dùng o3-mini làm agent nền:
DGM (SOTA cũ):              30.7%
SIFT, không có judge:       29.8%
SIFT, full pipeline:        35.1%
Đọc kỹ dòng ablation — đó là toàn bộ luận điểm của bài. Bỏ judge ra, SIFT còn tệ hơn DGM một chút, không hơn. Toàn bộ mức tăng 4.4 điểm so với DGM đến từ judge, không phải từ sinh nhiều patch hơn hay search thông minh hơn. Nếu bạn chỉ nhớ một số từ paper này, hãy nhớ: judge chiếm 100% mức cải thiện, và compute thêm cho việc sinh patch gần như miễn phí.
Trên TerminalBench, lựa chọn top của judge đạt 36.7% so với 28.1% cho agent chạy tốt nhất khi không dùng ranking của judge để chọn — cùng câu chuyện, benchmark khác.
Và phần mình thực sự muốn biết trước khi viết bài này: một lượt chạy đầy đủ tốn bao nhiêu. Với eval Polyglot 50 task, SIFT báo cáo tổng chi phí khoảng $150, khoảng 42 CPU-giờ, và wall-clock dưới 5 giờ. Chia nhỏ hơn: mỗi lượt sinh patch tốn khoảng 12 cent, mỗi lượt judge so sánh tốn khoảng 4.4 cent. Phần judge rẻ tính theo từng lượt gọi — chi phí cộng dồn lên vì bạn chạy rất nhiều lượt so sánh cặp, không phải vì một lượt so sánh riêng lẻ đắt.
Vì sao điều này quan trọng hơn con số leaderboard
Nếu bạn đang xây bất kỳ loại agent tự cải thiện hay tự đánh giá nào — không nhất thiết là coding agent, pattern này áp dụng cho bất kỳ setup nào mà agent sinh nhiều candidate output và bạn cần chọn một — phản xạ hầu như luôn là đổ thêm compute vào bước sinh. Thử nhiều hơn, sample nhiều hơn, search rộng hơn. Ablation của SIFT là một ví dụ ngược chiều rất rõ: nghẽn cổ chai không nằm ở độ đa dạng của candidate, mà nằm ở việc so sánh candidate. Một điểm benchmark cứng cho mỗi candidate vứt bỏ gần hết tín hiệu về vì sao candidate này thắng candidate kia, còn so sánh theo cặp phục hồi lại một phần tín hiệu đó với giá rẻ.
Lựa chọn Bradley-Terry quan trọng cụ thể vì nó chịu được một judge có nhiễu trên từng lượt so sánh riêng lẻ. Bạn không cần LLM judge đúng mọi lần — bạn chỉ cần nó đúng nhiều hơn sai qua rất nhiều cặp, và phần toán ranking sẽ trung bình hoá nhiễu đó ra. Đây cũng là lý do Elo hoạt động được cho rating cờ vua xây từ từng trận đấu riêng lẻ có nhiễu.
Nếu mình replicate cái này cho một eval loop nội bộ, phần mình xây đầu tiên không phải bước mutation/sinh patch — đa số team đã có sẵn một phiên bản nào đó của việc này. Đó là lớp judge-cộng-ranking-Bradley-Terry, vì dữ liệu ablation nói rõ 100% mức tăng đo được nằm ở đó, và nó tái sử dụng được across các chiến lược sinh hoàn toàn khác nhau.
Mình sẽ dùng cái này ở đâu
Không phải team nào cũng cần một agent tự viết lại chính nó — đó là use case hẹp, mang màu research. Nhưng pattern bên dưới nó không hẹp chút nào: bất cứ khi nào bạn có một agent sinh ra N candidate solution (mô tả PR, query plan SQL, config diff, test suite) và hiện tại bạn chọn người thắng bằng một điểm số tự động duy nhất, một judge so sánh cặp rẻ kết hợp Bradley-Terry nhiều khả năng là lever lớn hơn việc sinh thêm candidate. Chính ablation của SIFT là bằng chứng — trước khi đổ thêm compute để tạo ra nhiều thứ hơn, hãy đổ một ít compute để giỏi hơn trong việc phân biệt chúng với nhau.
Bài viết liên quan
06 Oct 2026 · 6 phút đọc
agentic coding
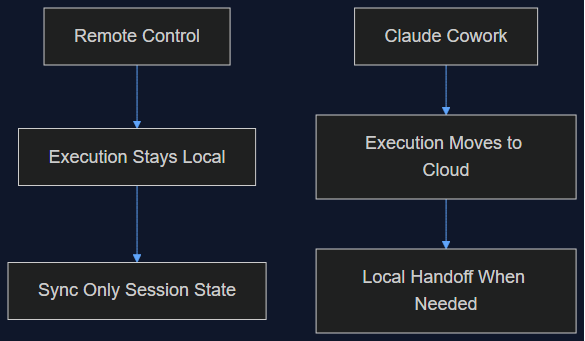
Claude Cowork vừa làm đúng cái mình từng nói Remote Control không làm
Tháng 8 mình viết rằng Remote Control của Claude Code chỉ là một lớp đồng bộ, không phải di chuyển lên cloud, và việc giữ execution ở local chính là điểm cốt lõi. Tuần này Anthropic chuyển hẳn execution của Cowork lên cloud làm mặc định. Đây là lý do cả hai quyết định đều đúng — cho hai sản phẩm khác nhau.
Đọc tiếp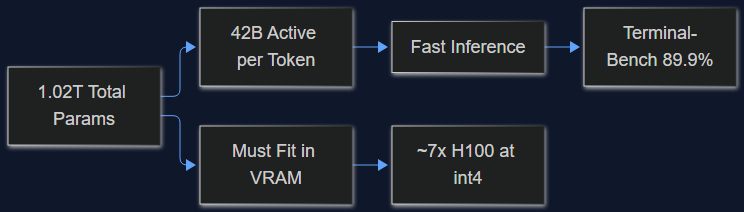
03 Oct 2026 · 5 phút đọc
ai
MiMo-V2.6-Pro License MIT, 1.02 Nghìn Tỷ Params — Mình Tính Thử Chi Phí Self-Host
Model open-weight mới của Xiaomi đứng đầu Terminal-Bench 2.1 với 89.9%, DeepSWE nhảy từ 19.0 lên 71.9. Trước khi mừng vì license MIT, đọc thử phần này — 1.02T tổng params khác 42B active params ở điểm nào, và nó làm bill GPU của bạn khác nhau cỡ nào.
Đọc tiếp
03 Oct 2026 · 5 phút đọc
agents
950 Agent, 21 Giờ, 210 Triệu Token: Cuộc Tìm CRISPR Của Anthropic Thực Sự Chứng Minh Điều Gì Về Fan-Out
Lab khoa học sự sống của Anthropic chạy 950 agent song song để tìm ra một hệ enzyme giống CRISPR có thể là mới. Toán học của cái funnel là một pattern fan-out thật sự hữu ích — nhưng phần phản ứng của giới khoa học mới là đoạn đáng đọc kỹ.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.