19 Aug 2026 · 7 phút đọc
agentic coding
750 Token/Giây: Wafer-Scale Inference Của Cerebras Thực Sự Thay Đổi Gì Cho UX Của Agent
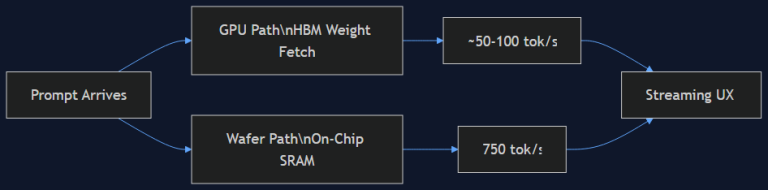
GPT-5.6 Sol Ultrafast của OpenAI, chạy trên Wafer-Scale Engine của Cerebras, đạt 750 token đầu ra/giây — nhanh gấp 14 lần inference tiêu chuẩn. Tôi tìm hiểu vì sao SRAM on-chip thắng HBM trong bài toán này, và nó thay đổi gì trong cách thiết kế sản phẩm agent nhạy cảm với độ trễ.
Đọc tiếp