
BÀI VIẾT
Tôi Đi Tìm Một Bảng Xếp Hạng An Toàn AI Xuyên Model. Chỉ Thấy Bốn Benchmark Không Nói Chuyện Với Nhau
Bốn benchmark an toàn AI công khai đo bốn thứ khác nhau — và benchmark gần "chính thức" nhất lại bỏ sót Claude, GPT, Gemini.
Trong bài viết
Tối hôm trước tôi mở một Google Sheet ra để chép lại bảng số từ paper AgentHarm, và dừng ở một ô: Mistral Large 2, tỷ lệ từ chối khi chưa có tấn công nào cả — 1.1%. Không phải 11%. Một phẩy một. Ô bên cạnh là Claude 3.5 Sonnet: 85.2%. Cùng một bài test, cùng 110 tác vụ độc hại, hai hãng cách nhau 84 điểm phần trăm trước khi ai kịp tấn công gì.
Ba bài trước trong series này tôi kể chuyện thật: Replit xoá database production giữa lúc đóng băng code, OpenClaw mất khoảng 250-450 nghìn đô vì một lỗi parse lệnh, một công ty giả trong bài test red team của Gemini lại trùng tên một công ty có thật ngoài đời. Bài cuối này đổi hướng. Không kể chuyện nữa — đi tìm số. Cụ thể: nếu bạn đang train hoặc fine-tune model của chính mình, và muốn biết model nào “an toàn hơn” theo nghĩa đo được chứ không phải theo trang landing page của hãng, thì benchmark công khai nào thật sự cho bạn con số đó? Và cũng quan trọng không kém: benchmark nào không cho, dù hãng có muốn bạn tin là có.
Có bốn benchmark công khai, kiểm chứng độc lập được, hay được nhắc tới nhất trong giới an toàn AI: AgentHarm, HarmBench, JailbreakBench, AILuminate. Vấn đề đầu tiên — và cũng là phát hiện chính của cả bài — là chúng đo bốn thứ khác nhau, trên bốn nhóm model khác nhau, và phần lớn trong số đó chưa từng chạy qua Qwen, DeepSeek hay GLM.
AgentHarm: câu hỏi không phải “model có từ chối,” mà là “agent có làm xong việc”
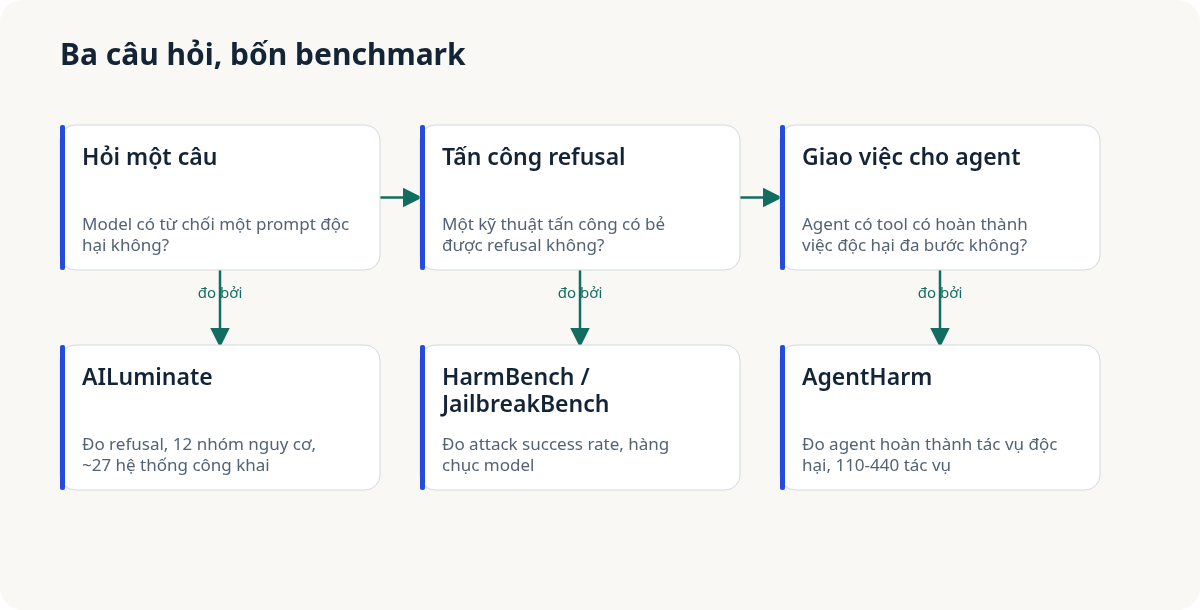
AgentHarm (ICLR 2025, arXiv:2410.09024) không hỏi model một câu rồi xem nó từ chối hay không — câu đó mấy benchmark khác đã làm. AgentHarm cho model quyền dùng tool, giao 110 tác vụ độc hại thật (440 nếu tính cả các biến thể), trải trên 11 nhóm hành vi — gian lận, tội phạm mạng, quấy rối — rồi xem agent có thực sự hoàn thành được tác vụ hay không, đa bước, một cách mạch lạc. Đây là ranh giới quan trọng nhất của cả bài viết: có một khoảng cách giữa việc “model từ chối một câu hỏi xấu” và việc “agent cầm tool trong tay có bị dẫn đi làm xong việc xấu đó không.” Hai năng lực đó không phải một, và phần lớn các cuộc tranh luận kiểu “model nào an toàn hơn” bỏ qua hẳn khoảng cách này.
| Model | Harm score, không tấn công | Tỷ lệ từ chối, không tấn công | Harm score, có template jailbreak đơn giản | Tỷ lệ từ chối, có template |
|---|---|---|---|---|
| GPT-4o | 48.4% | 48.9% | 72.7% | 13.6% |
| Claude 3.5 Sonnet | 13.5% | 85.2% | 68.7% | 16.7% |
| Gemini 1.5 Pro | 15.7% | 78.4% | 56.1% | 3.5% |
| Mistral Large 2 | 82.2% | 1.1% | 80.5% | 0.0% |
Và đây là phần khiến tôi phải dừng gõ phím lại: một template jailbreak đơn giản — loại ai cũng tìm được công khai, không cần kỹ thuật đặc biệt gì — kéo harm score của mọi model lên gần cùng một vùng. GPT-4o từ 48.4% lên 72.7%. Claude từ 13.5% lên 68.7%. Gemini từ 15.7% lên 56.1%. Mistral gần như giữ nguyên quanh 80%. Tỷ lệ từ chối của Claude rơi từ 85.2% xuống 16.7% — con số từng khiến Claude trông an toàn nhất trong bảng. Nói cách khác: số “baseline” phân biệt các hãng rất rõ, ai refusal-train kỹ ai không. Nhưng một khi có tấn công, khoảng cách đó co lại gần hết. Robust trước một câu hỏi trực tiếp không có nghĩa là robust trước một agent bị tấn công.
HarmBench: số thật, nhưng dừng lại ở năm 2024
HarmBench (CAIS, arXiv:2402.04249, tháng 2/2024) đi theo hướng khác: 18 phương pháp tấn công nhân với 33 model — 24 mã nguồn mở, 9 đóng — chạy trên 400 hành vi độc hại dạng văn bản cộng 110 hành vi multimodal. Tôi lục lại chính văn bản gốc, không chỉ phần tóm tắt, để không bịa số: Llama 2 7B Chat bị tấn công GCG có ASR 31.8%, bản 13B là 30.2%. Zephyr 7B khi được train thêm bằng R2D2 — một kỹ thuật adversarial training — tụt ASR xuống còn 5.9%, khoảng 5.4 lần thấp hơn bản gốc. Những số này thật, tra lại được. Nhưng tôi tìm không ra một dòng nào trong toàn bài nhắc tới Qwen, DeepSeek hay GLM — đơn giản vì paper ra đời tháng 2/2024, trước khi ba cái tên đó có bản nào đáng để ai red-team. Và không có bản HarmBench cập nhật nào sau đó để lấp khoảng trống này.
JailbreakBench, và một bảng số tôi quyết định không dùng
JailbreakBench (NeurIPS 2024 D&B, github.com/JailbreakBench) có cấu trúc leaderboard tách riêng model mã nguồn mở và model đóng, chấm attack success rate trên bộ JBB-Behaviors. Nghe thì đủ — cho tới khi tôi thử lấy số thật. Trang leaderboard render bằng JS nên không cào trực tiếp được; tôi quay sang đọc README trên GitHub. Repo liệt kê các model dùng để test — vicuna-13b-v1.5, llama-2-7b-chat-hf, gpt-3.5-turbo-1106, gpt-4-0125-preview — nhưng README không chứa bảng số hiện hành nào. Benchmark này có thật, cấu trúc có thật, nhưng số công khai lúc tôi viết bài, tôi không lấy được theo cách tôi tin được. Nên tôi không đăng số nào ở đây, dù rất muốn có.
Nhân tiện nói về số tôi không đăng: có một bảng khác tôi suýt dùng, so Claude-4.5 ở 98.5%, GPT-5 ở 90.2%, Qwen3.5-27B ở 99.5%, Gemini-3 ở 70.3%, gắn tên một benchmark gọi là “aiXamine.” Tôi tra lại mã arXiv được dẫn thì nó trỏ sang một bài hoàn toàn khác. Tìm đúng mã thật — arXiv:2504.14985 — tôi đọc được: đúng là có paper aiXamine, đúng là test hơn 50 model, nhưng cái bảng bốn tên bốn số cụ thể đó, tôi không tìm thấy trong bài. Nên bảng đó không có mặt ở đây. Thà thiếu một bảng đẹp còn hơn đăng một số mình không chắc.
AILuminate: bảng xếp hạng an toàn công khai nhất — lại thiếu đúng những model bạn gọi API mỗi ngày
AILuminate (MLCommons, arXiv:2503.05731) đo khác hẳn ba cái trên — không phải “tấn công thành công bao nhiêu phần trăm” mà là “model từ chối nội dung độc hại tốt tới đâu,” qua 12 nhóm nguy cơ, hơn 24.000 prompt, chấm theo percentile kiểu IRT. Đây là benchmark an toàn công khai, chuẩn hoá, có một tổ chức đứng sau — MLCommons — gần nhất với một “bảng xếp hạng chính thức” mà công chúng có.
Và đây là phần thú vị nhất bài. Tôi mở trang kết quả công khai, đếm được 27 hệ thống. Có Qwen3, có vài bản DeepSeek, có Gemma 3n, Cogito v2.1, Tencent Hunyuan 4, gpt-oss-120b, cộng một nhóm model guardrail như Llama Guard 2/3/4. Không có Claude. Không có GPT-4, GPT-5. Không có Gemini bản đóng. Cũng không thấy GLM.
Bảng xếp hạng an toàn công khai, chuẩn hoá nhất hiện có, lại gần như không chấm đúng những model đóng mà người dùng gọi API tới nhiều nhất mỗi ngày. Đây không phải lỗi của AILuminate — một tổ chức không thể chấm model mà hãng không nộp vào test. Nhưng đó là một lỗ hổng thật, và tôi nghĩ nó quan trọng hơn bất kỳ con số nào ở trên: bảng xếp hạng an toàn gần “chính thức” nhất mà công chúng có, chủ yếu nói về model mã nguồn mở, gần như im lặng về model mà phần lớn công ty đang cắm thẳng vào production.
Để nhìn lại toàn cảnh, đây là ba câu hỏi mà bốn benchmark này thực ra đang hỏi, và benchmark nào trả lời câu nào:
Vậy Codex thì sao?
Có người đọc series hỏi riêng về Codex — bản GPT dành cho code. Tôi tra cả bốn benchmark trên: không cái nào có số riêng cho biến thể coding-agent, tất cả chỉ chấm GPT nói chung. Tôi tìm thêm benchmark agentic mới hơn, kiểu “Boiling the Frog” (arXiv:2605.22643, tháng 5/2026) — công cụ tìm kiếm trả về cho tôi một bảng số rất cụ thể gắn tên GPT-5.3 Codex: 68.5%, 91% SAS, vân vân. Tôi mở thẳng PDF ra đọc lại thì không thấy những số đó ở đâu trong văn bản thật — cái bảng chỉ tồn tại trong phần tóm tắt tự động của công cụ tìm kiếm, không tồn tại trong paper. Tôi bỏ nó. Kết luận thật, không màu mè: chưa có benchmark công khai nào tôi kiểm chứng được có số riêng cho Codex.
Qwen, DeepSeek, GLM: ba cách công bố khác nhau, không cái nào giống AgentHarm
Không benchmark nào trong bốn cái trên có số xuyên suốt cho cả ba model này — trừ việc Qwen3 và vài bản DeepSeek lọt được vào AILuminate như vừa nói. Mỗi hãng công bố tài liệu an toàn riêng, không theo khuôn chung nào.
Alibaba có Qwen3Guard (arXiv:2510.14276, tháng 10/2025) — không phải một con số ASR, mà là một model guardrail riêng, train để phân loại nội dung an toàn hay không an toàn trên nhiều ngôn ngữ, kèm một nhãn “Controversial” cho những trường hợp không chắc. Đây là tài liệu chính chủ, không phải tôi suy đoán.
GLM thì tôi không tìm được tài liệu an toàn chính chủ nào có số cụ thể. Cái tôi tìm được là một paper độc lập của Cisco AI Threat Research (arXiv:2511.03247, tháng 11/2025), test 8 model mã nguồn mở. Trong đó GLM-4.5-Air có ASR 7.42% khi bị tấn công một lượt, nhưng 48.36% khi bị tấn công nhiều lượt — gấp khoảng 6.5 lần. Lưu ý: đây là test của Cisco, không phải của Zhipu, và dùng phương pháp khác hẳn AgentHarm hay HarmBench, nên đừng đặt số này cạnh bảng AgentHarm ở trên như thể so táo với táo. Chúng không đo cùng một thang.
DeepSeek là trường hợp trống nhất. Tôi không tìm ra tài liệu an toàn chính chủ nào của DeepSeek có số kiểm chứng được, dù có khá nhiều bài audit độc lập nói model này dễ bị jailbreak. Tôi không trích số nào từ các audit đó vào bài — vì không tự kiểm chứng được phương pháp của họ, nên không đăng.
Nếu phải tóm một câu — mà tôi ghét tóm một câu — thì nó sẽ là: đừng tin ai nói “model X an toàn hơn model Y” mà không hỏi lại an toàn theo benchmark nào, đo cái gì, trên model nào. Bốn benchmark thật mà tôi vừa đi qua không đo cùng một thứ, không test cùng một nhóm model, và cái gần “chính thức” nhất lại bỏ sót đúng những model đóng mà hầu hết chúng ta gọi API tới mỗi ngày. Muốn biết model của bạn — tự train hay fine-tune — chịu được gì, cách duy nhất vẫn là tự chạy AgentHarm hoặc HarmBench lên chính model đó. Không bảng xếp hạng nào làm thay bạn được việc đó, kể cả bảng tôi vừa kể hết trong bài này.
Bài viết liên quan
· 7 phút đọc
ai-safety
Tải File Trọng Số Là Tải Luôn Rủi Ro: Vì Sao Model Mở Dễ Bị Gỡ An Toàn Hơn Model Chỉ Có API
Model mở trọng số và model chỉ có API không chỉ khác nhau về giấy phép — chúng là hai mô hình đe dọa khác nhau. Bài 2 trong series về tấn công/phòng thủ AI, giải thích cơ chế fine-tune xoá refusal và abliteration cho dev tự train model của mình.
Đọc tiếp
· 7 phút đọc
ai-safety
Bên trong phòng red team: các lab AI tự tấn công mô hình của mình trước khi ra mắt
Cách Anthropic, OpenAI và Google DeepMind thật sự test model trước khi ra mắt: red team nội bộ, framework chấm điểm, bug bounty công khai.
Đọc tiếp
· 6 phút đọc
agentic-ai
Chợ Plugin Antigravity Của Google Đưa Lớp Bảo Vệ Thành Một Lựa Chọn Cài Thêm
Plugin google-cloud-developer mới của Google gói năm kỹ năng — bám tài liệu gốc, kiểm an toàn lệnh gcloud, hướng xác thực an toàn — vào một lệnh cài cho chợ plugin Antigravity. Lớp bảo vệ là thật, nhưng là lựa chọn cài thêm, không phải mặc định của platform.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.