
BÀI VIẾT
Tải File Trọng Số Là Tải Luôn Rủi Ro: Vì Sao Model Mở Dễ Bị Gỡ An Toàn Hơn Model Chỉ Có API
Model mở trọng số và model chỉ có API không chỉ khác nhau về giấy phép — chúng là hai mô hình đe dọa khác nhau. Bài 2 trong series về tấn công/phòng thủ AI, giải thích cơ chế fine-tune xoá refusal và abliteration cho dev tự train model của mình.
Trong bài viết
Mistral Large 2 không cần ai tấn công gì cả. Hỏi thẳng một yêu cầu có hại, không jailbreak prompt, không prompt injection, không kỹ thuật gì — model vẫn làm theo 82.2% số lần. Claude 3.5 Sonnet, cùng kiểu câu hỏi, chỉ 13.5%. GPT-4o 48.4%. Gemini 1.5 Pro 15.7%. Bốn con số này lấy từ AgentHarm (arXiv:2410.09024, bảng 9, điều kiện “None” — không áp dụng attack nào), đo baseline refusal của từng hãng trước khi ai đụng tới bất kỳ kỹ thuật tấn công nào.
Đây là bài 2 trong series về tấn công và phòng thủ AI mình đang viết cho dev tự train hoặc fine-tune model của chính mình. Bài này không xếp hạng ai bypass dễ nhất — không có bảng đó, và nếu ai đưa cho bạn một bảng kiểu vậy thì nên hỏi lại nguồn trước khi tin. Câu hỏi bài này trả lời hẹp hơn nhưng quan trọng hơn với ai release model mở: vì sao có file trọng số trong tay lại là một mô hình đe dọa khác hẳn so với chỉ gọi qua API, bất kể model ban đầu được safety-tuned kỹ đến đâu.
Hai mô hình đe dọa, không phải một
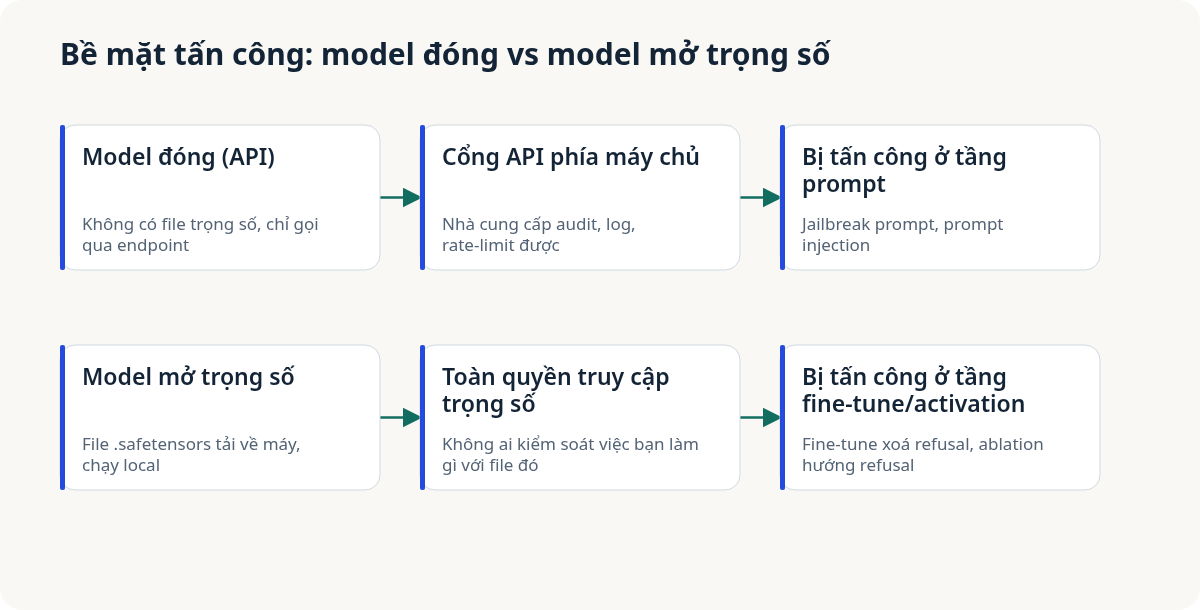
Model đóng — GPT, Codex, Claude, Gemini — bạn không bao giờ chạm vào file trọng số. Mọi request đi qua một cổng API phía máy chủ. Nhà cung cấp kiểm soát input/output, log được, rate-limit được, update refusal behavior bất cứ lúc nào họ muốn mà bạn không hề biết. Bề mặt còn lại cho kẻ tấn công là tầng prompt: jailbreak prompt, prompt injection qua nội dung bên thứ ba mà agent đọc vào lúc làm việc. Đó là chủ đề bài 3 của series, không phải bài này.
Model mở trọng số — Llama, Qwen, Mistral, DeepSeek, GLM — khác hẳn. Bạn tải file .safetensors về máy, chạy local hoặc trên server của chính bạn. Từ giây phút đó, refusal behavior của model không còn nằm trong tay nhà cung cấp nữa. Nó nằm trong tay bạn, và trong tay bất kỳ ai khác có file đó — kể cả người bạn không muốn có nó.
Fine-tune xoá refusal — cách thô nhưng hiệu quả
Cách đơn giản nhất: fine-tune trực tiếp lên trọng số đã tải về. Chuẩn bị một tập nhỏ các cặp (câu hỏi có hại, câu trả lời tuân theo), chạy LoRA fine-tune vài giờ trên một GPU, và refusal behavior học được trong giai đoạn RLHF/safety-tuning bị ghi đè. Không cần truy cập hạ tầng của nhà cung cấp. Không cần họ biết gì cả. Đây cũng là lý do fine-tuning API của các hãng đóng (OpenAI, Anthropic, Google) luôn có lớp kiểm duyệt riêng trên chính dữ liệu fine-tune bạn gửi lên — còn fine-tune trên trọng số đã nằm sẵn trên máy bạn thì không ai kiểm duyệt gì, vì không ai nhìn thấy.
Abliteration: không cần fine-tune, chỉ cần một hướng vector
Có một kỹ thuật còn rẻ hơn fine-tune, và nó dựa trên một phát hiện nghiên cứu thật, công bố công khai và được lặp lại nhiều lần bởi nhiều nhóm khác nhau: nghiên cứu của Arditi và cộng sự cho thấy refusal behavior ở nhiều LLM mở không nằm rải rác khắp mạng, mà tập trung chủ yếu vào một hướng tuyến tính duy nhất trong residual stream activations. Xác định hướng đó — thường chỉ cần vài chục prompt có hại và vài chục prompt vô hại để so sánh activation — rồi triệt tiêu (“ablate”) nó khỏi forward pass, phần lớn refusal biến mất. Không cần dữ liệu huấn luyện. Không cần backprop. Không cần GPU cluster.
Mình nói phần này ở mức cơ chế, không phải hướng dẫn từng bước — đó không phải mục đích bài viết. Nhưng điều đáng nói với dev tự fine-tune model mở là ý nghĩa của phát hiện này: refusal không được học như một năng lực sâu, đan cài phức tạp vào toàn bộ model. Nó là một lớp khá mỏng nằm gần bề mặt. Nếu bạn release weights ra ngoài, lớp mỏng đó đi theo file, và ai đủ kiên nhẫn tính một hướng vector có thể gỡ phần lớn nó mà không cần retrain gì cả.
HarmBench: train kiểu adversarial giúp thật, nhưng không đóng được lỗ hổng cấu trúc
Tin không hoàn toàn xấu. HarmBench (CAIS, arXiv:2402.04249) test độ bền của nhiều model trước nhiều kiểu tấn công, bao gồm so sánh model được train thêm bằng kỹ thuật adversarial (R2D2) với model stock. Theo Figure 7 của paper: Llama-2-13B-chat bản stock — lúc đó là model “robust” nhất trong nhóm baseline, theo chính cách paper gọi — có ASR (attack success rate) 30.2% trước tấn công GCG. Zephyr-7B được train thêm bằng R2D2 kéo ASR xuống còn 5.9%, thấp hơn khoảng 4-5 lần. Paper viết thẳng: “robustness is independent of model size” — độ bền không phụ thuộc kích thước model, mà phụ thuộc dữ liệu và thuật toán train.
Đây là tin tốt cho ai tự fine-tune model mở: train an toàn đúng cách thật sự tạo khác biệt đo được. Nhưng R2D2 đo ASR trước tấn công dạng tối ưu chuỗi prompt (GCG) — vẫn ở tầng “gọi model và quan sát output.” Nó không đổi được sự thật rằng một khi file trọng số nằm trên máy kẻ tấn công, abliteration hay fine-tune trực tiếp lên activation/weights vẫn hoạt động bất kể model ban đầu được adversarial-train kỹ cỡ nào — vì hai kỹ thuật đó không đi qua input prompt nữa, chúng đi thẳng vào trong model.
Mỗi hãng công bố an toàn theo một kiểu khác nhau
Meta, Alibaba (Qwen), Mistral, Zhipu (GLM), DeepSeek đều có tài liệu về safety/responsible-use, nhưng độ sâu khác nhau rõ rệt. Zhipu, ví dụ, tự báo cáo điểm SafetyBench cho GLM-4.5 ngay trong paper kỹ thuật của chính họ (arXiv:2508.06471, bảng 7): 89.9 điểm — xấp xỉ Gemini 2.5 Pro (90.5) và Kimi K2 (90.5), nhỉnh hơn GPT-4.1 (89.7), cao hơn DeepSeek-V3-0324 (88.8) và DeepSeek-R1-0528 (83.5).
Cần nói rõ caveat: SafetyBench là bộ câu hỏi trắc nghiệm đo khả năng model chọn đúng câu trả lời an toàn — không đo khả năng chống lại ai đó chủ động cố gỡ refusal bằng fine-tune hay abliteration. Hai thứ đo hai năng lực khác nhau: một bên là model có hiểu đúng cái gì an toàn, bên kia là refusal có đứng vững khi bị tấn công trực tiếp vào trọng số hay không.
Và nói thật, mình không tìm được benchmark công khai nào so sánh Qwen, DeepSeek, GLM-4.5, Mixtral và Codex cùng một phương pháp, cùng một bộ test, cùng lúc. Mỗi hãng tự chọn benchmark để công bố. Có hãng ra báo cáo red-team khá chi tiết, có hãng chỉ có một model card ngắn vài trang. Nếu thấy ai đưa ra bảng kiểu “model X bị bypass 99%, model Y chỉ 51%” gộp hết các hãng vào một bảng duy nhất — cứ hỏi nguồn trước khi tin, vì một phương pháp đủ nhất quán để so sánh công bằng giữa từng đó hãng, mình chưa thấy cái nào.
Vậy Codex và GPT đứng ở đâu
Codex và các model code closed-weight của OpenAI, cũng như GPT nói chung, Claude, Gemini — weights không bao giờ rời khỏi hạ tầng nhà cung cấp. Abliteration cần truy cập trực tiếp vào activations nội bộ, hoặc ít nhất chạy forward pass có kiểm soát trên chính trọng số, để tính được hướng refusal. Qua một API công khai, bạn không có cái đó. Threat model cho model đóng nằm ở tầng hoàn toàn khác: jailbreak prompt, và nguy hiểm hơn — prompt injection từ nội dung bên thứ ba mà một agent đọc vào trong lúc làm việc. Đó là chủ đề bài 3.
Nếu bạn đang cân nhắc release một model mở, câu hỏi đúng không phải “có ai abliteration được model của mình không” — câu trả lời luôn là có, nếu ai đó đủ quan tâm. Câu hỏi đúng là: sau khi file trọng số rời khỏi tay bạn, bạn còn kiểm soát được gì? Refusal fine-tune không phải lớp phòng thủ duy nhất nên có — nó chỉ là lớp duy nhất đi theo cùng file trọng số ra khỏi cửa.
Bài viết liên quan
· 9 phút đọc
agentic-ai
Tôi Đi Tìm Một Bảng Xếp Hạng An Toàn AI Xuyên Model. Chỉ Thấy Bốn Benchmark Không Nói Chuyện Với Nhau
Bốn benchmark an toàn AI công khai đo bốn thứ khác nhau — và benchmark gần "chính thức" nhất lại bỏ sót Claude, GPT, Gemini.
Đọc tiếp· 7 phút đọc
ai-safety
Bên trong phòng red team: các lab AI tự tấn công mô hình của mình trước khi ra mắt
Cách Anthropic, OpenAI và Google DeepMind thật sự test model trước khi ra mắt: red team nội bộ, framework chấm điểm, bug bounty công khai.
Đọc tiếp
· 8 phút đọc
Agent Evaluation
Docker Sandboxes (Harbor) Giải Quyết Việc Cô Lập Agent Eval. Không Giải Quyết Reward Hacking.
Docker Sandboxes tích hợp với framework eval mã nguồn mở Harbor chạy các bài eval agent trong microVM cô lập — giải pháp thật cho việc agent thoát khỏi sandbox. Nhưng một nghiên cứu độc lập trên 5 model, 8.989 task cho thấy tỷ lệ reward hacking 16,4% — cô lập hạ tầng và việc agent lừa điểm số là hai bài toán khác nhau.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.