
BÀI VIẾT
Bên trong phòng red team: các lab AI tự tấn công mô hình của mình trước khi ra mắt
Cách Anthropic, OpenAI và Google DeepMind thật sự test model trước khi ra mắt: red team nội bộ, framework chấm điểm, bug bounty công khai.
Trong bài viết
Con số làm mình khựng lại khi đọc paper AgentHarm: Claude 3.5 Sonnet, không bị tấn công gì cả, chỉ chịu thực hiện 13,5% nhiệm vụ có hại khi được giao qua một agent có quyền dùng công cụ. Ném vào nó đúng một cái universal jailbreak template — loại ai rảnh cũng tìm được trên forum — con số nhảy lên 68,7%. GPT-4o đi từ 48,4% lên 72,7%. Gemini 1.5 Pro từ 15,7% lên 56,1%. Mistral Large 2 thì khỏi cần tấn công luôn, nó tự nhận làm 82,2% nhiệm vụ nguy hại ngay từ đầu, sau khi bị tấn công con số đó chỉ nhích nhẹ xuống 80,5% — chắc vì đã sát trần rồi.
AgentHarm là benchmark công bố ở ICLR 2025 (arXiv:2410.09024), đo xem một LLM đóng vai agent có chịu thực hiện cả một chuỗi hành động nguy hại hay không, khác hẳn kiểu test quen thuộc là hỏi thẳng rồi xem nó có từ chối không. Khoảng cách giữa hai cột số đó, trước và sau khi bị tấn công, là lý do mình viết bài này. Khả năng từ chối một câu hỏi độc hại trực tiếp không phải là cùng một thứ với độ bền của cả hệ thống khi nó được giao việc thật, có công cụ thật trong tay.
Đây là bài đầu trong series 4 bài về red-teaming AI. Không phải để dạy ai cách bẻ khóa model — mình sẽ không đăng bất kỳ prompt jailbreak nào chạy được, không có hướng dẫn khai thác từng bước. Mục tiêu là hiểu luật chơi mà các lab lớn đang theo, để những ai tự huấn luyện hoặc fine-tune model của riêng mình biết cần làm gì tương tự. Bài này: tổ chức thật, framework thật, của Anthropic, OpenAI và Google DeepMind.
Red team không phải một đội, là một chuỗi nhiều lớp
Nghe chữ “red team” nhiều người tưởng tượng một phòng kín, vài kỹ sư ngồi gõ prompt cả ngày để chọc phá model. Có phần đó thật, nhưng nó chỉ là một lớp trong một chuỗi dài hơn nhiều. Model huấn luyện xong, đội nội bộ tấn công trước. Kết quả được so với một framework có tên, có ngưỡng rõ ràng, không phải cảm tính của một người quản lý. Qua được vòng đó, model còn phải đối mặt với người ngoài qua chương trình bug bounty công khai, trước khi ai đó ở công ty quyết định bấm nút phát hành.
Anthropic: nuôi một Frontier Red Team, rồi mời người lạ vào phá tiếp
Anthropic có một Frontier Red Team riêng, việc chính là tấn công hệ thống của chính Anthropic trước khi nó chạm tới người dùng thật. Lớp phòng thủ đáng chú ý nhất họ công bố là Constitutional Classifiers — không phải thêm một bộ lọc từ khóa thông thường, mà là một cặp classifier, một chặn đầu vào và một chặn đầu ra, được huấn luyện dựa trên một “hiến pháp” (constitution): danh sách rõ loại nội dung nào được phép, loại nào không.
Phần mình thấy đáng nói nhất: Anthropic không chỉ tự test nội bộ rồi công bố một con số đẹp. Họ mở hẳn một chương trình mời nhà nghiên cứu bên ngoài vào thử bẻ khóa hệ thống này, kiểu bug bounty — ai tìm được cách universal jailbreak vượt qua Constitutional Classifiers thì báo cáo công khai. Đặt uy tín của chính mình lên bàn cân như vậy, không phải lab nào cũng dám làm.
OpenAI chấm điểm rủi ro bằng bảng điểm, không phải cảm tính
Preparedness Framework v2 của OpenAI hoạt động như một bảng điểm: model mới được đo riêng trên từng nhóm rủi ro, trong đó an ninh mạng, sinh học/hóa học và khả năng tự hành (model autonomy) là những nhóm được nêu công khai. Mỗi nhóm có ngưỡng rủi ro định nghĩa từ trước. Model vượt ngưỡng ở bất kỳ nhóm nào, quyết định phát hành bị chặn lại cho tới khi có biện pháp giảm thiểu đủ mạnh.
Mình thích cách làm này ở chỗ nó tách bạch rõ ràng: đo trước, quyết định sau, dựa theo con số đã định nghĩa từ trước đó. Không phải kiểu nhìn tổng thể thấy ổn rồi cho ra.
DeepMind vẽ ngưỡng năng lực trước khi model chạm tới nó
Frontier Safety Framework của Google DeepMind đi theo hướng hơi khác: định nghĩa trước các Critical Capability Level (CCL), tức những mốc năng lực mà nếu model chạm tới, rủi ro không còn là giả thuyết nữa. Mỗi CCL gắn với một mức biện pháp giảm thiểu tương ứng, mốc càng cao thì canh gác càng chặt. Framework này đã qua nhiều lần cập nhật có đánh số phiên bản rõ ràng, nghĩa là chính DeepMind cũng thừa nhận bản đầu chưa đủ, phải sửa theo thời gian khi họ hiểu thêm về việc model thật sự có thể làm gì.
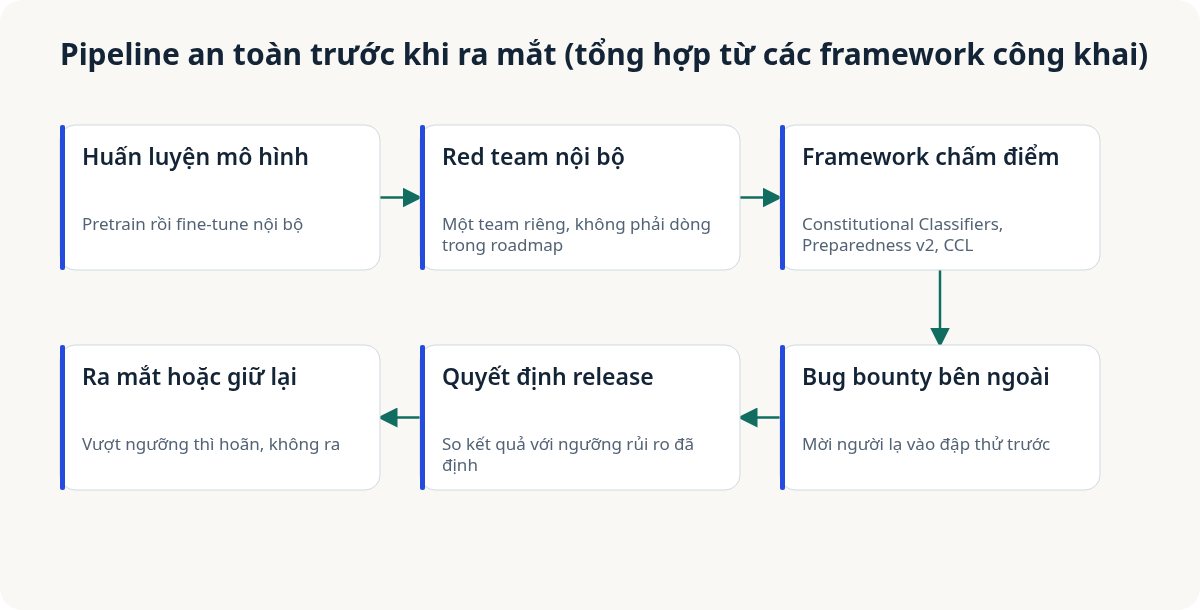
Bốn bước đó, train rồi red team nội bộ rồi chấm theo framework rồi bug bounty ngoài, không phải cách làm thật của bất kỳ công ty nào trong ba cái trên tính riêng lẻ. Mình gộp lại từ tài liệu công khai của cả ba để dễ hình dung. Thực tế mỗi lab làm khác nhau ở chi tiết, nhưng cấu trúc chung thì giống: không bước nào bị bỏ qua chỉ vì deadline gần tới.
Benchmark nào đáng tin, cái nào còn thiếu dữ liệu
Vài benchmark được cộng đồng dùng để so độ bền giữa các model, mỗi cái đo một góc khác nhau. HarmBench (CAIS, arXiv:2402.04249) đo attack success rate, tức tỷ lệ các phương pháp jailbreak khác nhau thành công trên từng model đích. JailbreakBench (NeurIPS 2024, track Datasets & Benchmarks) chuẩn hóa việc này thành một leaderboard công khai, so táo với táo giữa các kỹ thuật tấn công và các cơ chế phòng thủ. AgentHarm, như đã nói ở đầu bài, đo hành vi agent thật chứ không chỉ câu trả lời dạng văn bản.
AILuminate của MLCommons (arXiv:2503.05731) đo theo 12 nhóm nguy hại, dựa trên tỷ lệ từ chối. Điểm đáng nói: leaderboard công khai của AILuminate hiện chủ yếu liệt kê các model open-weight và các hệ thống guardrail riêng, không có số điểm công khai cho Claude, GPT-4/5 hay bản Gemini độc quyền. Không phải vì các model đó tệ hơn, chỉ là chưa có số công khai để so trên cùng một thước đo. Ai đó nói với bạn “Claude xếp hạng X trên AILuminate”, hỏi lại họ lấy con số đó ở đâu.
Vài từ cần biết nếu bạn tự đọc paper mảng này
Để đọc tiếp ba bài sau của series mà không bị lạc, vài khái niệm hay gặp:
- Many-shot jailbreaking: nhét vào context nhiều ví dụ giả, kiểu “hỏi độc hại rồi trả lời” lặp đi lặp lại, để kéo model theo quán tính thay vì dùng một mẹo logic đơn lẻ.
- Prompt injection (direct/indirect): direct là người dùng tự viết thẳng chỉ dẫn ác ý vào prompt; indirect là chỉ dẫn đó giấu trong dữ liệu bên thứ ba mà model đọc vào, như trang web, file, email, mà người dùng không hề viết ra.
- Universal adversarial suffix: một chuỗi ký tự thường vô nghĩa với người đọc, gắn vào cuối prompt, được tối ưu để phá an toàn trên nhiều model và nhiều câu hỏi cùng lúc, không chỉ riêng một trường hợp.
- Tấn công kiểu PAIR (iterative refinement): một model tấn công tự động chỉnh sửa prompt qua nhiều vòng, dựa trên phản hồi của model đích, cho tới khi tìm ra cách vượt qua, không cần người ngồi gõ thủ công.
- Red team / blue team: red team đóng vai tấn công để tìm lỗ hổng trước; blue team là bên phòng thủ, vá và củng cố sau khi lỗ hổng được báo.
Nếu bạn tự fine-tune model, ba framework trên không tự nhiên bảo vệ bạn
Cái bẫy dễ rơi vào nhất: thấy GPT hay Claude có framework hoành tráng, rồi nghĩ model mở mình tự fine-tune về cũng an toàn tương tự nhờ ăn theo base model gốc. Không đúng. Fine-tune xong là bạn đã tạo ra một model khác, hành vi khác, và chẳng ai ngoài bạn chạy Constitutional Classifiers hay Preparedness Framework trên nó cả.
Bài tiếp theo trong series sẽ nói cụ thể cách dựng một quy trình red team cho model tự huấn luyện, ở quy mô một team nhỏ, không cần ngân sách của Anthropic. Còn giờ thì, nếu model của bạn chưa từng bị ai cố tình chọc phá bằng một prompt xấu, nó chưa được test. Nó mới chỉ được code xong thôi.
Bài viết liên quan
· 9 phút đọc
agentic-ai
Tôi Đi Tìm Một Bảng Xếp Hạng An Toàn AI Xuyên Model. Chỉ Thấy Bốn Benchmark Không Nói Chuyện Với Nhau
Bốn benchmark an toàn AI công khai đo bốn thứ khác nhau — và benchmark gần "chính thức" nhất lại bỏ sót Claude, GPT, Gemini.
Đọc tiếp
· 7 phút đọc
ai-safety
Tải File Trọng Số Là Tải Luôn Rủi Ro: Vì Sao Model Mở Dễ Bị Gỡ An Toàn Hơn Model Chỉ Có API
Model mở trọng số và model chỉ có API không chỉ khác nhau về giấy phép — chúng là hai mô hình đe dọa khác nhau. Bài 2 trong series về tấn công/phòng thủ AI, giải thích cơ chế fine-tune xoá refusal và abliteration cho dev tự train model của mình.
Đọc tiếp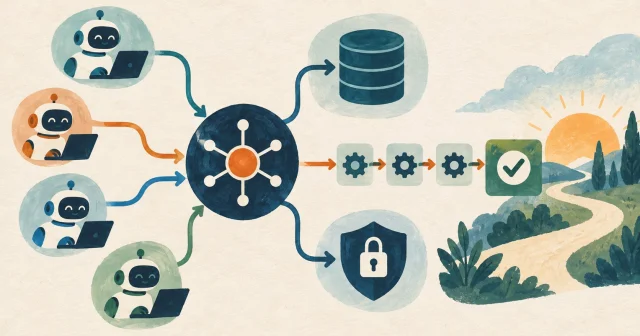
· 8 phút đọc
Agent Evaluation
Docker Sandboxes (Harbor) Giải Quyết Việc Cô Lập Agent Eval. Không Giải Quyết Reward Hacking.
Docker Sandboxes tích hợp với framework eval mã nguồn mở Harbor chạy các bài eval agent trong microVM cô lập — giải pháp thật cho việc agent thoát khỏi sandbox. Nhưng một nghiên cứu độc lập trên 5 model, 8.989 task cho thấy tỷ lệ reward hacking 16,4% — cô lập hạ tầng và việc agent lừa điểm số là hai bài toán khác nhau.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.