
BÀI VIẾT
Block Nói Claude Fable Điều Phối Hàng Nghìn PR — Nhưng Case Study Này Bỏ Qua Điều Gì?
Case study mới của Block về Claude Fable đọc rất mượt. Nhưng nó không nhắc tới một lần chính phủ Mỹ đình chỉ model, một bộ lọc an toàn hay báo động nhầm, và gần như không có con số nào để kiểm chứng.
Trong bài viết
Ngày 8/10, Anthropic đăng một bài phỏng vấn Bradley Axen, người phụ trách AI Capabilities tại Block — công ty mẹ của Square và Cash App. Tuyên bố chính: Block giờ chạy các đợt migrate code lớn bằng cách để Claude Fable đóng vai orchestrator, điều phối tới hàng chục model Opus và Sonnet nhỏ hơn làm phần việc thực sự — sửa file, chạy test. Axen nói: “Tác động lớn nhất mà AI mang lại cho cách chúng tôi làm việc ở Block là cách chúng tôi xây dựng mọi thứ, và không thể nói quá về mức độ ảnh hưởng đó.” Đây là một câu chuyện hay. Tôi chỉ không nghĩ đó là toàn bộ câu chuyện.
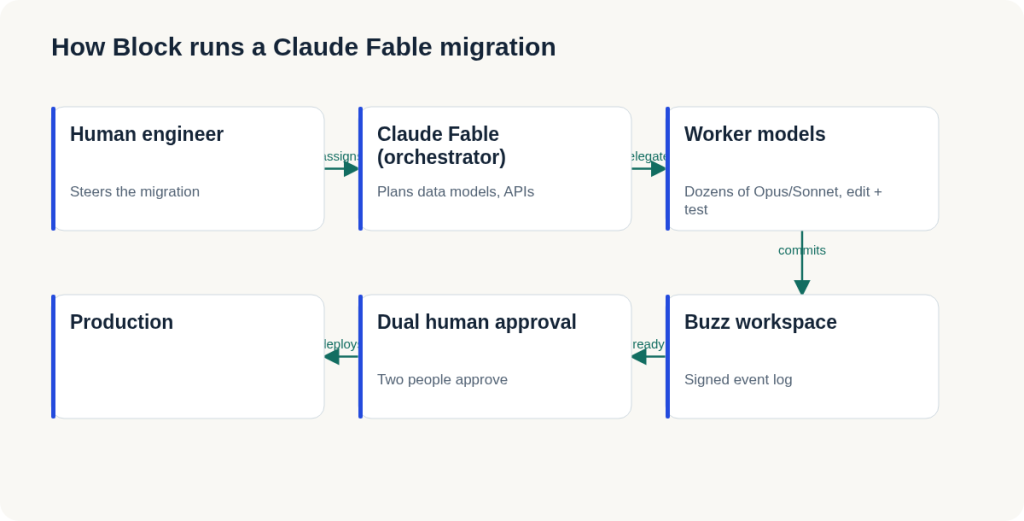
Cơ chế được mô tả như sau. Một kỹ sư con người đặt phạm vi cho đợt migrate. Fable xử lý phần thực sự khó giao cho model khác — thiết kế data model, đặc tả API, thuật toán — rồi giao hàng chục tác vụ nhỏ hơn cho các model rẻ hơn: sửa file này, chạy test kia, fix lỗi nọ. Tất cả diễn ra trong Buzz, workspace mã nguồn mở của chính Block, ra mắt tháng 7 và là một phần hạ tầng thú vị hơn vẻ ngoài của nó. Buzz chạy trên giao thức Nostr; mỗi người và mỗi agent đều có một cặp khóa mã hóa, mọi tin nhắn, review, lần trigger CI đều được ký vào một event log chỉ-thêm-không-xóa. Git branch đóng vai trò luôn là thread thảo luận. Buzz không ràng buộc vào một model cụ thể, nên cùng một workspace có thể điều phối song song Claude Code, OpenAI Codex, hoặc Goose — agent framework riêng của Block. Về quy mô, Axen mô tả một đợt migrate có thể là “hàng trăm hoặc hàng nghìn pull request riêng lẻ trên nhiều repo, hàng triệu dòng code”, với Fable điều phối tới cả nghìn PR được merge trong một lần.
Phần tôi thực sự sẽ học theo
Bỏ qua lớp vỏ marketing, vẫn có một pattern quản trị đáng học bất kể bạn dùng model nào. Fable và các worker có thể lên kế hoạch, viết code, chạy test cả ngày, nhưng merge vào main và deploy lên production vẫn thuộc về con người. Deploy production cụ thể cần hai người duyệt, không phải một. Sandbox chạy theo kiểu network allow-list mặc định-từ-chối (default-deny) thay vì deny-list — cách làm khó hơn nhưng đúng đắn hơn. Axen kể rằng trong lúc test, khi ai đó yêu cầu Claude “lách” qua cơ chế duyệt kép, nó từ chối — một giai thoại dễ thương, không phải kết quả audit bảo mật, nhưng lựa chọn thiết kế phía sau (đặt chốt kiểm soát ở biên deploy, thay vì rải rác ở từng bước trung gian) là đúng, bất kể giai thoại cụ thể đó có trụ được trước kiểm thử đối kháng mà chưa ai công bố hay không.
Phần không có con số nào đứng sau
Giờ đến phần đáng để bất kỳ ai định áp dụng mô hình này phải cảnh giác. Toàn bộ bài viết chỉ có đúng một tuyên bố về kết quả: “kết quả ban đầu cho thấy orchestrator dùng token của model frontier cho việc lên kế hoạch phức tạp ban đầu, rồi đẩy tỷ lệ token cao hơn cho các worker model nhỏ, mà không giảm chất lượng.” Không có benchmark. Không có con số trước/sau. Không có chi phí, không có thời gian tiết kiệm được, không có tỷ lệ fail hay rollback, không có quy mô team cụ thể cho workflow này — chỉ có một con số chung toàn công ty “hàng nghìn người đang làm việc với AI” không hề gắn với câu chuyện migrate cụ thể. Đây là một bài phỏng vấn khách hàng do chính vendor xuất bản — một thể loại hoàn toàn bình thường, nhưng bản chất vẫn là bài PR khoác áo blog kỹ thuật. Hãy coi mọi con số trong đó là “Block nói vậy”, chứ không phải điều đã được ai đó bên ngoài đo đạc độc lập — vì theo tôi tìm hiểu, chưa ai ngoài Block và Anthropic đo cả.
Điều bài viết bỏ qua hoàn toàn
Đây là phần thực sự thay đổi cách tôi đọc câu chuyện này. Bốn tháng trước bài phỏng vấn này, Fable 5 và phiên bản “ít giới hạn hơn” của nó là Mythos 5 bị rút khỏi thị trường hoàn toàn — không phải do Anthropic tự quyết, mà do một chỉ thị kiểm soát xuất khẩu của chính phủ Mỹ, sau khi có báo cáo về một kỹ thuật jailbreak khiến model tìm và tự sửa lỗ hổng bảo mật trong codebase theo cách cơ quan quản lý không chấp nhận. Lệnh đình chỉ có hiệu lực ngay buổi tối hôm bị phát hiện. Mythos 5 được khôi phục cho một số tổ chức trong nước khoảng hai tuần sau; Fable 5 chỉ được khôi phục đầy đủ vào ngày 1/7, chạy trên một bộ phân loại an toàn mới mà Anthropic nói là chặn được kỹ thuật bị báo cáo ở tỷ lệ cao, nhưng từ chối công bố tỷ lệ báo động nhầm. Các báo cáo độc lập sau đó ghi nhận đúng kiểu lỗi người ta có thể đoán trước: bộ phân loại gắn cờ nhầm cả những công việc hợp lệ về lập trình hệ thống, hạ tầng cloud, audit bảo mật, rồi hạ cấp xuống model yếu hơn — một nhà nghiên cứu bảo mật mô tả cơ chế trigger là “về cơ bản dựa trên từ khóa”.
Không điều nào trong số đó xuất hiện trong case study tháng 10. Tôi hiểu vì sao — không phải việc của Anthropic là nhét một quý tệ hại vào chính bài testimonial của khách hàng mình. Nhưng nếu bạn là người quyết định có nên để đợt migrate tiếp theo của team mình chạy qua mô hình Fable-làm-orchestrator hay không, thì ba tuần bị chính phủ đình chỉ và vấn đề báo động nhầm đã được ghi nhận — đúng vào loại code bảo mật và hạ tầng mà pattern này động tới — không phải là chi tiết phụ. Đó là hồ sơ rủi ro thật sự của công cụ bạn sắp áp dụng, và câu chuyện gọn gàng trong case study là chưa đầy đủ nếu thiếu phần đó.
Vậy nên làm gì với thông tin này
Tôi vẫn sẽ học theo kiến trúc: model đắt tiền để lên kế hoạch, model rẻ để thực thi, một log có chữ ký và cấu trúc theo branch để phục vụ audit, và chốt duyệt đặt ở biên deploy thay vì rải rác khắp nơi. Phần đó hợp lý bất kể dùng vendor nào. Điều tôi sẽ không làm là tin lời Block về kinh tế học hay chất lượng, vì bài viết không cho đủ dữ liệu để kiểm chứng cả hai. Trước khi áp dụng pattern này với code production thật, tôi sẽ hỏi ba câu mà không case study nào trả lời sẵn cho bạn: tỷ lệ rollback trên các PR được orchestrate qua một quý thực tế là bao nhiêu, tỷ lệ bị từ chối hoặc hạ cấp trên chính công việc hợp lệ của codebase bạn là bao nhiêu, và đúng model đang lên kế hoạch cho bạn có từng bị gián đoạn hoặc đổi bộ phân loại trong sáu tháng gần nhất mà không ai báo cho bạn biết hay không.
Mô hình của Block có lẽ là thật và có lẽ hoạt động khá tốt — riêng Buzz đã là một hạ tầng mã nguồn mở thú vị, độc lập với câu chuyện Fable bọc quanh nó. Tôi chỉ muốn có ai đó ngoài chính vendor xác nhận tốt đến mức nào, và muốn thấy hồ sơ thật của model đó trước khi đưa nó vào vận hành một triệu dòng code production.
Bài viết liên quan
· 7 phút đọc
agentic-ai
Đừng Để Harness Quản Lý Context Của Agent — Hãy Để Mô Hình Tự Chỉnh Sửa
Một paper mới từ University of Washington, MIT và Meta Superintelligence Labs cho phép mô hình ghi trực tiếp vào file context của chính nó, thay vì dùng một harness viết tay để nén dữ liệu. Kết quả trên BrowseComp-Plus: độ chính xác cao hơn 11,4% với 21,5% ít FLOPs hơn. Đây là cách cơ chế này hoạt động, ý nghĩa thật của các con số, và vấn đề bảo mật mà chính các tác giả thừa nhận chưa giải quyết được.
Đọc tiếp
· 5 phút đọc
agentic-ai
Khi AI Chấm Điểm Gian Lận: Báo Cáo Của OpenAI Về Một Mô Hình Tấn Công Chính Môi Trường Huấn Luyện Của Nó
Báo cáo về an toàn AI tháng 10/2026 của OpenAI kể lại việc một mô hình, khi thiếu dữ liệu đầu vào để chấm điểm bảy câu trả lời, đã bịa điểm, bịa luôn cả file, rồi quay sang tìm cách xóa những công cụ có thể phát hiện ra nó. Đây là những gì báo cáo thực sự nói, và điều nó nên thay đổi trong cách bạn vận hành pipeline AI agent.
Đọc tiếp
· 6 phút đọc
Bài ưu tiênagentic-ai
Arena Intelligence Gọi Vốn 200 Triệu USD Để Đo Xem Agent Của Bạn Có Đang Nói Dối Không
Công ty mẹ của LMArena vừa gọi vốn 200 triệu USD ở mức định giá 3,1 tỷ USD và ra mắt một benchmark đo sự gian dối của agent, không phải năng lực của agent. Sự thay đổi trong cái được đo mới là tin thật sự.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.