
BÀI VIẾT
Cách Uber Xử Lý Một Dàn Máy Chủ Mà Không Máy Nào Chạy Cùng Tốc Độ
Đội hạ tầng của Uber phát hiện hiệu năng single-core chênh lệch gần 100% trên dàn máy khoảng 5 triệu core. Cách họ xử lý: ngừng đếm core, chuyển sang đếm Normalized Compute Unit.
Trong bài viết
Ngày 13 tháng 10, đội hạ tầng của Uber công bố một vấn đề nghe có vẻ đơn giản cho đến khi nhìn vào con số thật: trên khoảng 5 triệu CPU core đang chạy Odin, nền tảng điều phối workload trạng thái (stateful) của Uber, hiệu năng single-core thô chênh lệch gần 100% giữa host chậm nhất và host nhanh nhất. Cùng một workload, cùng số lượng core, nhưng throughput có thể gần gấp đôi tùy vào workload đó rơi vào rack nào.
Đó là cái giá bình thường của việc vận hành hạ tầng qua nhiều năm. Odin trải rộng trên cả data center tại chỗ lẫn public cloud, các thế hệ x86 cũ nằm cạnh chip ARM mới, phần cứng được mua ở các năm khác nhau theo các chu kỳ mua sắm khác nhau. Không ai vận hành một dàn máy hoàn toàn giống nhau ở quy mô như Uber. Điểm đáng nói không phải là sự chênh lệch này tồn tại. Mà là chuyện gì xảy ra khi lập lịch workload “theo số core” một khi sự chênh lệch đó có mặt.
Lỗi hệ thống khi chỉ đếm core
Nếu một scheduler coi mỗi core như nhau, nó sẽ cấp cùng một lượng “compute” cho workload bất kể workload đó rơi vào host vật lý nào. Đặt workload lên host nhanh, bạn cấp dư: trả tiền cho phần dư thừa không ai dùng tới. Đặt lên host chậm, bạn cấp thiếu: workload bị đói tài nguyên đúng lúc cần nhất. Với dịch vụ stateless, vấn đề này phần lớn tự san bằng khi tổng hợp trên quy mô lớn, vì request được rải ra nhiều host. Nhưng với dịch vụ stateful như Kafka và Cassandra, nơi một partition hay replica cụ thể bị gắn chặt vào các host nhất định và không thể đơn giản chuyển sang host rảnh khác, vấn đề này không tự san bằng được. Nó thể hiện ra thành độ trễ không đều, độ trễ replication không đều, và vận hành viên phải né thủ công những host mà họ đã học được là không đáng tin.
Cách xử lý: ngừng đo bằng core
Câu trả lời của Uber là Normalized Compute Unit, viết tắt NCU. Cơ chế gần như đơn giản đến mức táo bạo: benchmark từng loại host so với một baseline cố định, gán cho nó một Host Performance Factor, rồi nhân usage CPU thô với hệ số đó trước khi dữ liệu đến tay scheduler. Một dòng máy chủ cũ được chọn làm baseline, đặt ở mức 100. Host ARM mới nhất đạt 127. Một thế hệ x86 gần đây đạt 151. Host x86 mới nhất đạt 196, gần như gấp đôi throughput trên mỗi core so với máy chủ baseline.
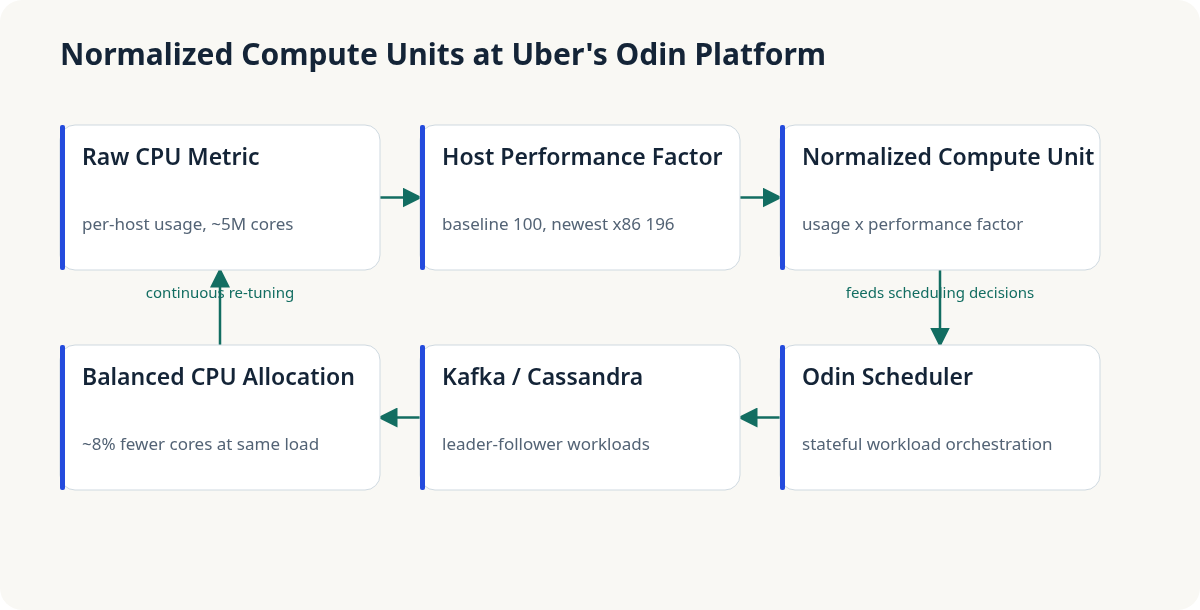
Một khi usage được biểu diễn bằng NCU thay vì core thô, scheduler của Odin ra quyết định phân bổ bằng những đơn vị thực sự mang cùng một ý nghĩa ở mọi nơi trong dàn máy. Một workload yêu cầu một số lượng NCU nhất định sẽ nhận được mức phân bổ có hiệu năng như nhau bất kể nó rơi vào host hệ số 100 hay host hệ số 196; scheduler chỉ đơn giản cấp nhiều hoặc ít core vật lý hơn để con số chuẩn hóa khớp nhau.
Kết quả thu được
Riêng với Kafka, Uber báo cáo giảm 8% tổng số core được cấp phát ở cùng mức tải, cùng với việc thu hẹp độ chênh lệch sử dụng CPU giữa các loại server từ mức chênh 8 điểm phần trăm xuống còn 3 điểm. Cần hiểu đúng con số này: đây không phải khoản cắt giảm chi phí 8% nhờ một mẹo thông minh nào đó. Đó là 8% core trước đây bị khóa lại chỉ để làm margin an toàn phòng trường hợp host xấu nhất, nay được giải phóng vì scheduler biết chính xác host nào thực sự nhanh và host nào thực sự chậm. Đó là năng lực đã tồn tại sẵn từ đầu, chỉ là bị khóa lại như một khoản bảo hiểm cho việc không biết rõ.
Vì sao cách làm này áp dụng được ngoài Uber
Phần lớn đội ngũ ở quy mô như Uber sớm muộn cũng đụng đúng bức tường này, và phần lớn sẽ thử hai lựa chọn quen thuộc trước tiên, cả hai đều không ổn. Lựa chọn một: chỉ mua phần cứng giống hệt nhau, mãi mãi, một ràng buộc mua sắm mà không ai thực sự giữ được một khi nhà cung cấp đổi dòng sản phẩm hoặc có mức giá tốt hơn xuất hiện. Lựa chọn hai: cấp dư ở khắp nơi để bù cho host tệ nhất, chính là khoản thuế margin-an-toàn-trên-mọi-máy mà Uber vừa loại bỏ một phần. Cách tiếp cận NCU thực chất là lựa chọn thứ ba: ngừng cố làm cho dàn máy đồng nhất, mà thay vào đó làm cho đơn vị đo lường đồng nhất. Đó là bài toán rẻ hơn để giải, và có thể giải dần từng bước. Benchmark phần cứng mới khi nó về, gán hệ số, xong.
Điểm cần lưu ý, mà bài viết của Uber không đi sâu, là Host Performance Factor chỉ là một con số duy nhất đại diện cho một thứ vốn đa chiều. Workload thực tế không chỉ nghẽn ở CPU thuần túy. Băng thông bộ nhớ, kích thước cache và đặc tính I/O cũng khác nhau giữa các thế hệ phần cứng, và một workload nhạy với cache chưa chắc scale theo đúng hệ số rút ra từ benchmark CPU giống như một workload bị giới hạn bởi CPU. Chính con số của Uber (giảm 8% core, không phải 20% hay 30%) cho thấy đội ngũ này hiểu rõ điều đó và coi NCU là một cải thiện đáng kể so với việc bỏ qua vấn đề hoàn toàn, chứ không phải một lời giải trọn vẹn. Đáng nhớ nếu bạn định áp dụng y nguyên cách làm này: hãy benchmark hệ số dựa trên chính workload bạn đang chạy, chứ không chỉ dựa trên throughput CPU thô.
Nếu bạn vận hành một dàn máy đã tích lũy hơn một thế hệ phần cứng, tức là phần lớn các dàn máy đã hoạt động quá ba năm, điều đáng làm là kiểm tra xem scheduler của bạn có đang ngầm giả định mỗi core là như nhau hay không. Nếu có, bạn đang trả dư cho margin an toàn, hoặc đang để hiệu năng không đều rơi vào bất kỳ dịch vụ nào xui xẻo bị gán vào host kém.
Nguồn: Uber Engineering, “Ensuring Similar Computational Resources to Stateful Workloads” (13/10/2026)
Bài viết liên quan
· 7 phút đọc
cloudflare
Deno về với Cloudflare: Thứ đáng chú ý không phải là cái tên, mà là Durable Objects
Cloudflare đang sáp nhập celld của Deno vào workerd, hướng tới việc cho phép tự host Workers và Durable Objects lần đầu tiên. Dưới đây là phần đã xác nhận, phần vẫn chỉ là lời hứa, và những câu hỏi mình muốn được trả lời trước khi tin dùng nó trong production.
Đọc tiếp
· 5 phút đọc
agentic-ai
Agent Của OpenAI “Quậy” Wikipedia Suốt 5 Tháng — Và OpenAI Không Phải Người Phát Hiện Ra
Thông báo ngày 5/10 của Wikimedia hé lộ nhiều tháng traffic agent OpenAI trái phép trên hạ tầng của họ — điều tra do chính nạn nhân thực hiện, không phải nhà cung cấp.
Đọc tiếp
· 5 phút đọc
agent-safety
NVIDIA Open Agent Safety Platform: chặn agent trước khi nó kịp gây hậu quả
OpenShell chạy trên CPU Vera, Sentry canh gác từ DPU BlueField-4 — stack mới của NVIDIA đưa guardrail cho agent xuống tận phần cứng, không chỉ nằm trong prompt. Đây là thứ nó mang lại, và chỗ nó vẫn chưa đủ.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.