
BÀI VIẾT
Kiểm thử voice AI với Pipecat và Gemini Live: độ trễ, giọng nói và chất lượng hội thoại
Hướng dẫn thực hành kiểm thử voice AI: cấu hình, timeline độ trễ, prompt gia sư/phỏng vấn, buổi test 20 phút, chẩn đoán rè/echo, log và kết quả LingoLive.
Trong bài viết
Khi làm LingoLive, tôi gặp một tình huống khá quen thuộc với sản phẩm voice AI: kết nối đã chạy, AI đã nói, nhưng người dùng vẫn thấy giọng rè, câu trả lời chậm hoặc AI nghe tiếng từ loa rồi tự trả lời. Một demo nói được vài câu chưa giúp tôi trả lời câu hỏi quan trọng hơn: người dùng có thể học hoặc luyện phỏng vấn thoải mái trong một buổi dài không?
Tôi bắt đầu tách việc kiểm thử thành ba phần: đường truyền có hoạt động, âm thanh có dễ nghe, và hội thoại có thực sự giúp người dùng. Bài này chia sẻ cách tôi tổ chức kiểm thử với Pipecat và Gemini Live, những gì đã đo được, và những gì vẫn cần người thật, thiết bị thật.
Trong bài này
- Một kết nối thành công chưa phải một buổi học tốt
- Đo độ trễ từ đúng thời điểm
- Bắt đầu từ kiến trúc và cấu hình đang chạy
- Một ví dụ tính độ trễ để tránh tối ưu sai
- Thiết kế buổi test 20 phút có mục đích
- Chẩn đoán giọng rè và AI tự nói tự trả lời
- Prompt phải trở thành quy tắc có thể kiểm tra
- Voice interview cần một bộ tiêu chí khác gia sư
- Mạng yếu và phục hồi phải kiểm tra theo từng lớp
- Log thế nào để dev tìm được lỗi sau buổi học
- Kết quả LingoLive và cách tôi đọc chúng
- Dev và agent có thể chạy lại như thế nào
- Tiêu chí phát hành cần đi cùng bằng chứng
Một kết nối thành công chưa phải một buổi học tốt
Trong các lượt thử ngắn, WebSocket và WebRTC đều có thể kết nối, nhận âm thanh và đóng phiên. WebRTC còn ghi nhận mất gói bằng 0 trong những lượt đó. Nhưng các con số này không cho biết một chiếc loa có bị rè, một bé có hiểu câu hỏi, hay gia sư có dịch đúng theo cấu hình của phụ huynh.
Vì vậy tôi dùng ba mức bằng chứng. Test code kiểm tra cấu hình và trạng thái. Test trực tiếp bằng âm thanh giả lập kiểm tra đường đi qua provider và ứng dụng. Test trên điện thoại, laptop, loa và tai nghe thật kiểm tra trải nghiệm nghe–nói. Một màn hình điện thoại mô phỏng vẫn chỉ là trình duyệt desktop với kích thước khác.
Đo độ trễ từ đúng thời điểm
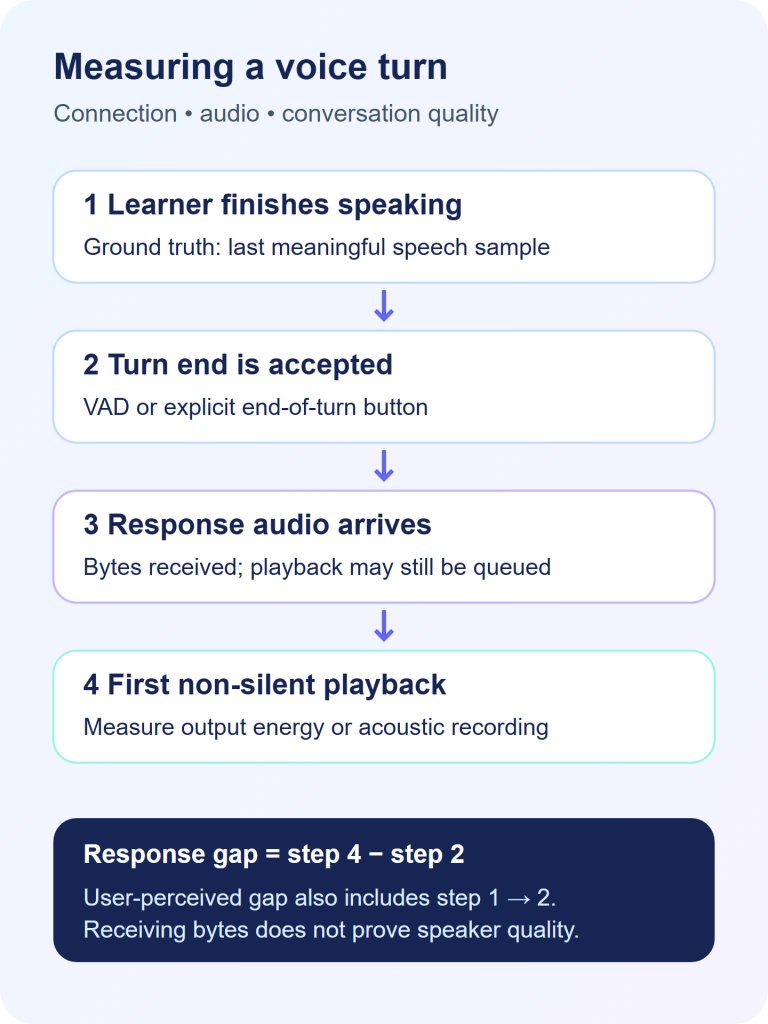
Câu hỏi đầu tiên khi thấy một con số độ trễ là: đo từ đâu đến đâu? Tôi phân biệt lúc người dùng thực sự dừng nói, lúc hệ thống nhận kết thúc lượt, lúc byte âm thanh đầu tiên về và lúc có âm thanh không im lặng được phát. Nếu chỉ đo lúc model bắt đầu trả dữ liệu, tôi có thể bỏ sót thời gian chờ nhận diện kết thúc câu và hàng đợi phát âm thanh trong trình duyệt.
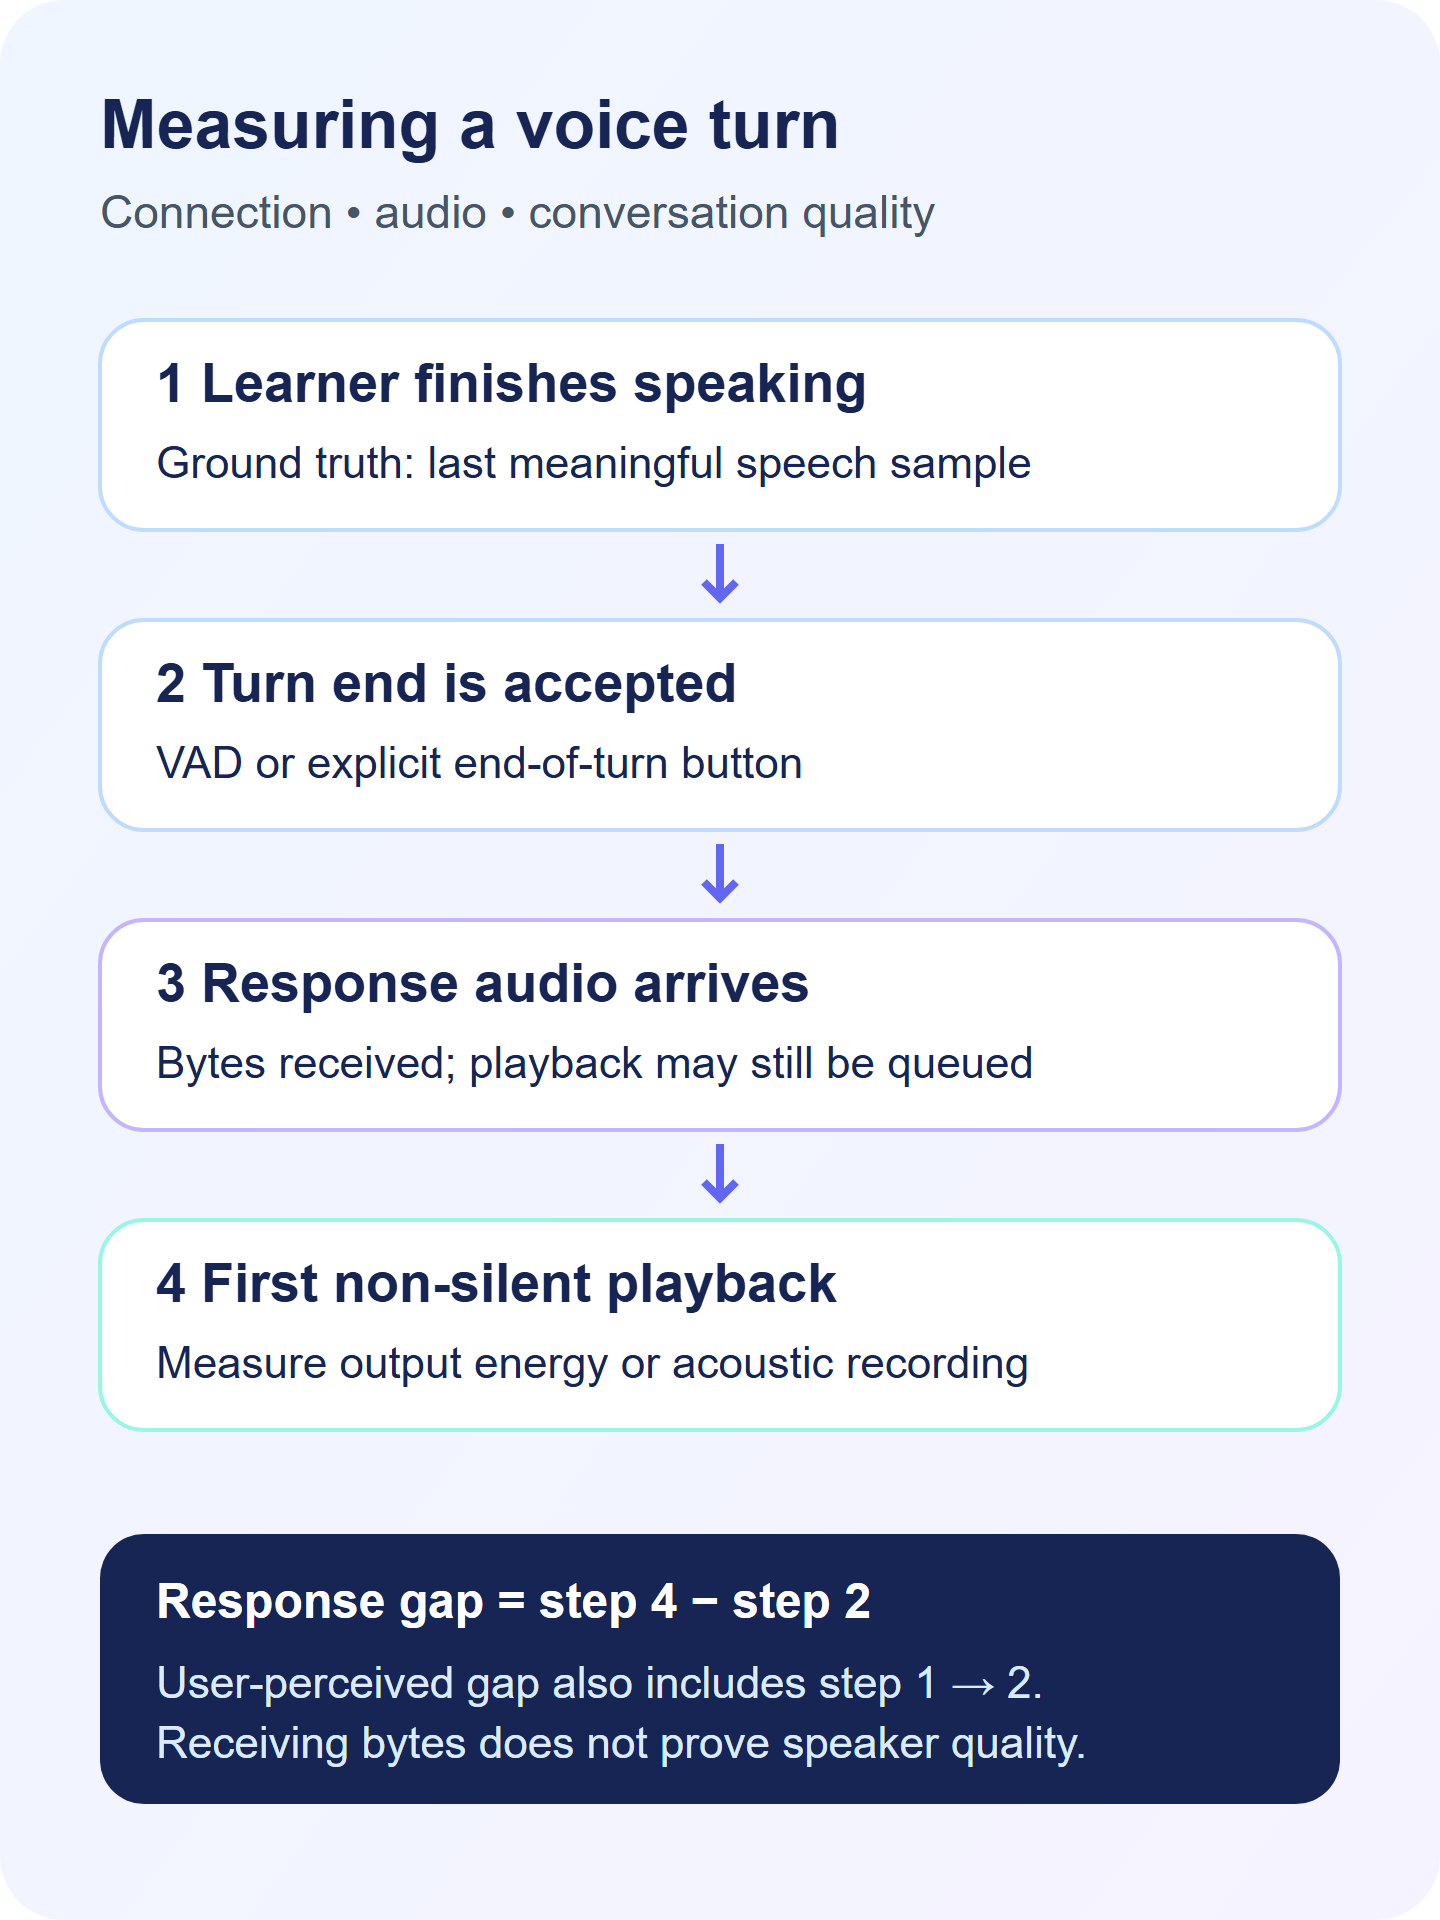
Pipecat có các metric cho từng dịch vụ. Tôi dùng chúng để tìm đoạn chậm, rồi đối chiếu với phép đo ở phía trình duyệt. Hai loại số đo phục vụ hai câu hỏi khác nhau: provider có chậm không, và người dùng phải chờ bao lâu?
Báo cáo cần số lượt hợp lệ, số lượt thiếu phản hồi, median, p95 và giá trị lớn nhất. Với vài lượt thử, tôi giữ cả các giá trị riêng lẻ thay vì dùng một p95 trông rất chính xác. Một lượt timeout vẫn là kết quả; không nên bỏ nó ra để số trung bình đẹp hơn.
Bắt đầu từ kiến trúc và cấu hình đang chạy
Để sửa đúng chỗ, tôi vẽ đường đi của âm thanh trước. Với Gemini trực tiếp, trình duyệt thu tiếng, chuyển sang định dạng đầu vào, gửi tới model rồi nhận và phát âm thanh. Với Pipecat, có thêm agent phía server để quản lý pipeline và transport. Trong LingoLive, Pipecat cũng dùng Gemini Live: đây không phải cuộc so tài giữa hai model độc lập. Khi so sánh, phần khác biệt cần kiểm tra là đường truyền, vòng đời phiên, xử lý lượt nói và cách đưa âm thanh tới loa.
Cấu hình của mỗi lượt thử phải được chụp lại thành manifest: commit, model thực nhận, voice, SDK, transport, thiết bị, trình duyệt, prompt hash, chế độ kết thúc lượt và profile. Kết quả ngày 13/10/2026 ghi nhận Gemini gemini-3.8-live, Pipecat Python 1.12.0, client-js 1.13.1 và WebSocket transport 1.7.2. Đây là phiên bản quan sát được trong deployment của tôi; muốn dùng lại phải kiểm tra tài khoản/provider của bạn có hỗ trợ model đó.
Trên điện thoại, vuốt ngang các bảng để xem đủ cột.
| Điểm cấu hình | Cần ghi nhận | Lỗi dễ bị che khuất |
|---|---|---|
| Âm thanh đầu vào | Sample rate thực, số kênh, PCM/codec | Đổi nhãn sample rate nhưng không resample |
| Đầu ra | Sample rate khai báo, decoder, queue phát | Phát sai tốc độ hoặc queue tăng dần |
| Kết thúc lượt | VAD, thời gian chờ im lặng, nút kết thúc | Cắt câu khi người học ngập ngừng |
| Mic | Thiết bị và getSettings() thực | Đã yêu cầu khử echo nhưng thiết bị không áp dụng |
| Prompt | Nội dung hiệu lực sau khi ghép profile | Base prompt đúng nhưng cấu hình tuổi/ngôn ngữ bị mất |
| Server | CPU/RSS, event-loop, số phiên, region | Đổ lỗi cho model khi worker đang quá tải |
Tôi không bật/tắt hàng loạt option rồi nghe xem có khá hơn không. Mỗi thử nghiệm chỉ đổi một yếu tố, giữ nguyên đoạn nói và câu hỏi. Nếu thay cả model, voice, transport và VAD, kết quả tốt hơn cũng không chỉ ra yếu tố nào giúp ích.
Một ví dụ tính độ trễ để tránh tối ưu sai
Giả sử người học dừng nói ở 10.000 ms; hệ thống chấp nhận kết thúc lượt ở 10.650 ms; byte âm thanh về ở 11.250 ms; tiếng đầu tiên được phát ở 11.420 ms. Đây là ví dụ tính toán, không phải số đo của LingoLive. Người học chờ 1.420 ms, trong khi metric tính từ kết thúc lượt chỉ là 770 ms. Phần 650 ms endpointing đã chiếm gần một nửa thời gian chờ.
endpointing = 10650 - 10000 = 650 ms
turn-to-playback = 11420 - 10650 = 770 ms
bytes-to-playback = 11420 - 11250 = 170 ms
user-perceived-gap = 11420 - 10000 = 1420 ms
Nếu 650 ms là khoảng chờ cần thiết để bé nói tiếp sau một lần ngập ngừng, giảm nó có thể làm điểm benchmark đẹp hơn nhưng buổi học tệ hơn. Vì vậy tôi đo thêm turn fragmentation: một câu người dùng định nói bị hệ thống chia thành mấy lượt. Độ trễ và khả năng nghe hết câu phải được đánh giá cùng nhau.
Các mốc ở trình duyệt dùng cùng đồng hồ đơn điệu performance.now(). Log phía server được nối bằng run/turn ID; tôi không lấy giờ server trừ giờ laptop khi chưa xử lý lệch đồng hồ. Mốc “bot speaking” cũng chỉ là trạng thái SDK. Muốn đo tiếng thực sự phát ra loa phải dùng bản ghi tham chiếu/loopback phù hợp và ghi rõ đường thu.
Một lượt quá 15 giây không có tiếng phải đi vào nhóm timeout. Tôi báo cáo số lượt đủ điều kiện, số timeout và số sample thiếu riêng; percentile của các lượt thành công luôn đi kèm tỷ lệ thất bại. Không thay timeout thành 0 ms, cũng không bỏ nó khỏi báo cáo để median đẹp hơn.
Thiết kế buổi test 20 phút có mục đích
Một buổi dài chỉ im lặng chờ hết giờ chủ yếu kiểm tra phiên còn sống. Để kiểm tra trải nghiệm, tôi dùng lịch dưới đây cho phiên trên thiết bị thật. Lịch này là protocol đề xuất; nó không có nghĩa mọi bước đã được chạy trong hai phiên giả lập 15 phút.
| Thời gian | Thao tác | Quan sát cần giữ |
|---|---|---|
| 0–3 phút | Mở phiên, trả lời bình thường, nghe lời chào | Thời gian kết nối, chất lượng tiếng, AI có nghe lại loa không |
| 3–6 phút | Nói nhỏ; dừng giữa câu 1–2 giây rồi nói tiếp | Có nhận được ý; có cắt lượt hay bắt hỏi lại |
| 6–9 phút | Trả lời sai; nói chưa hiểu; xin gợi ý | Dịch, giải thích, đếm lần thử và khen đúng sự thật |
| 9–12 phút | Nói chen khi AI đang nói; để phòng im lặng | Dừng queue phát; phân biệt chen thật với tiếng echo |
| 12–15 phút | Giới hạn mạng rồi ngắt 20 giây | UI đổi trạng thái, timeout, mic và đường phục hồi |
| 15–18 phút | Khôi phục mạng, tiếp tục/chạy lại | Giữ lịch sử hay phiên mới; có tính quota hai lần không |
| 18–20 phút | Kết thúc, xem báo cáo, mở phiên mới | Mic tắt, session server hết, báo cáo bám hội thoại |
Ma trận tối thiểu gồm laptop–loa, laptop–tai nghe, điện thoại–loa, điện thoại–tai nghe. Mỗi ô ghi OS, browser, loại tai nghe, mức âm lượng và vị trí mic. Bluetooth nên là một ô riêng nếu sản phẩm hỗ trợ, vì đường âm thanh khác tai nghe dây. Với trẻ nhỏ, chia phiên và nghỉ khi cần; không bắt bé hoàn thành checklist để đạt đủ thời gian.
Chẩn đoán giọng rè và AI tự nói tự trả lời
Khi người dùng nói “giọng bị rè”, tôi tách hai bản: tín hiệu số ứng dụng nhận/phát và âm thanh nghe ở thiết bị. Nếu bản số sạch nhưng loa rè ở âm lượng lớn, cần kiểm tra thiết bị và gain. Nếu bản số cũng méo, tôi kiểm tra resampling, clipping và lịch phát từng chunk. Đây là cách khoanh vùng, không phải kết luận rằng loa luôn có lỗi.
| Dấu hiệu | Giả thuyết cần kiểm tra | Phép thử phân biệt |
|---|---|---|
| Cao/thấp giọng, nhanh/chậm bất thường | Sample rate hoặc resampling sai | Phát cùng clip chuẩn qua đúng rate, đối chiếu thời lượng |
| Rè ở những âm lớn | Clipping/gain hoặc loa | So peak/clip fraction và nghe cùng clip bằng tai nghe |
| Lách tách giữa chunk | Nối chunk/resampler hoặc lịch phát | Đánh dấu biên chunk, theo dõi queue/underrun |
| AI tự trả lời lúc người học im lặng | Echo hoặc trigger sai | So loa với tai nghe, đối chiếu transcript và mic-energy |
| Chậm dần sau nhiều phút | Queue, CPU, context hoặc provider | So độ trễ từng cửa sổ với queue và tài nguyên |
Ví dụ với PCM đã chuẩn hóa về −1…1, RMS cho biết mức năng lượng trung bình; peak là đỉnh; clip fraction đếm tỷ lệ sample sát biên. Tôi giữ cả đoạn méo cụ thể để nghe lại, vì một peak cao đơn lẻ không đủ chứng minh clipping. Khi kiểm tra WebRTC, tỷ lệ mất gói được tính bằng chênh lệch counter giữa hai lần lấy mẫu; jitter phải đổi từ giây sang ms. Counter thiếu không được coi là 0. Định nghĩa có trong W3C WebRTC Stats.
rms = sqrt(mean(x * x))
rmsDbFS = 20 * log10(rms)  # chỉ khi rms > 0
clipFraction = count(abs(x) >= 0.999) / sampleCount
lossInterval = deltaLost / (deltaLost + deltaReceived)
Với tình huống AI tự nói tự trả lời, thử đầu tiên là để người học im lặng suốt một câu của gia sư. Nếu xuất hiện transcript người dùng trùng nội dung đang phát, tôi có bằng chứng về vòng lặp cần điều tra. Lặp lại bằng tai nghe, giữ mức câu hỏi tương đương. Chế độ trẻ em có thể chủ động khóa input khi cô đang nói và mở khi đến lượt bé; đánh đổi là bé không chen lời tự nhiên được. Chế độ phỏng vấn người lớn cần barge-in, nên phải kiểm tra khử echo và xóa queue âm thanh cũ khi ngắt.
Prompt phải trở thành quy tắc có thể kiểm tra
Prompt “hãy là gia sư thân thiện, giúp bé phát âm tốt” quá rộng. Nó không xác định thế nào là giúp, khi nào cần dịch, hay lúc nào dừng sửa. Tôi viết prompt theo tình huống rồi định nghĩa expected behavior cho từng câu trả lời. Ví dụ dưới đây là mẫu để thích nghi, không phải cam kết model luôn tuân thủ.
Vai trò: gia sư tiếng Anh cho bé mới bắt đầu.
Mỗi lượt: một câu hỏi ngắn, rồi chờ bé.
Nếu translation=always: ngay sau câu hỏi tiếng Anh,
  thêm một câu tiếng Việt ngắn có cùng ý.
Khi bé chưa hiểu: giải thích đơn giản, không thêm bài mới.
Khi sửa phát âm: một từ, một gợi ý, một lượt đọc lại.
Chỉ đếm lần bé thực sự thử nói từ mục tiêu.
Help, im lặng và xin bỏ qua không tính là lần thử.
Tối đa 3 lần thử; sau đó động viên và chuyển mục tiêu.
Khen nỗ lực; chỉ khen trả lời đúng khi có căn cứ.
Nếu âm thanh không rõ: nói chưa nghe rõ, không đoán lỗi.
Kết thúc: nêu điều đã làm tốt và một bước luyện tiếp.
Nếu số lần thử là yêu cầu cứng, tôi ưu tiên state của ứng dụng thay vì để model nhớ một con số trong đoạn hội thoại dài: target → attempt → hint → retry → mastered/skip. Model diễn đạt lời hỗ trợ; state quyết định còn được yêu cầu thử lại hay không. Transcript “lion” không đủ chứng minh bé phát đúng âm /l/; đánh giá phát âm cần audio và phải cho phép kết luận chưa chắc chắn.
| Tình huống | Câu trả lời đạt | Câu trả lời không đạt |
|---|---|---|
| Bé nói “I don’t understand” | Giải thích tiếng Việt, lặp lại một câu dễ hơn | Hỏi thêm ba câu tiếng Anh |
| Đoán sai con vật | Khen đã thử, đưa một gợi ý phù hợp | “Perfect!” rồi tính là đúng |
| Đã thử từ mục tiêu 3 lần | Động viên, chuyển câu hoặc cho bỏ qua | Yêu cầu đọc lần thứ tư |
| Mic không rõ | Xin nói lại/chọn đáp án, ghi độ chắc chắn thấp | Khẳng định bé sai một âm cụ thể |
Voice interview cần một bộ tiêu chí khác gia sư
Người luyện phỏng vấn cần trình bày kinh nghiệm đủ dài, có khoảng dừng để suy nghĩ và được hỏi tiếp dựa trên điều vừa nói. Một agent quá nhanh, hỏi liên tục hoặc ngắt ở mỗi khoảng im lặng sẽ làm bài luyện mất giá trị. Tôi giữ một câu hỏi ở mỗi lượt nhưng cho phép độ dài câu trả lời khác chế độ trẻ em.
Ví dụ ứng viên nói: “We had a checkout incident after a release. I coordinated rollback and added a canary.” Follow-up có ích là hỏi cách xác định phạm vi ảnh hưởng, vai trò cụ thể hoặc vì sao chọn rollback. Câu “What are your strengths?” có thể hợp lệ ở đoạn khác, nhưng bỏ qua hoàn toàn câu trả lời này thì không đạt tiêu chí follow-up. Báo cáo cũng không được tự bổ sung “giảm downtime 50%” nếu ứng viên chưa nói.
Role: interviewer for a product/engineering lead.
Ask one question and let the candidate finish.
Follow up on a concrete claim in the last answer.
Ask for evidence when an impact is unspecified.
Do not invent responsibilities, dates or results.
When asked to clarify, rephrase without giving an answer.
At the end: cite observed examples, one strength,
  up to three improvements, and a short practice task.
Label advice as advice; do not present a hiring decision.
Tôi chấm riêng: câu hỏi có đúng vai trò, follow-up có bám nội dung, có nghe hết câu, feedback có dẫn chứng và có phân biệt kỹ năng giao tiếp với kiến thức chuyên môn. Phần giọng được hai người nghe chấm độ rõ, tự nhiên và công sức phải bỏ ra để nghe. Điểm nội bộ 1–5 phục vụ so sánh cấu hình, không thay thế một nghiên cứu MOS chuẩn hóa.
Mạng yếu và phục hồi phải kiểm tra theo từng lớp
Profile dùng trong lượt rerun ngắn là latency 400 ms, download 32.000 byte/giây và upload 16.000 byte/giây, rồi offline 20 giây. Tôi ghi đơn vị byte/giây để tránh nhầm thành bit/giây. CDP là mô phỏng trình duyệt; nó không bao phủ mọi kiểu mất gói, roaming Wi-Fi hay thay đổi route trên điện thoại. Với WebRTC, cần kiểm tra đường media thực chịu impairment, không suy từ request HTTP chậm.
Trong test tôi xác nhận request cùng origin thật sự thất bại ở trạng thái offline, sau đó chủ động đóng socket native để kiểm tra nhánh lifecycle. Hai thao tác này có mục đích riêng: request xác nhận offline; đóng socket kiểm tra xử lý lỗi đóng kết nối. Không gọi kết quả đó là bằng chứng hoàn chỉnh cho việc rút mạng vật lý.
Sau khi mạng về, tôi ghi một trong ba kết quả: resume cùng context; fresh start mất context; hoặc reload mới chạy. UI cần nói đúng trạng thái. Trong dữ liệu hiện tại, Pipecat phục hồi bằng start mới và Direct bằng reload/phiên mới; chưa có bằng chứng tự resume giữ toàn bộ lịch sử. Tôi còn kiểm tra mic có dừng, quota có bị giữ oan và server có phiên mồ côi hay không.
Log thế nào để dev tìm được lỗi sau buổi học
Một log “connection failed” không đủ. Mỗi turn cần chuỗi event có timestamp và phase, còn dashboard cần nhóm theo engine, transport, version, network và outcome. Log thường chỉ cần metadata; transcript hoặc audio có thể được giữ riêng theo quyền và thời hạn đã thống nhất, nhất là dữ liệu trẻ em.
{
  "event": "voice.turn.audio_started",
  "runId": "random-test-run", "turnId": "turn-04",
  "engine": "pipecat", "transport": "websocket",
  "turnEndMs": 10650, "firstAudioMs": 11420,
  "responseGapMs": 770, "outcome": "response",
  "promptHash": "hash-of-effective-prompt",
  "synthetic": true
}
# Schema minh họa; không phải log production đã thu.
Các event nên phân biệt speech_end, turn_accepted, audio_received, audio_started, interrupted, socket_closed, restart_ready và mic_stopped. Error cần stage và loại lỗi; không đưa API key, bearer token, signed URL hoặc thông tin riêng của bé vào log. Một metric đơn lẻ chỉ hữu ích khi biết nó đang đo stage nào.
Kết quả LingoLive và cách tôi đọc chúng
| Bằng chứng | Kết quả | Kết luận hợp lệ |
|---|---|---|
| Hai phiên 900 giây, 7 lượt giả lập/phiên | Có audio response diagnostic, không lỗi render quan sát được | Đường ứng dụng chạy qua buổi giả lập dài |
| Input giảm gain còn 8% | Có phản hồi | Chấp nhận tín hiệu giảm biên độ; chưa chứng minh hiểu tiếng thì thầm |
| Yêu cầu giải thích tiếng Việt | Có lời giải thích | Help request hoạt động trong lượt đã thử |
| Translation=always | Có câu hỏi sau đó thiếu dịch | Không đạt compliance của profile |
| Fault test native sau sửa, 180 giây/chế độ | Không page error; start mới có data; mic dừng | Nhánh lỗi/đóng phiên qua smoke test |
| Điện thoại, loa/tai nghe thật | Chưa chạy đầy đủ | Chưa kết luận chất lượng âm thanh thực tế |
Diagnostic của 7 lượt Pipecat là 492, 137, 1.791, 842, 1.085, 684, 378 ms; Direct là 686, 858, 1.477, 1.089, 934, 590, 651 ms. Tôi công khai các giá trị để thấy biến thiên, nhưng không xếp hạng hai bên: callback kết thúc lượt khác nhau, sample rất ít và harness ban đầu có proxy. Phần impairment của lượt dài bị loại khỏi kết luận mạng yếu; rerun native chỉ dài 180 giây, không biến nó thành một lượt native 15 phút.
Một lỗi thật tìm được ở nhánh fatal error là ứng dụng và SDK cùng gọi disconnect, làm recorder bị đóng hai lần. Cách sửa cho mỗi client dùng một promise disconnect chung giúp hai caller chia sẻ một teardown. Regression test kiểm tra chỉ chạy cleanup một lần; 275 unit test và build production đã qua tại lần kiểm tra này. Những kết quả đó không xóa lỗi coaching còn tồn tại.
Dev và agent có thể chạy lại như thế nào
Repo có harness Playwright, fixture generator và report template. Chuẩn bị account giả lập riêng, manifest và WAV trước khi chạy; token để trong file private, không chép lên bài viết. Các lệnh dưới đây chạy công cụ của LingoLive, không phải test runner dùng nguyên xi cho mọi voice app. Live test có dùng provider nên cần bật opt-in và giới hạn thời gian/ngân sách.
$env:VOICE_QA_ALLOW_PAID='1'
$env:VOICE_QA_DURATION_SECONDS='180'
$env:VOICE_QA_FIXTURE='D:/private/qa-account-fixture.json'
node scripts/voice-qa/soak.cjs

# Sau khi smoke hợp lệ, chạy buổi dài
$env:VOICE_QA_DURATION_SECONDS='900'
node scripts/voice-qa/soak.cjs
Đọc file kết quả kể cả khi process exit 0. Audio response phải là telemetry/audio thực, không phải một frame điều khiển; kiểm tra người dùng đăng nhập đúng account trước khi mở phiên trả phí. Sau test, kết thúc client, xác nhận mic/server session dừng, xóa Auth/Firestore/Storage của account thử và token trên từng máy đã nhận. Chỉ giữ aggregate và failure classification công khai.
Tiêu chí phát hành cần đi cùng bằng chứng
Tôi đề xuất mục tiêu ban đầu cho LingoLive: response gap median không quá 1,5 giây và p95 không quá 3 giây trên ít nhất 100 lượt tương đương, cùng các tiêu chí cho timeout, khôi phục kết nối, microphone và chất lượng coaching. Đây là mục tiêu sản phẩm cần kiểm chứng qua pilot, không phải cam kết của Pipecat hoặc Google. Ba lần kết nối thành công không chứng minh độ tin cậy 99%.
Bộ tài liệu trong repo hiện có định nghĩa metric, ma trận tình huống, quy trình kiểm tra thiết bị thật, harness có opt-in chi phí và mẫu báo cáo cho dev hoặc agent dùng lại. Các kết quả được đánh dấu đạt, không đạt, chưa thử hoặc chưa đủ kết luận. Không có trạng thái nào được đổi thành “đạt” chỉ vì thiếu dữ liệu.
Hiện tôi giữ WebSocket làm mặc định và WebRTC là tùy chọn. Phần loa/tai nghe trên điện thoại thật, echo trong phòng thật và phát âm của trẻ thật vẫn cần kiểm tra tiếp. Mục tiêu của tôi là biết chính xác sản phẩm giúp được gì, lỗi nằm ở đâu và cần cải thiện gì trước khi mở rộng.
Bạn có thể xem LingoLive hoặc đọc bộ phương pháp kiểm thử dành cho dev và agent. Nếu đang làm voice AI cho học tập hoặc nghiệp vụ, hãy bắt đầu bằng một tình huống cụ thể và một định nghĩa phép đo rõ ràng; việc chọn model sẽ dễ hơn khi biết điều gì cần đạt.
Bài viết liên quan
· 8 phút đọc
dich-giong-noi
Dịch giọng nói realtime với Gemini Live và LiveKit: những gì bài hướng dẫn bỏ qua
Tôi dựng lại bài hướng dẫn dịch realtime bằng Gemini Live của Google thành một sản phẩm có thể tự chạy cho khoảng 100 người nghe thường xuyên. Bài này nói về những gì bản demo làm đúng, bảy lỗ hổng phải vá, chi phí và kết quả đo được.
Đọc tiếp
· 25 phút đọc
ai
Qwen Voice AI: Hướng Dẫn Toàn Diện Xây Dựng Interview Agent, Language Tutor & Voice System
Tất tần tật về hệ sinh thái voice của Qwen — Qwen3-TTS, Qwen3-ASR, Qwen3-Omni, Qwen-Agent — và hướng dẫn từng bước xây dựng Voice Interview Agent, Language Tutor, Voice Tutor với code production-ready.
Đọc tiếp
· 20 phút đọc
ai-agent
Pipecat Voice Agent trên Production: Hướng Dẫn Toàn Diện về Issues, Tối Ưu & Kiến Trúc Scalable
Phân tích 26+ lỗi production thực tế của Pipecat voice agent — latency, audio quality, memory leak, VAD, pipeline freeze — cùng các chiến lược tối ưu đã được kiểm chứng cho hệ thống voice AI có thể scale.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.