
BÀI VIẾT
Phần 1/6: Kiến trúc workflow với AI agent và chọn model theo vai
Vòng lặp 7 bước với hai cổng duyệt của con người, mức rủi ro quyết định agent được tự chủ đến đâu, chọn model theo vai (Claude Opus 5.5, Sonnet 5.5, Haiku 5.5, Codex gpt-6.1-sol) và cách tự đánh giá model bằng 20 task của chính bạn, trên repo mẫu agentic-shortlink.
Trong bài viết
Muốn xem kỹ hơn? Bản đầy đủ 21 phút đi trọn một feature qua cả vòng lặp, còn playlist có thêm bản dọc cho điện thoại.
Phần lớn mọi người bắt đầu với AI coding agent theo cùng một cách: mở Claude Code hoặc Codex, mô tả một tính năng, xem agent viết code, thấy ổn thì merge. Với một script nhỏ thì cách này chạy được. Với một dự án thật, có team, có người dùng và có CI, nó bắt đầu đổ vỡ chỉ sau vài tuần. Lý do không phải là agent lúc nào cũng viết code tệ, mà là không ai còn dám chắc thay đổi nào trong số agent tạo ra là đúng.
Series này giải quyết đúng vấn đề đó. Qua sáu phần, mình sẽ dựng một workflow lặp lại được và kiểm soát được để làm phần mềm cùng agent, trên một repo mẫu nhỏ mà bạn có thể clone về và chạy ngay. Phần 1 là tấm bản đồ: vòng lặp mà mọi thay đổi phải đi qua, ai làm gì ở từng bước, mức rủi ro quyết định agent được tự chủ đến đâu, và nên đặt model nào vào vai nào. Các phần sau sẽ biến từng ô trên bản đồ thành file, script và CI job cụ thể.
Cuối bài bạn sẽ có
- Một vòng lặp 7 bước (Spec, Plan, Execute, Verify, Review, Merge, Learn) với hai cổng duyệt của con người, và với mỗi bước: ai thực hiện, sản phẩm đầu ra là gì, điều kiện nào khép lại bước đó.
- Một quy tắc về mức tự chủ của agent, gắn với mức rủi ro của thay đổi và được ghi rõ trong
AGENTS.md. - Một phương án chọn model theo vai với model id cụ thể cho tháng 11/2026, cùng quy trình 20 task để tự kiểm chứng trên công việc của bạn thay vì tin vào leaderboard.
- Hình dung rõ cách Claude Code và Codex được cấu hình song song trong cùng một repo.
- Repo mẫu
agentic-shortlinkđã clone về máy,pnpm checkchạy qua.
Chuẩn bị
- Git và Node 22 trở lên (repo ghim
22trong.nvmrc).corepackđi kèm Node và sẽ cung cấp đúng phiên bản pnpm đã ghim. - Đã cài Claude Code hoặc Codex thì tốt, nhưng phần này chưa bắt buộc. Cách cài và cấu hình repo nằm ở Phần 2.
- Đây là phần đầu tiên của series. Các nguyên tắc nền tảng nằm trong bài viết trước về tốc độ và kiểm soát khi làm việc với agent. Đọc bài đó trước sẽ dễ theo hơn, nhưng không bắt buộc.
Vì sao “cứ prompt cho agent” không trụ được ở dự án thật
Một agent có thể tạo ra một pull request chạy được chỉ trong vài phút. Nhưng để review kỹ pull request đó, con người vẫn mất ngần ấy thời gian như trước khi có agent, đôi khi còn lâu hơn, vì bạn không phải người viết và không nhớ vì sao code lại có hình dạng như vậy. Khi chạy song song hai ba agent, lượng code sinh ra tăng nhanh hơn hẳn khả năng review của bạn. Đó là chỗ vỡ đầu tiên.
Chỗ vỡ thứ hai là ý định. Một prompt một dòng như “thêm tính năng link hết hạn” để ngỏ hàng chục quyết định: link hết hạn trả status code gì, click vào link đã hết hạn có được đếm không, các link tạo trước thay đổi này thì sao. Agent sẽ tự chọn một đáp án cho từng câu. Có lựa chọn hợp lý, có lựa chọn không, và bạn chỉ biết cái nào sai khi người dùng gặp phải.
Trong công việc của mình, quy luật này lặp lại rất đều: khi agent đã viết phần lớn code, phần việc chậm và có giá trị nhất dịch chuyển về hai đầu của quy trình. Ở đầu vào là đặc tả chính xác thế nào là “xong”. Ở đầu ra là kiểm chứng rằng nó thật sự xong, bằng bằng chứng chứ không bằng cảm giác. Bài viết trước đã phân tích kỹ lập luận này. Series này là phiên bản thực hành: mỗi nguyên tắc trở thành một file trong repo.
Vì vậy kiến trúc cần dựng không phải là “một agent thật giỏi”, mà là một vòng lặp trong đó:
- con người quyết định làm gì và duyệt cách làm,
- agent đảm nhận phần lớn việc gõ code, trong những ranh giới mà nó không thể bước ra ngoài,
- máy kiểm tra những gì máy kiểm tra được (lint, type, test),
- ý kiến thứ hai và thứ ba kiểm tra những gì test không bắt được,
- và con người ký duyệt dựa trên bằng chứng, không dựa trên cảm tính.
Vòng lặp: bảy bước, hai cổng duyệt của con người
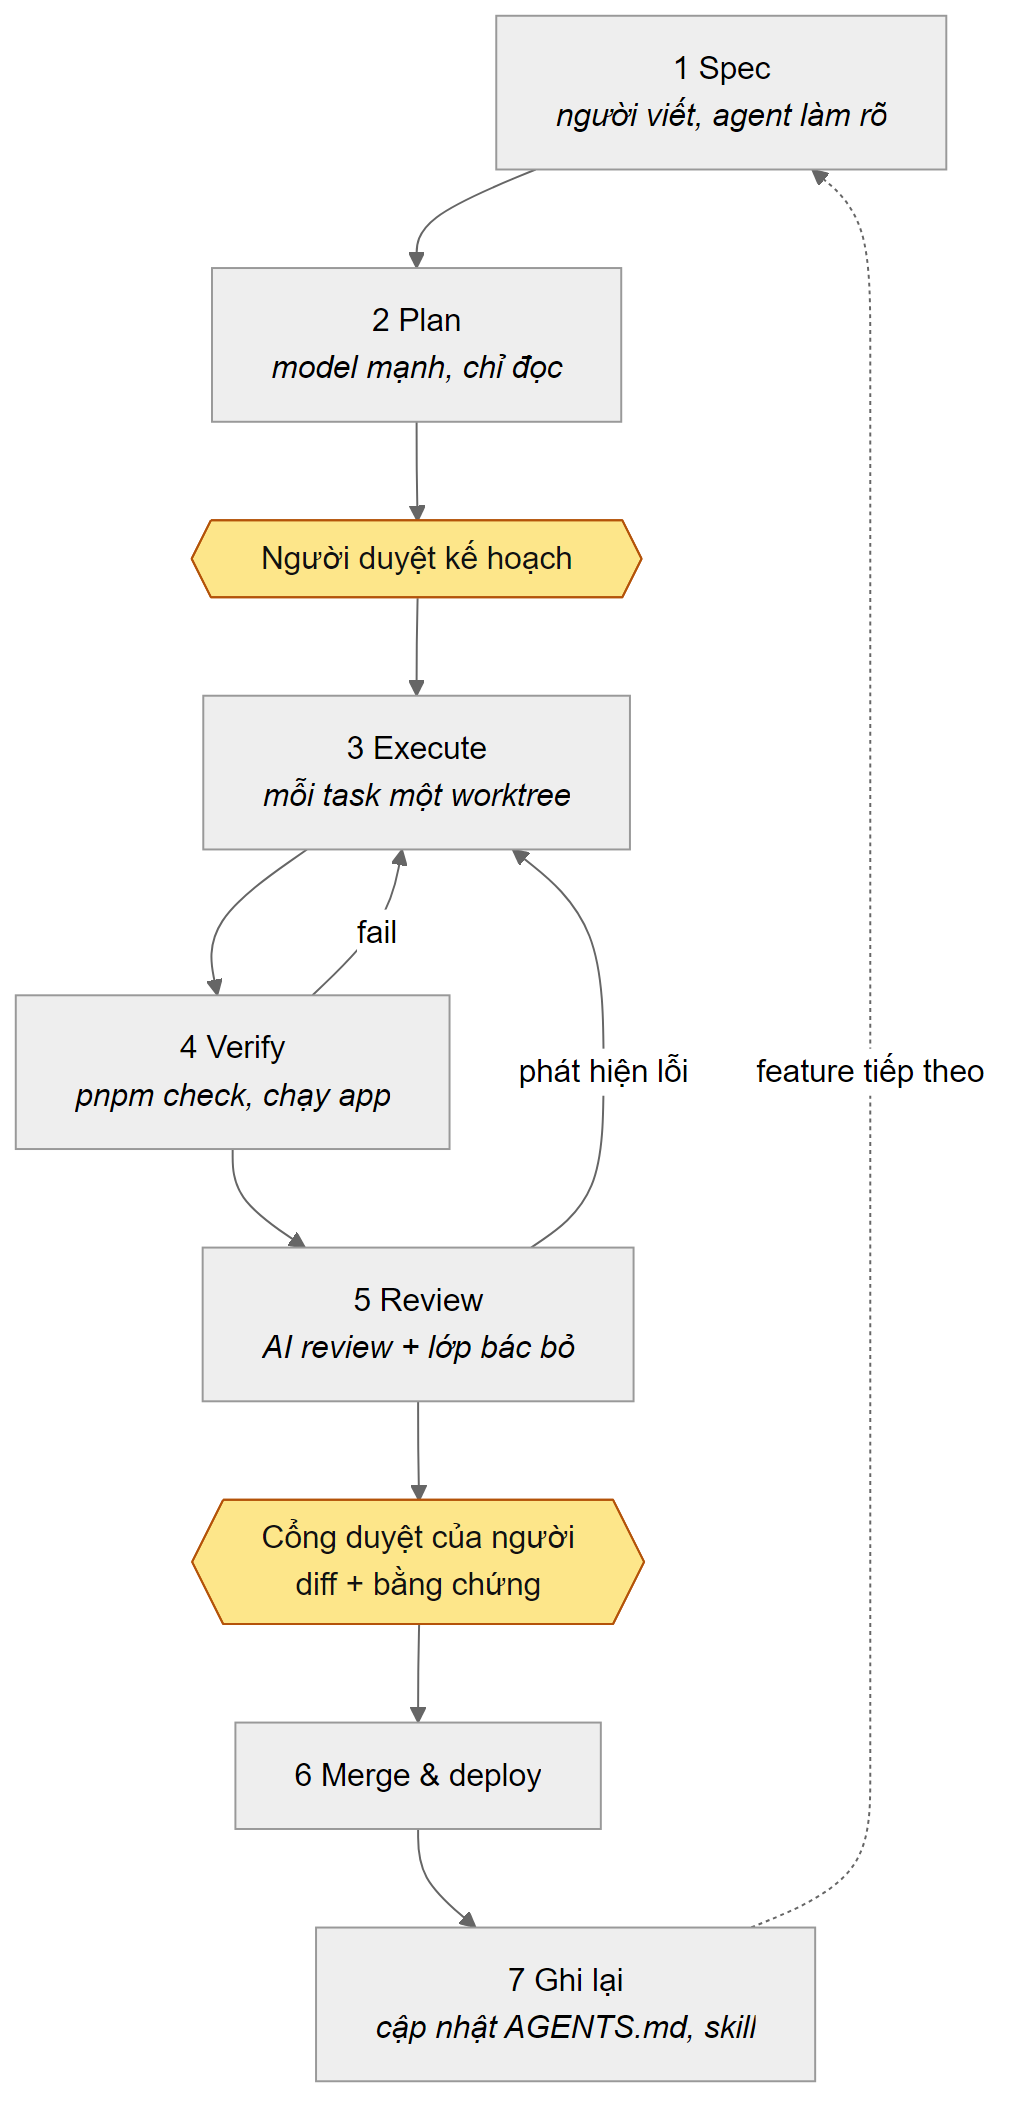
Mọi thay đổi trong repo mẫu đều đi qua cùng một vòng lặp. Thay đổi nhỏ đi qua nhanh, có bước chỉ còn là một lệnh, nhưng không bước nào bị bỏ qua mà không ai hay. Dưới đây là ý nghĩa thực tế của từng bước.
1. Spec
Ai làm: con người viết, agent chuốt lại. Đầu vào: một ý tưởng tính năng. Đầu ra: một file docs/specs/NNNN-name.md dựng từ docs/specs/TEMPLATE.md, gồm vấn đề, phạm vi làm và không làm, bảng Behaviour với các cặp request/response cụ thể, phần Definition of done và phần Risk. Kết thúc khi: spec ở trạng thái approved và mọi dòng trong Definition of done đều kiểm tra được bằng máy hoặc bằng cách đọc một file.
Repo có sẵn skill new-spec làm phần chuốt này: đọc template và các spec gần nhất, đọc phần code mà tính năng sẽ chạm tới, hỏi tối đa năm câu, viết spec rồi dừng lại, không viết code. Phần 3 sẽ đi qua skill này chi tiết.
2. Plan, rồi đến cổng duyệt thứ nhất
Ai làm: một model mạnh ở chế độ chỉ đọc (plan mode trong Claude Code). Đầu vào: spec đã duyệt, AGENTS.md và các file mà spec nhắc tới. Đầu ra: docs/tasks/NNNN-name.md, một bảng task với các cột # | Task | Files | Check | Depends on, kèm ghi chú task nào chạy song song được. Kết thúc khi: con người đọc bảng và duyệt.
Cổng duyệt này rẻ mà hiệu quả rất cao. Đọc một bảng năm dòng mất vài phút. Đọc 400 dòng diff sinh ra từ một plan sai thì lâu hơn nhiều, và đến lúc đó agent đã tiêu hết token rồi. Repo có một ví dụ thật từ spec 0001:
docs/tasks/0001-link-expiry.md
| # | Task | Files | Check | Depends on |
| --- | --- | --- | --- | --- |
| T1 | Add nullable `expires_at` column and map it in `LinkRepo` | `src/db.ts`, `src/repo.ts` | `pnpm typecheck` | none |
| T2 | Accept `expiresInDays` in `POST /api/links`, compute `expiresAt` from the injected clock | `src/app.ts` | `pnpm vitest run test/expiry.test.ts -t "sets expiresAt"` | T1 |
| T3 | Add `isExpired`; return 410 on redirect and `expired` in stats; do not count clicks | `src/app.ts` | `pnpm vitest run test/expiry.test.ts` | T2 |
| T4 | Update README API section | `README.md` | review | T3 |
| T5 | Full gate | none | `pnpm check` | T1-T4 |

Parallelism: T1-T3 touch the same files, so they run in sequence in one worktree. T4 can run in parallel once T3's response shape is fixed.
Để ý rằng task nào cũng có lệnh Check riêng. Chính cột này giúp agent biết khi nào mình đã xong mà không cần hỏi bạn.
3. Execute
Ai làm: một agent thực thi, thường là model tầm trung. Đầu vào: một task (hoặc vài task dùng chung file). Đầu ra: các commit trên một branch nằm trong git worktree riêng. Kết thúc khi: lệnh Check của task chạy xanh.
Worktree ở đây rất quan trọng. Mỗi task có một bản checkout riêng trên branch riêng, nên hai agent không bao giờ sửa chung một thư mục làm việc, và một lần thử hỏng có thể bỏ đi chỉ bằng một lệnh. Script scripts/agent-task.sh trong repo tạo .worktrees/<name> trên branch agent/<name>, chạy Claude Code hoặc Codex ở chế độ headless bên trong, rồi ghi bản tóm tắt vào agent-runs/<name>/. Không có gì được push. Phần 4 sẽ nói kỹ về script này.
4. Verify
Ai làm: máy trước, agent sau. Đầu vào: branch vừa làm. Đầu ra: pnpm check chạy qua (lint, typecheck, test) và, với thay đổi ở route, một test chạy thử một dòng Behaviour qua app. Kết thúc khi: toàn bộ cổng kiểm tra xanh. Nếu đỏ, vòng lặp quay về Execute.
Bước kiểm chứng được thiết kế để nhàm chán. Agent phải chạy đúng lệnh mà con người sẽ chạy, và báo lại lệnh nào chứng minh điều gì. AGENTS.md yêu cầu mọi agent kết thúc bằng một bản tóm tắt ba phần: đã làm và đã kiểm chứng (kèm lệnh), đã làm nhưng chưa kiểm chứng, và phần bỏ qua. Định dạng này làm lộ rõ những lúc “xong” thật ra chỉ có nghĩa là “chắc là xong”.
5. Review, rồi đến cổng duyệt thứ hai
Ai làm: một hoặc hai AI reviewer, sau đó là một agent phản biện (refuter). Đầu vào: diff so với main và spec. Đầu ra: một danh sách ngắn các finding, mỗi finding kèm một kịch bản lỗi cụ thể (đầu vào nào dẫn tới đầu ra sai). Kết thúc khi: mọi finding đã xác nhận đều được sửa hoặc được chấp nhận rõ ràng, và con người đã xem diff cùng với bằng chứng.
Bước phản biện là bước hay bị bỏ qua nhất, và cũng là bước giữ cho review còn hữu ích. AI reviewer có sinh ra false positive. Nếu đẩy hết chúng về cho agent thực thi, nó sẽ đi “sửa” cả những đoạn code vốn đúng. Subagent refuter trong repo nhận danh sách finding và tìm cách chứng minh từng finding là sai, bằng cách đọc code và khi cần thì viết một test tạm. Chỉ những finding đứng vững mới quay về bước Execute.
Cổng duyệt của con người ở đây không có nghĩa là đọc lại từng dòng. Việc cần làm là đọc bảng Behaviour của spec, đọc bằng chứng (lệnh nào đã chạy qua, finding nào còn đứng vững), rồi dồn sự chú ý vào những phần mà bằng chứng chưa phủ tới.
6. Merge và deploy
Ai làm: con người bấm merge, CI lo phần còn lại. Đầu vào: một pull request đã được duyệt. Đầu ra: một commit trên main và những gì pipeline deploy của bạn làm với nó. Kết thúc khi: CI trên main xanh. Trong repo mẫu, .github/workflows/ci.yml chạy install, lint, typecheck, test và build cho mọi pull request và mọi lần push lên main.
7. Learn
Ai làm: con người, thường có agent soạn nháp. Đầu vào: những gì đã sai hoặc đã chậm trong vòng này. Đầu ra: một chỉnh sửa nhỏ trong AGENTS.md, một skill, một hook hoặc template spec. Kết thúc khi: bài học đã nằm trong một file mà lần chạy agent tiếp theo sẽ đọc.
Đây là bước giúp cả hệ thống tốt lên theo thời gian. Nếu reviewer cứ liên tục bắt gặp Date.now() trong route handler, bạn không ngồi sửa tay mãi; bạn thêm một dòng vào phần Code rules của AGENTS.md và một quy tắc mức high vào Code Review Rules. Phần 6 nói về việc thực hiện bước này một cách có chủ đích.
Toàn bộ vòng lặp trong một bảng
| Step | Who | Artifact | Gate |
|---|---|---|---|
| 1 Spec | Human writes, agent sharpens (new-spec) | docs/specs/NNNN-name.md | Status approved; every Definition of done line is checkable |
| 2 Plan | Strong model, read-only (plan mode) | docs/tasks/NNNN-name.md | Human approves the task table |
| 3 Execute | Executor agent in a worktree | Commits on agent/<name> | Task’s Check command passes |
| 4 Verify | CI commands, run by the agent | pnpm check output, summary | Full gate green, else back to Execute |
| 5 Review | AI reviewer(s) + refuter | Confirmed findings list | Human approves diff + evidence |
| 6 Merge | Human merges, CI runs | Commit on main | CI green on main |
| 7 Learn | Human, agent drafts | Edit to AGENTS.md, skill or hook | Lesson is in a file the next run reads |
Kiểm tra: sau khi clone repo (xem phần giới thiệu repo bên dưới), xác nhận các file spec và task đã có.
$ ls docs/specs docs/tasks
docs/specs:
0001-link-expiry.md
0002-daily-click-stats.md
TEMPLATE.md

docs/tasks:
0001-link-expiry.md
Spec 0001 đã đi trọn vòng lặp. Spec 0002 đã được duyệt nhưng chưa có file task: đó là bài tập xuyên suốt Phần 3 đến Phần 5.
Mức rủi ro quyết định agent được tự chủ đến đâu
Chạy đủ vòng lặp với hai reviewer chỉ để sửa một lỗi chính tả là lãng phí. Để agent merge một thay đổi schema chỉ dựa trên CI xanh thì liều lĩnh. Lời giải là phân loại thay đổi theo mức rủi ro, rồi để mức rủi ro quyết định cổng duyệt nào được áp dụng. Mình dùng ba mức:
- Low: dễ hoàn tác, không ảnh hưởng tới người dùng hay dữ liệu. Test, tài liệu, các hàm tiện ích thuần. Máy tự quyết được.
- Medium: thay đổi hành vi mà người dùng nhìn thấy, nhưng revert commit là trở lại như cũ. Route, truy vấn, validation. Máy, cộng một lượt AI review, cộng một người duyệt.
- High: khó hoàn tác hoặc ảnh hưởng tới độ tin cậy. Database schema, xác thực, CI workflow, dependency. Tất cả những gì ở trên, cộng thêm một AI reviewer thứ hai thuộc họ model khác.
Điều quan trọng là quy tắc này phải được viết ra ở nơi mọi agent đều đọc, chứ không nằm trong đầu ai đó. Trong repo mẫu, nó là phần cuối cùng của AGENTS.md:
AGENTS.md
## Review levels

| Change | Required before merge |
| --- | --- |
| Tests, docs, `src/lib/` helpers | CI green |
| Routes, repo, validation | CI green + AI review + one human approval |
| Schema, auth, workflows, dependencies | CI green + AI review from two model families + human approval |
Ba dòng của bảng tương ứng với ba mức rủi ro. Bảng này cũng được nối vào phần còn lại của quy trình. Template spec có phần Risk với câu hỏi “Reversible? Data migration? Public contract change? Pick the review level from AGENTS.md.” Skill new-spec yêu cầu agent nêu rõ mức review nào áp dụng. Phần Safety của AGENTS.md giữ agent tránh xa các file rủi ro cao trừ khi task nói về chúng: “Never edit .github/workflows/ or AGENTS.md itself unless the task is about them.” Trong .claude/settings.json, chính các file này nằm trong danh sách ask (Edit(.github/**), Edit(AGENTS.md)), nên Claude Code vẫn phải hỏi trước khi sửa, kể cả khi agent quên mất chỉ dẫn.
Mức rủi ro cũng quyết định agent được chạy một mình bao lâu. Với task rủi ro thấp, mình để agent thực thi chạy headless tới cuối. Với rủi ro trung bình, cổng duyệt plan là bắt buộc. Với rủi ro cao, mình giữ agent ở plan mode cho tới khi con người đọc xong plan, và thay đổi phải qua bước review chéo giữa hai họ model được mô tả ở phần tiếp theo.
Kiểm tra: bảng review levels nằm trong file mà agent của bạn đọc.
$ grep -A6 "## Review levels" AGENTS.md
## Review levels

| Change | Required before merge |
| --- | --- |
| Tests, docs, `src/lib/` helpers | CI green |
| Routes, repo, validation | CI green + AI review + one human approval |
| Schema, auth, workflows, dependencies | CI green + AI review from two model families + human approval |
Chọn model theo vai
Khi vòng lặp đã rõ, việc chọn model trở nên dễ hơn, vì câu hỏi không còn là “model nào tốt nhất?” mà là “model nào tốt nhất cho vai này?”. Mỗi vai có nhu cầu khác nhau. Planner cần óc phán đoán và cái nhìn bao quát codebase; nó chạy ít lần, nên một model chậm và đắt vẫn chấp nhận được. Executor chạy nhiều lần mỗi ngày, cần ổn định và chi phí vừa phải. Reviewer cần giỏi tìm vấn đề và, lý tưởng nhất, khác với model đã viết ra code.
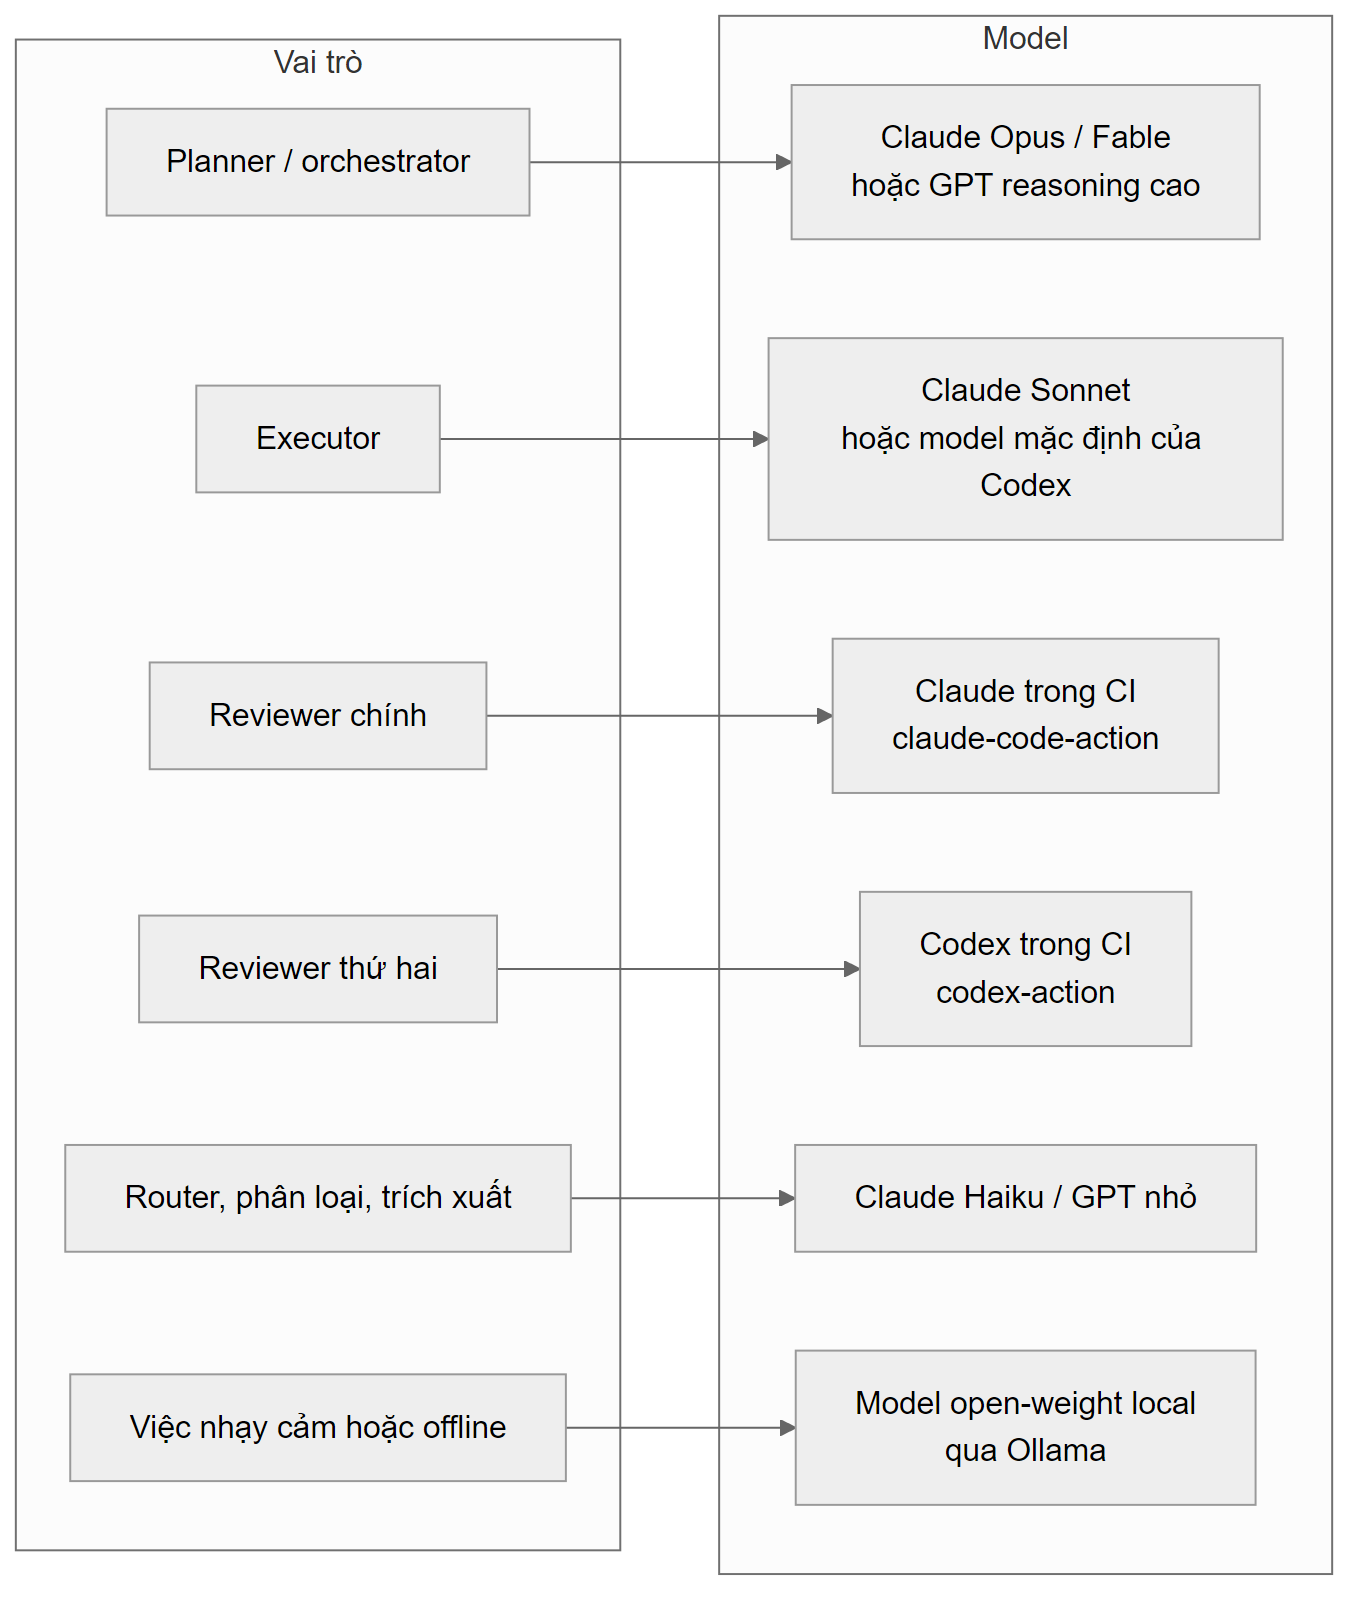
Dưới đây là các vai cùng model id cụ thể mà mình dùng trong tháng 11/2026, và vị trí của từng vai trong repo mẫu.
| Role | Needs | Models (Nov 2026) | Where in the repo |
|---|---|---|---|
| Planner / orchestrator | Judgement, reads a lot, runs rarely | Claude Opus 5.5 (claude-opus-5-5), Claude Fable 5.2 (claude-fable-5-2) for the hardest work, or gpt-6.1-sol with high reasoning effort | Plan mode in Claude Code; examples/codex/deep-review.config.toml (effort high) |
| Executor | Reliable edits, many runs, cost matters | Claude Sonnet 5.5 (claude-sonnet-5-5) or the Codex default model | scripts/agent-task.sh (--model sonnet); .codex/config.toml (gpt-6.1-sol, effort medium) |
| Primary reviewer | Finds real bugs, follows review rules | Claude Opus 5.5 | .claude/agents/reviewer.md (model: opus); ai-review-claude.yml (--model claude-opus-5-5) |
| Second-opinion reviewer | A different model family | gpt-6.1-sol through Codex | ai-review-codex.yml; scripts/cross-review.sh |
| Router / triage / extraction | Fast and cheap, short inputs | Claude Haiku 5.5 (claude-haiku-5-5) or a small GPT model | gateway/litellm.config.yaml |
| Sensitive or offline work | Data never leaves the machine | A local open-weight model via Ollama | local-coder in gateway/litellm.config.yaml; codex --oss |
Vài ghi chú về bảng trên:
claude-opus-5-5là model mặc định của Claude Code. Các aliasopus,sonnet,haikuvàfabledùng được trong--modelvà trong frontmatter của subagent, vì vậy agent và script trong repo dùng tên ngắn.- Tài liệu Codex liệt kê
gpt-6.1-sol,gpt-6.1-terra,gpt-6-astravàgpt-6-luna;gpt-6.1-sollà model dùng trong ví dụ của tài liệu và trong repo này. Codex đặt mức reasoning riêng quamodel_reasoning_effort, nên cùng một model có thể đóng vai executor ở mứcmediumvà vai planner ở mứchigh. - Subagent
refuterchạy bằngsonnet. Tìm cách bác bỏ một finding cụ thể là việc hẹp hơn nhiều so với tìm lỗi trong cả một diff, nên model tầm trung là đủ. - Với model local, Codex hướng dẫn dùng
codex --ossvới Ollama và khuyến nghị context window từ 64k trở lên. File cấu hình gateway trong repo trỏ tênlocal-codertớiollama_chat/qwen3-coder; Phần 4 sẽ dựng gateway này.
Vì sao reviewer thứ hai nên thuộc họ model khác
Khi một model vừa lập plan, vừa viết code, vừa tự review, các điểm mù của nó trùng khớp với nhau. Nếu nó hiểu sai spec lúc lập plan, nó sẽ hiểu sai y như vậy lúc review, và thấy code hoàn toàn nhất quán với cách hiểu sai của chính mình. Hỏi lại cùng model đó với một prompt khác cũng không giúp được bao nhiêu, vì thói quen bên dưới vẫn là một.
Một model thuộc họ khác (trong repo này là Claude và GPT) được huấn luyện theo cách khác và thường sai ở những chỗ khác. Chỗ một reviewer bỏ sót điều kiện biên, reviewer kia thường bắt được. Khi cả hai cùng nêu một finding, bạn có thêm cơ sở để tin đó là lỗi thật. Khi hai bên bất đồng, bước phản biện sẽ phân xử. Đó chính là việc scripts/cross-review.sh làm: Codex review trong sandbox chỉ đọc, Claude Opus review ở plan mode, rồi một lượt chạy thứ ba tìm cách bác bỏ mọi finding của cả hai và chỉ giữ lại những gì đứng vững, có ghi rõ model nào đã nêu ra.
Cách này tốn kém hơn một lượt review đơn, nên repo chỉ bắt buộc nó cho dòng rủi ro cao trong bảng Review levels. Với thay đổi rủi ro trung bình, một reviewer tốt cộng với refuter thường là đủ.
Leaderboard không thống nhất. Hãy tự chạy bộ đánh giá 20 task trên công việc của bạn.
Nói thẳng: tháng 11/2026, các leaderboard lập trình công khai không thống nhất với nhau về model nào giỏi nhất, và thứ hạng thay đổi sau vài tuần. Chúng cũng đo trên những task không phải của bạn, trong những repo không phải của bạn, không có quy tắc review của bạn. Mình đã thôi chọn model dựa vào leaderboard.
Cách hiệu quả hơn là một bộ đánh giá nhỏ của riêng bạn. Dựng nó mất một buổi chiều, và con số thu được áp dụng đúng cho codebase của bạn:
- Chọn 20 task đã đóng từ lịch sử của chính bạn: các pull request đã merge hoặc ticket đã đóng mà một lượt chạy agent có thể làm được. Trộn nhiều loại: vài bug fix, vài tính năng nhỏ, một hai lần refactor, vài task chỉ đụng tới test.
- Viết definition of done cho từng task, theo đúng phong cách của template spec: điều gì phải đúng, kiểm tra được bằng một lệnh hoặc bằng cách đọc một file. Thường đó là “các test này chạy qua” cộng thêm một hai hành vi cụ thể.
- Bắt đầu mỗi lượt chạy từ commit ngay trước bản sửa thật, để model nào cũng xuất phát từ cùng một điểm. Mỗi task và mỗi model một git worktree riêng sẽ giữ chúng tách biệt.
- Chạy hai hoặc ba model ứng viên trên cả 20 task với cùng một prompt. Phần 4 cung cấp
scripts/agent-task.sh, script này đã chạy được một task headless với Claude Code hoặc Codex, ghi bản tóm tắt và kết quảpnpm check, và (với Claude) ghi lại chi phí. - Chấm mỗi lượt chạy theo ba tiêu chí: pass hay fail so với definition of done; số phút bạn cần để review kết quả cho tới khi sẵn sàng merge; chi phí tính bằng USD.
- Quyết định theo vai. Executor tốt nhất là model rẻ nhất mà vẫn pass phần lớn task với số phút review thấp. Reviewer tốt nhất là model tìm ra được lỗi thật ở các lượt chạy hỏng mà không nhấn chìm bạn trong false positive.
Một bảng tính đơn giản với các cột sau là đủ:
| Task | Model | Pass | Review minutes | Cost USD | Notes |
|---|---|---|---|---|---|
| T01 fix 404 on trailing slash | claude-sonnet-5-5 | pass / fail | … | … | … |
| T01 fix 404 on trailing slash | gpt-6.1-sol | pass / fail | … | … | … |
Số phút review là cột mà nhiều người bỏ qua nhất, và theo kinh nghiệm của mình lại là cột quan trọng nhất. Một model pass nhiều task hơn một chút nhưng tạo ra diff mất gấp đôi thời gian để đọc thì không hề rẻ hơn. Hãy chạy lại bộ đánh giá mỗi khi có model mới; khi script đã sẵn, phần lớn thời gian chỉ là chờ.
Kiểm tra: xem mỗi vai agent trong repo mẫu đang dùng model nào.
$ grep -n "^model" .claude/agents/*.md .codex/config.toml
.claude/agents/refuter.md:5:model: sonnet
.claude/agents/reviewer.md:5:model: opus
.codex/config.toml:5:model = "gpt-6.1-sol"
.codex/config.toml:6:model_reasoning_effort = "medium"
Claude Code và Codex trong cùng một repo
Repo mẫu được cấu hình cho cả Claude Code lẫn Codex. Đây không phải là cách đặt cược hai cửa. Mỗi công cụ làm tốt những việc khác nhau, và có cả hai thì bạn có sẵn review chéo giữa hai họ model. Quyết định thiết kế cốt lõi là các quy tắc dùng chung nằm ở một chỗ duy nhất, AGENTS.md, còn cấu hình riêng của từng công cụ chỉ chứa những gì đặc thù cho công cụ đó.
Codex đọc thẳng AGENTS.md. Claude Code đọc CLAUDE.md, và vì nó chỉ tự đọc AGENTS.md khi không có CLAUDE.md, file CLAUDE.md của repo mở đầu bằng việc import AGENTS.md:
CLAUDE.md
@AGENTS.md

## Claude Code

- For any feature, use the `implement-spec` skill. For a new idea without a spec, use `new-spec` first.
- Start non-trivial work in plan mode (Shift+Tab twice) and wait for approval of the task table.
- Before saying done, run the `reviewer` subagent on your diff, then the `refuter` subagent on its findings. Fix what survives.
- Hooks in `.claude/settings.json` format every edited file and block `git push`, `git add -A` and `rm -rf`. If a hook blocks you, do not work around it; tell the human.
- Personal overrides go in `CLAUDE.local.md` (git-ignored).
Cấu hình project của Codex thì ngắn gọn:
.codex/config.toml
# Project config for Codex CLI. Applies only when this project is trusted.
# Provider settings (model_provider, model_providers, profiles) are not allowed here;
# put them in ~/.codex/config.toml or a profile file. See examples/codex/.

model = "gpt-6.1-sol"
model_reasoning_effort = "medium"
approval_policy = "on-request"
sandbox_mode = "workspace-write"

[sandbox_workspace_write]
network_access = false
Dưới đây là so sánh hai công cụ theo đúng cách chúng được cấu hình trong repo này:
| Aspect | Claude Code | Codex |
|---|---|---|
| Instruction file | CLAUDE.md, which starts with @AGENTS.md; personal notes in CLAUDE.local.md | AGENTS.md directly (global ~/.codex/AGENTS.md, then git root down to cwd; 32 KiB default cap) |
| Config file | .claude/settings.json (committed), .claude/settings.local.json (personal) | .codex/config.toml (trusted projects only), ~/.codex/config.toml, profile files like ~/.codex/deep-review.config.toml |
| Model in this repo | claude-opus-5-5 by default; sonnet for execution, opus for review | gpt-6.1-sol, model_reasoning_effort = "medium" |
| Sandbox / permissions | Permission rules allow / ask / deny (deny checked first), plus PreToolUse and PostToolUse hooks | sandbox_mode (read-only, workspace-write, danger-full-access), approval_policy, network_access = false |
| Guardrails in this repo | guard-bash.mjs blocks git push, git add -A, rm -rf; format-file.mjs formats every edit | Workspace-write sandbox without network; rules in AGENTS.md |
| Reusable workflows | Skills new-spec, implement-spec; subagents reviewer, refuter | Profiles, e.g. deep-review (effort high, read-only) |
| Headless command | claude -p "<prompt>" with --model, --permission-mode, --allowedTools, --max-turns, --max-budget-usd, --output-format json | codex exec "<prompt>" with --sandbox workspace-write, --json, -o |
| CI action | anthropics/claude-code-action pinned to v1.0.270 | openai/codex-action pinned to v1.13, permission-profile: ":read-only" |
| Review trigger | ai-review-claude.yml on every non-draft pull request; @claude comment via claude-mention.yml | ai-review-codex.yml on every non-draft pull request; @codex review comment via Codex cloud |
| Review rules source | “Code Review Rules” section of AGENTS.md, named in the prompt | ## Code Review Rules section of the nearest AGENTS.md |
Hai công cụ kiểm soát agent theo hai cách khác nhau, và nhìn chúng như vậy sẽ dễ hiểu hơn. Claude Code kiểm soát chủ yếu ở cấp tool: mỗi lần gọi tool được so với các permission rule, và hook có thể kiểm tra hoặc chặn lại. Codex kiểm soát chủ yếu ở cấp môi trường: tiến trình chạy trong một sandbox giới hạn những gì nó được ghi và việc nó có được ra mạng hay không. Cả hai đều có ích. Trong repo này, Claude Code là công cụ tương tác chính để lập plan và triển khai, với skill và subagent của nó. Codex là họ model thứ hai cho bước review, đồng thời là executor thứ hai khi chạy task song song.
Lưu ý: cả hai công cụ đều bỏ qua cấu hình project cho tới khi bạn trust project đó. Codex chỉ áp dụng .codex/config.toml cho project đã trust. Claude Code đã bỏ qua toàn bộ .claude/settings.json, cả permission lẫn hook, cho tới khi mình chấp nhận hộp thoại trust; trước đó, một lệnh thử git add -A vẫn chạy qua. Phần 2 sẽ hướng dẫn cách cấu hình và kiểm thử việc này.
Giới thiệu repo mẫu
Repo mẫu là agentic-shortlink, một API rút gọn URL nhỏ: Node 22, TypeScript (strict, ESM), Hono, SQLite qua better-sqlite3, zod cho validation, Vitest cho test và Biome cho lint và format.
Ứng dụng làm gì
Toàn bộ API gói gọn trong một bảng, lấy từ README:
| Method | Path | Notes |
|---|---|---|
POST | /api/links | body { url, slug?, expiresInDays? } -> 201, 400, 409 |
GET | /:slug | 302 to the URL; 404 unknown; 410 expired (spec 0001) |
GET | /api/links/:slug | stats: clicks, expiresAt, expired |
DELETE | /api/links/:slug | header x-api-key: $ADMIN_API_KEY -> 204 |
GET | /health | { "status": "ok" } |
Bản đồ thư mục
AGENTS.md cung cấp cho mọi agent cùng một bản đồ code:
AGENTS.md
src/app.ts        routes; all dependencies injected through createApp()
src/repo.ts       LinkRepo, the only module that runs SQL
src/db.ts         schema, created in openDb()
src/lib/          pure helpers with their own unit tests
test/             Vitest; test/helpers.ts gives makeApp() with an in-memory DB and a fake clock
docs/specs/       one spec per feature (NNNN-name.md); the spec is the source of truth
docs/tasks/       task breakdown for a spec, written by the planner
Bao quanh ứng dụng là phần cấu hình cho agent, và đó mới là chủ đề thật sự của series:
| Path | Purpose | Series part |
|---|---|---|
AGENTS.md, CLAUDE.md | Shared instructions; Claude Code imports AGENTS.md | 2 |
.claude/settings.json, .claude/hooks/ | Permissions, guard hook, auto-format | 2 |
.claude/agents/ | reviewer and refuter subagents | 2, 4 |
.claude/skills/ | new-spec and implement-spec workflows | 3 |
.codex/config.toml, examples/codex/ | Codex project config, profiles, gateway provider | 2, 4 |
docs/specs/, docs/tasks/ | Spec template, spec 0001 (done), spec 0002 (exercise) | 3 |
scripts/agent-task.sh, scripts/cross-review.sh | Headless task in a worktree; two-family review | 4 |
gateway/litellm.config.yaml | One gateway for Anthropic, OpenAI, Gemini and local models | 4 |
.github/workflows/ | CI gate, Claude review, Codex review, @claude mentions | 5 |
Clone và chạy cổng kiểm tra
git clone https://github.com/luonghongthuan/agentic-shortlink
cd agentic-shortlink
corepack enable            # gives you the pinned pnpm
pnpm install
pnpm check                 # lint + typecheck + tests
pnpm check được định nghĩa trong package.json là pnpm lint && pnpm typecheck && pnpm test. Đây là lệnh duy nhất mà mọi agent phải chạy trước khi báo xong, và CI cũng chạy đúng các bước này.
Kiểm tra: phần cuối của output sẽ trông như sau (thời gian chạy sẽ khác).
$ pnpm check
...
 Test Files  2 passed (2)
      Tests  13 passed (13)
Trên máy mình, toàn bộ cổng kiểm tra (lint, typecheck và 13 test) chạy trong khoảng một giây; trên runner Ubuntu do GitHub cung cấp, CI job mất khoảng 24 giây. Nếu muốn thử API bằng tay, hãy copy .env.example thành .env, đặt ADMIN_API_KEY dài từ 8 ký tự trở lên rồi chạy pnpm dev.
Lưu ý: trên Windows với core.autocrlf=true, lint đã báo lỗi vì ký tự xuống dòng CRLF trong thư mục làm việc. Repo có sẵn .gitattributes với * text=auto eol=lf; nếu vẫn gặp lỗi xuống dòng, hãy chạy git config core.autocrlf false trong repo rồi checkout lại.
Vì sao ứng dụng được cố tình làm nhỏ
Năm route và một bảng dữ liệu là ứng dụng nhỏ một cách có chủ đích. Series này nói về workflow bao quanh code, và một ứng dụng nhỏ giúp workflow luôn hiện rõ. Bạn đọc hết src/ trong mười phút, nên khi agent mắc lỗi, bạn nhìn ra ngay. Cổng kiểm tra chạy trong khoảng một giây, nên bước Verify không bao giờ thành nút thắt. Và mỗi tính năng đủ nhỏ để một spec vừa một màn hình, nhờ đó dễ so sánh các model khác nhau xử lý cùng một spec ra sao.
Tuy nhỏ nhưng không tầm thường. Ứng dụng có đủ những thứ khiến review thật sự quan trọng: validation đầu vào, database, một route quản trị có API key, hành vi phụ thuộc thời gian (link hết hạn) và một hợp đồng response công khai. Đó cũng chính là những chỗ mà phần Code Review Rules trong AGENTS.md yêu cầu reviewer xem trước tiên.
Các phần tiếp theo sẽ dựng gì
- Phần 2, cấu hình repo: cài Claude Code và Codex, viết
AGENTS.mdvàCLAUDE.md, permission, hook, subagent và cấu hình Codex, rồi kiểm thử để chắc chắn chúng thật sự có hiệu lực. - Phần 3, spec, plan, task: dùng
new-specvàimplement-specđể biến spec 0002 thành một bảng task đã được duyệt. - Phần 4, chạy song song và nhiều provider: chạy task trong các worktree song song bằng
agent-task.sh, review bằngcross-review.sh, và đặt một LiteLLM gateway phía trước mọi model. - Phần 5, CI/CD với AI review: cổng CI, workflow review bằng Claude và Codex, lệnh
@claudetrong comment, và cách chạy chúng an toàn trên pull request. - Phần 6, vận hành: giới hạn chi phí, bảo mật, Dependabot cho các action đã ghim, và biến bước Learn thành thói quen.
Những lỗi hay gặp
Một model vừa lập plan, vừa viết, vừa tự review
Đây là cách làm phổ biến nhất và cũng yếu nhất. Bước review mang theo mọi hiểu lầm mà bước plan đã có. Tối thiểu, hãy review bằng một subagent riêng có prompt chỉ dành cho review và không có quyền sửa file (subagent reviewer của repo chỉ có Read, Grep, Glob, Bash và chỉ dẫn “You never edit files”), tiếp theo là một lượt phản biện, và với thay đổi rủi ro cao thì thêm một reviewer thuộc họ model khác.
Chọn model theo leaderboard
Leaderboard đo trên task của người khác và không tính thời gian review của bạn. Chúng cũng không thống nhất với nhau. Hai mươi task đã đóng của chính bạn, chấm theo pass/fail, số phút review và chi phí, sẽ nói lên nhiều hơn bất kỳ bảng xếp hạng công khai nào.
Bỏ qua cổng duyệt của con người với thay đổi rủi ro cao
CI xanh và một lượt AI review sạch sẽ tạo cảm giác như vậy là đủ. Với schema, xác thực, workflow và dependency thì chưa đủ, vì những thay đổi này khó hoàn tác và test thường không phủ được những gì có thể hỏng. Thay đổi cấu hình tự động là ví dụ điển hình: khi mình chạy biome migrate trên repo này, nó đã viết lại "recommended": true thành "preset": "none", âm thầm tắt toàn bộ lint rule. CI vẫn xanh, vì không còn rule nào để mà fail. Chỉ có đọc diff mới phát hiện ra.
Không có definition of done
Không có nó, agent tự quyết khi nào là xong, và thường là lạc quan. Mọi spec trong repo đều có phần Definition of done mà mỗi dòng kiểm tra được bằng máy hoặc bằng cách đọc một file, và mọi task đều có lệnh Check riêng. Nếu bạn không viết được dòng đó, spec chưa sẵn sàng.
Tin vào cấu hình chưa kiểm thử
Quy tắc nằm trong file chưa chắc đã có hiệu lực. Claude Code đã bỏ qua permission và hook của repo này cho tới khi workspace được trust. Hãy viết một phép thử nhỏ cho từng hàng rào bảo vệ (thử chạy git add -A và xem nó bị chặn) trước khi dựa vào nó. Phần 2 sẽ làm việc này từng bước.
Checklist
- Mình kể được 7 bước của vòng lặp và hai cổng duyệt của con người.
- Với mỗi bước, mình biết ai thực hiện, sản phẩm đầu ra là gì và điều gì khép lại bước đó.
- Repo của mình đã có bảng Review levels (hoặc mình biết sẽ đặt nó ở đâu) với ba mức low, medium, high.
- Mình đã chọn model cho từng vai: planner, executor, reviewer chính, reviewer thứ hai thuộc họ model khác, router, và model local nếu cần.
- Mình đã liệt kê 20 task đã đóng cho bộ đánh giá của riêng mình.
- Mình biết Claude Code và Codex đọc những file chỉ dẫn và file cấu hình nào trong repo này.
agentic-shortlinkđã được clone vàpnpm checkhiển thịTests 13 passed (13).
Trong series này
- Kiến trúc workflow với AI agent và chọn model theo vai
- Cấu hình repo cho Claude Code và Codex
- Spec, plan, task
- Chạy song song và nhiều provider
- CI/CD với AI review
- Vận hành: chi phí, bảo mật, học hỏi
- Phần 7: Áp dụng quy trình agent vào một dự án thật
Bài này thuộc series Làm phần mềm với AI agent từ A đến Z. Toàn bộ code nằm trong repo mẫu github.com/luonghongthuan/agentic-shortlink; hãy clone về và làm theo.
Bài viết liên quan
· 20 phút đọc
agentic coding
Phần 7: Áp dụng quy trình agent vào một dự án thật
Mình đem quy trình của series vào LingoLive AI, một repo đang chạy thật, bằng tool agent-repo-setup: audit, apply, verify trong sáu bước. Có hai bất ngờ: merge vào main là deploy production, và security review tìm ra ba lỗ trong chính các hook.
Đọc tiếp· 26 phút đọc
agentic coding
Phần 6/6: Vận hành: chi phí, bảo mật, vòng học và đo hiệu quả
Phần cuối của series: tiền agent đi đâu và cách đặt trần, bảng mối đe dọa ánh xạ tới từng file trong repo, vòng học biến mỗi lần sửa sai thành quy tắc, skill, hook hoặc test, năm chỉ số đo hiệu quả, và bài tập hoàn thành spec 0002 từ đầu đến cuối.
Đọc tiếp· 29 phút đọc
agentic coding
Phần 5/6: CI/CD với AI review trên GitHub Actions
Đưa quyết định merge lên GitHub Actions theo thứ tự cố định: CI tất định trước, AI review từ Claude và Codex sau, con người duyệt cuối. Giải thích từng file workflow, branch protection, ghim action theo SHA, các bẫy bảo mật và cách bật trên bản fork.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.