Ý TƯỞNG, QUYẾT ĐỊNH & BÀI HỌC

Bài viết

Ghi chép về AI, kiến trúc và xây dựng sản phẩm từ thực tế.

89 bài viết

07 Sep 2026 · 6 phút đọc

ai

NVIDIA Nemotron 3 Ultra: Kiến trúc lai Mamba-Transformer MoE mang lại gì thực sự cho production

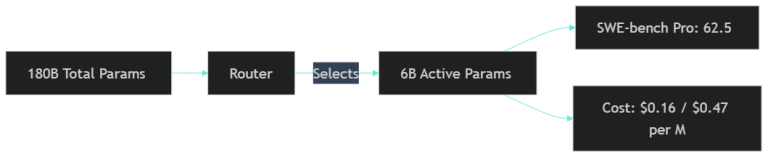
Nemotron 3 Ultra kết hợp các lớp Mamba (state-space) với attention của transformer và một bộ định tuyến mixture-of-experts để đạt context 1 triệu token với throughput gấp 5 lần các mô hình dense tương đương. Góc nhìn Tech Lead về kiến trúc này và nơi nó thay đổi bài toán chi phí triển khai agent.

Đọc tiếp
04 Sep 2026 · 6 phút đọc

agentic coding

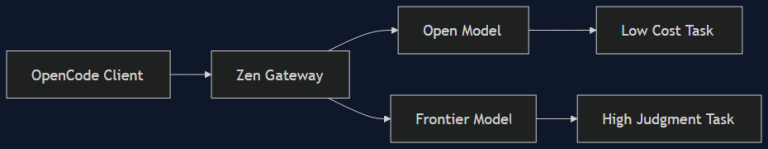
OpenCode Đạt 170K+ Sao Bằng Cách Không Chọn Model Sẵn — Điều Đó Nghĩa Là Gì Cho Ngân Sách Agent Của Bạn

OpenCode, coding agent chạy terminal mã nguồn mở, tăng trưởng vượt 170,000 GitHub star bằng cách giữ tính model-agnostic và kiếm tiền qua Zen, một gateway inference gần như không markup. Phân tích của một Tech Lead về kinh tế học bring-your-own-model, và khi nào nó thực sự thắng một gói subscription coding agent một vendor duy nhất.

Đọc tiếp

03 Sep 2026 · 6 phút đọc

ai

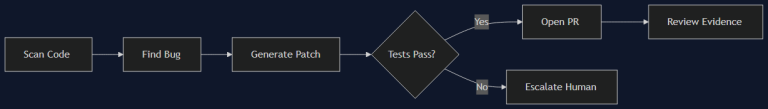
Gemini 3.8 Flash Cyber: Khi Vulnerability Scanner Cũng Tự Viết Patch

Google tách Gemini 3.8 Flash thành một bản workhorse tổng quát và một biến thể Cyber được gate quyền truy cập, tự tìm lỗ hổng và viết patch. Góc nhìn Tech Lead về việc điều gì thay đổi khi cùng một model làm cả discovery lẫn remediation — và vì sao bước review patch giờ mới là bottleneck thật sự.

Đọc tiếp

30 Aug 2026 · 5 phút đọc

ai-tools

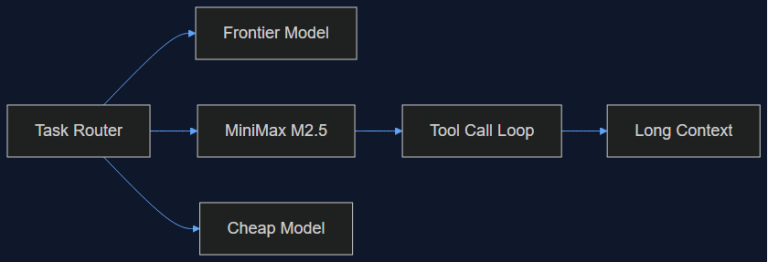
Núm Vặn Thinking-Effort Mới Của GitHub Copilot: Quản Lý Chi Phí và Độ Trễ Theo Từng Task

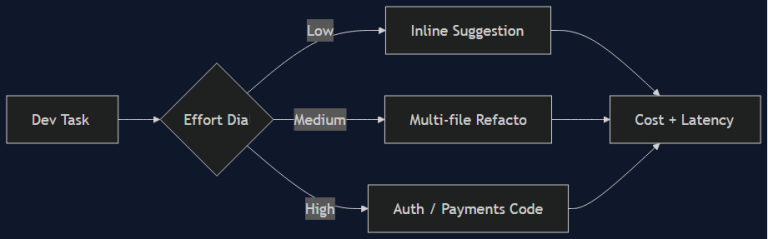
Bản cập nhật Visual Studio ngày 28/8 của GitHub thêm điều khiển thinking-effort Low/Medium/High theo từng model, cộng view quản lý model hiển thị context window và chi phí. Góc nhìn Tech Lead: vì sao tinh chỉnh effort theo từng call quan trọng hơn chọn 'model tốt nhất' — và so sánh với cái bẫy reasoning-effort chúng ta đã học một cách đau đớn với open model.

Đọc tiếp

30 Aug 2026 · 6 phút đọc

ai

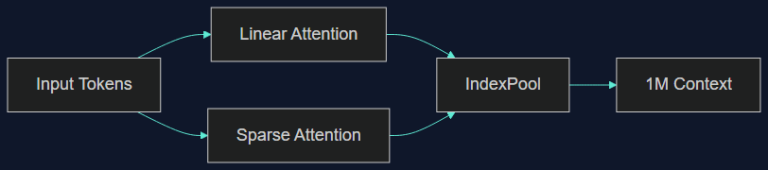
GLM-5.3-Flash: Model Open-Weight Đầu Tiên Tôi Thực Sự Tin Tưởng Với Context 1 Triệu Token

GLM-5.3-Flash của Z.ai, license MIT, kết hợp MoE 320B-A18B với cơ chế attention lai linear/sparse được thiết kế riêng để context triệu token thực sự dùng được, không chỉ khả dụng trên giấy. Góc nhìn Technical Lead về IndexPool, bài toán tự host, và vị trí của nó cạnh các model frontier đóng.

Đọc tiếp