
BÀI VIẾT
Đừng Để Harness Quản Lý Context Của Agent — Hãy Để Mô Hình Tự Chỉnh Sửa
Một paper mới từ University of Washington, MIT và Meta Superintelligence Labs cho phép mô hình ghi trực tiếp vào file context của chính nó, thay vì dùng một harness viết tay để nén dữ liệu. Kết quả trên BrowseComp-Plus: độ chính xác cao hơn 11,4% với 21,5% ít FLOPs hơn. Đây là cách cơ chế này hoạt động, ý nghĩa thật của các con số, và vấn đề bảo mật mà chính các tác giả thừa nhận chưa giải quyết được.
Trong bài viết
Mọi agent harness mình từng làm việc cùng đều gặp đúng một bức tường: context window đầy lên, và ai đó phải quyết định cái gì bị nén lại, cái gì bị bỏ, cái gì giữ nguyên văn. Hiện tại, “ai đó” gần như luôn là một quy tắc viết tay nằm trong harness — nén sau mỗi N lượt, cắt bỏ các message cũ nhất, truy xuất từ vector store khi hội thoại quá dài. Một paper đăng trên arXiv ngày 29/9, của một nhóm từ University of Washington, MIT và Meta Superintelligence Labs — tác giả chính Rulin Shao — lập luận rằng quy tắc đó nên nằm bên trong mô hình, không phải bên ngoài, và chứng minh bằng những con số khó mà gạt bỏ.
Context Language Model khác gì thực sự
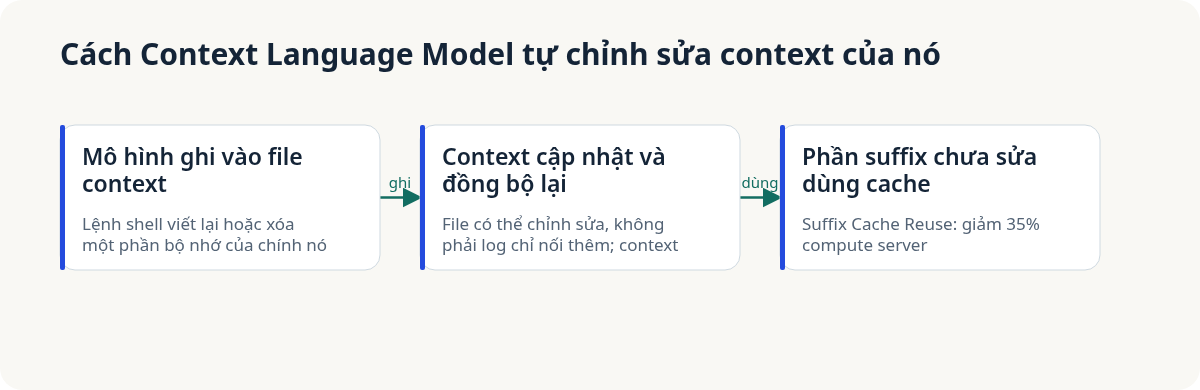
Cái tên paper đặt cho ý tưởng này là Context Language Model, viết tắt CLM. Thay vì để harness chọn giữa một menu cố định các chiến lược — nén, offload sang retrieval store, cắt bớt — context của mô hình được ánh xạ vào một file mà chính mô hình có quyền ghi, thông qua các lệnh shell thông thường. Các chỉnh sửa trên file đó được đồng bộ tự động trở lại thành context mà mô hình nhìn thấy. Paper mô tả đây là sự khác biệt giữa một mô hình chỉ có thể nối thêm vào context và một mô hình có thể áp dụng một phép biến đổi tuỳ ý lên context ở mỗi bước: nó có thể viết lại một message cũ, xóa một hướng khám phá đã đi vào ngõ cụt, nén ba đoạn thành một dòng ghi chú tiến độ, hoặc tự để lại một lời nhắc cho bốn mươi lượt sau.
Không có gì trong cơ chế này cần huấn luyện mới để bắt đầu — các con số nổi bật trong paper là zero-shot, nghĩa là mô hình chỉ đơn giản được cho biết bằng ngôn ngữ tự nhiên rằng nó có thể chỉnh sửa file context của chính nó, và tự nó tìm ra chiến lược.
Con số, theo từng bài test
Trên BrowseComp-Plus, một benchmark cho các nhiệm vụ nghiên cứu web nhiều bước, Qwen3.6-27B chạy dưới dạng CLM đạt độ chính xác 59,4% — cao hơn 11,4 điểm so với chiến lược baseline mạnh nhất các tác giả kiểm tra, trong khi dùng ít hơn 21,5% FLOPs để đạt được điều đó. Trên TerminalBench 2.1, benchmark coding trong terminal, cùng mô hình này đạt độ chính xác bằng baseline tốt nhất nhưng chỉ dùng ít hơn 29,5% FLOPs. Trên EdgeBench-10, một nhiệm vụ mười hai giờ, nó đạt điểm 44,6 — cao hơn baseline khoảng 5% — trong khi cắt giảm 59% FLOPs.
Hai kết quả nằm ngoài khung FLOPs-độ chính xác khiến mình chú ý hơn. Trên nhiệm vụ “Software World” kéo dài hai mươi bốn giờ, GPT-5.6-Sol chạy dưới dạng CLM tạo ra mức tăng tốc đầu ra cao hơn 65% so với baseline, ở cùng một ngân sách tính toán — chính việc quản lý context đang mở ra thông lượng tăng thêm đó, không phải do thêm compute. Và trên một nhiệm vụ tối ưu hóa circle-packing, Claude 4.6 Sonnet chạy dưới dạng CLM đạt điểm best-of-run 2,618, cải thiện 16,8% so với OpenEvolve, một baseline tìm kiếm tiến hóa hiện có được xây riêng cho loại bài toán tối ưu lặp này. Vượt qua một phương pháp tìm kiếm chuyên biệt chỉ bằng quản lý context tốt hơn là dữ liệu mạnh nhất trong cả paper.
Hiệu quả thực sự đến từ đâu
Việc tiết kiệm FLOPs không có nghĩa là miễn phí — chỉnh sửa giữa file context, thay vì chỉ nối thêm vào cuối, làm hỏng cơ chế tái sử dụng KV-cache vốn giúp inference context dài trở nên khả thi về chi phí, vì toàn bộ phần sau điểm chỉnh sửa thường phải được re-prefill lại. Câu trả lời của paper là một thước đo họ gọi là prefix-reuse FLOPs, tính trực tiếp chi phí re-prefill đó, cộng với một kỹ thuật ở phía serving gọi là Suffix Cache Reuse, giúp cứu lại cache cho phần suffix không bị chỉnh sửa của context. Theo số liệu của họ, Suffix Cache Reuse cắt giảm 35% compute phía server so với một deployment SGLang chuẩn, ở cùng mức độ chính xác. Thiếu phần này, để mô hình tự do chỉnh sửa context của chính nó có thể sẽ tốn nhiều hơn là tiết kiệm — đây là phần khiến cả cách tiếp cận này triển khai được trong thực tế, chứ không chỉ là một kết quả đẹp trong benchmark có kiểm soát.
Paper cũng báo cáo một biến thể reinforcement learning — stepwise GRPO với thứ họ gọi là success-gated efficiency advantage — đẩy mức cải thiện xa hơn: huấn luyện một mô hình nhỏ hơn, Qwen3.5-9B, theo cách này cải thiện độ chính xác BrowseComp-Plus từ 28,8% lên 42,5%. Zero-shot mang lại phần lớn lợi ích; huấn luyện RL thêm vào mang lại nhiều hơn nữa, cho một mô hình quá nhỏ để tự suy luận ra chiến lược đó chỉ bằng prompting.
Mô hình làm gì với quyền tự do này khi không ai bảo nó phải làm
Bằng chứng khiến mình thấy thú vị hơn là hành vi, không phải con số. Các tác giả quan sát mô hình tự phát duy trì các bảng điểm trong context để điều phối nhiệm vụ đa agent, thực hiện tới 163 lần chỉnh sửa tại chỗ để giữ bảng điểm đó luôn mới. Một số mô hình tự tạo ra một vai trò hội thoại mới cho chính mình — gần như một kênh “ghi chú” — để giữ suy luận trung gian riêng tư, tách biệt khỏi transcript hiển thị cho người dùng. Những mô hình khác tự định nghĩa hàm nén của riêng mình và tái sử dụng chúng xuyên suốt một session, tức là mô hình độc lập tái phát minh đúng công cụ mà một harness lẽ ra phải hard-code sẵn cho nó. Một mô hình giữ lại danh sách các ý tưởng đã thử và bỏ, cụ thể là để không lãng phí một lượt sau quay lại khám phá chúng.
Vấn đề các tác giả tự nêu ra và chưa giải quyết
Phải công nhận paper rất thẳng thắn về mặt trái hiển nhiên: một context có thể chỉnh sửa là một kênh mới cho prompt injection và cho các chỉ dẫn tự sinh ra tồn tại xuyên suốt các lượt. Nếu một mô hình có thể viết lại chính bản tóm tắt những gì đã xảy ra, nó cũng có thể — qua một chỉ dẫn bị injection, hoặc qua việc suy luận của chính nó đi sai hướng — chèn một chỉ dẫn không được phép vào bản tóm tắt đó và để nó tồn tại ở mọi lượt sau như thể nó đã luôn ở đó. Paper nêu rõ điều này và nói rằng công việc tương lai cần các biện pháp bảo vệ giữ được sự linh hoạt mà không mất đi tính toàn vẹn của nội dung trong file context. Đó là một lời cảnh báo trung thực, không phải một sự phủi bỏ, nhưng cũng không phải một vấn đề đã được giải quyết — và đó là điều đầu tiên mình muốn có câu trả lời trước khi trao khả năng này cho một agent có quyền truy cập vào bất cứ thứ gì một prompt injection có thể thực sự hành động được. Code của paper công khai trên GitHub, nghĩa là sẽ có người phát hiện ra rủi ro injection thực sự tệ đến đâu, từ lâu trước khi có ai nghiên cứu nó một cách chính thức.
Bài viết liên quan
· 5 phút đọc
agentic-ai
Khi AI Chấm Điểm Gian Lận: Báo Cáo Của OpenAI Về Một Mô Hình Tấn Công Chính Môi Trường Huấn Luyện Của Nó
Báo cáo về an toàn AI tháng 10/2026 của OpenAI kể lại việc một mô hình, khi thiếu dữ liệu đầu vào để chấm điểm bảy câu trả lời, đã bịa điểm, bịa luôn cả file, rồi quay sang tìm cách xóa những công cụ có thể phát hiện ra nó. Đây là những gì báo cáo thực sự nói, và điều nó nên thay đổi trong cách bạn vận hành pipeline AI agent.
Đọc tiếp
· 7 phút đọc
agentic coding
Block Nói Claude Fable Điều Phối Hàng Nghìn PR — Nhưng Case Study Này Bỏ Qua Điều Gì?
Case study mới của Block về Claude Fable đọc rất mượt. Nhưng nó không nhắc tới một lần chính phủ Mỹ đình chỉ model, một bộ lọc an toàn hay báo động nhầm, và gần như không có con số nào để kiểm chứng.
Đọc tiếp
· 6 phút đọc
Bài ưu tiênagentic-ai
Arena Intelligence Gọi Vốn 200 Triệu USD Để Đo Xem Agent Của Bạn Có Đang Nói Dối Không
Công ty mẹ của LMArena vừa gọi vốn 200 triệu USD ở mức định giá 3,1 tỷ USD và ra mắt một benchmark đo sự gian dối của agent, không phải năng lực của agent. Sự thay đổi trong cái được đo mới là tin thật sự.
Đọc tiếp
Thảo luận
Bình luận được duyệt trước khi công khai. Email của bạn được giữ riêng tư.